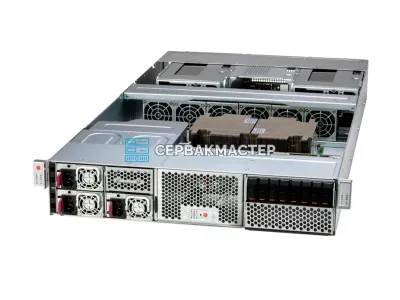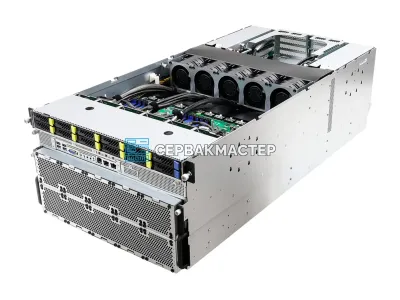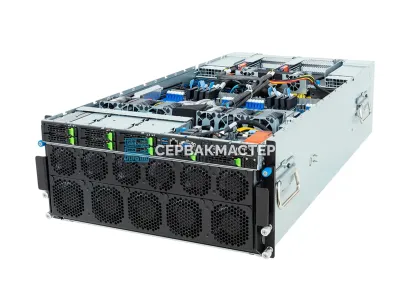
Нет в наличии
- ТипНовые
- Основная задачаОбучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC)
- Процессор (CPU)AMD EPYC
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
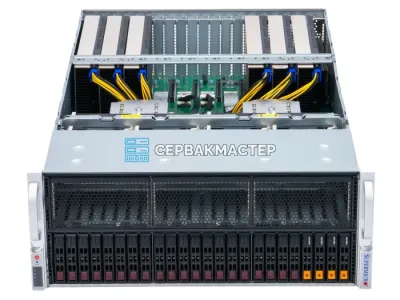
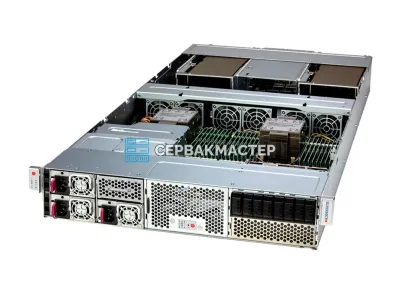
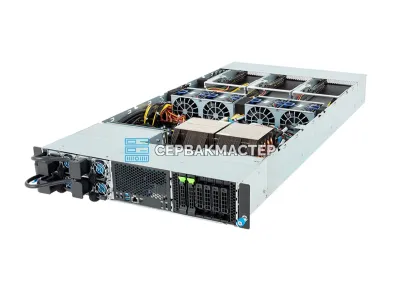
Ускоритель NVIDIA H100 — эталонное решение для организаций, которым необходима максимальная вычислительная мощность при обучении крупных языковых моделей, проведении научных расчётов и развёртывании генеративного ИИ в промышленной эксплуатации. В каталоге «СервакМастер» собраны готовые конфигурации с одним и несколькими ускорителями H100, прошедшие заводскую проверку и готовые к установке в дата-центр любого масштаба.
H100 построен на микроархитектуре Hopper (ядро GH100, техпроцесс TSMC 4N) и превосходит предыдущее поколение A100 по ключевым показателям: прирост производительности при инференсе достигает 30×, при обучении моделей — до 9×. Такой скачок стал возможен благодаря нескольким ключевым нововведениям:
Ускоритель выпускается в двух конструктивных исполнениях — SXM5 для многопроцессорных узлов с NVLink Switch и PCIe для стандартных серверных платформ.
| Параметр | H100 SXM5 | H100 PCIe |
|---|---|---|
| Архитектура | Hopper (GH100) | Hopper (GH100) |
| Тензорная производительность FP8 | 3958 TFLOPS | 1979 TFLOPS |
| Производительность FP64 | 34 TFLOPS | 26 TFLOPS |
| Объём памяти HBM3 | 80 ГБ | 80 ГБ |
| Пропускная способность памяти | 3,35 ТБ/с | 2,0 ТБ/с |
| Интерфейс NVLink 4.0 | 900 ГБ/с | — |
| Поддержка MIG | до 7 экземпляров | до 7 экземпляров |
| TDP | 700 Вт | 350 Вт |
| Техпроцесс | TSMC 4N | TSMC 4N |
Восемь ускорителей H100 SXM5 в одном узле суммируют 640 ГБ когерентной памяти HBM3 через NVLink 4.0. Это позволяет вести полноценное обучение моделей с числом параметров свыше 70 миллиардов без разбивки задачи на несколько физических серверов. Transformer Engine с режимом FP8 дополнительно ускоряет обработку каждого батча и снижает энергопотребление по сравнению с форматами FP16 и BF16.
H100 минимизирует задержки при обработке запросов к языковым и мультимодальным моделям. Это критично для производственных систем, где от скорости ответа зависит пользовательский опыт: чат-боты, помощники по написанию кода, системы поиска с семантическим ранжированием.
Производительность FP64 на уровне 34 TFLOPS делает H100 SXM5 востребованным инструментом в молекулярной динамике, вычислительной химии, климатическом моделировании и симуляции физических процессов. Высокая пропускная способность памяти обеспечивает работу с объёмными наборами данных без узких мест на уровне чтения/записи.
Пропускная способность памяти 3,35 ТБ/с позволяет одновременно обрабатывать десятки видеопотоков в разрешении 4K в режиме реального времени. Серверы с несколькими H100 применяются в системах городского наблюдения, промышленного контроля качества и медицинской диагностики изображений.
Аппаратная изоляция MIG даёт провайдерам облачных услуг возможность предоставлять разным клиентам гарантированные ресурсы GPU с чётко разграниченной памятью и вычислительными ядрами — без риска взаимного влияния рабочих нагрузок.
Стоимость GPU-сервера с NVIDIA H100 зависит от выбранной платформы, количества ускорителей и комплектации. Базовая цена актуальной конфигурации указана на странице. Для расчёта стоимости под конкретный проект обратитесь к специалистам «СервакМастер» — подготовим индивидуальное предложение в кратчайшие сроки.