
HPE Cray XD670 Gen11 (8× H100 SXM 80GB) — GPU-сервер для обучения и инференса LLM



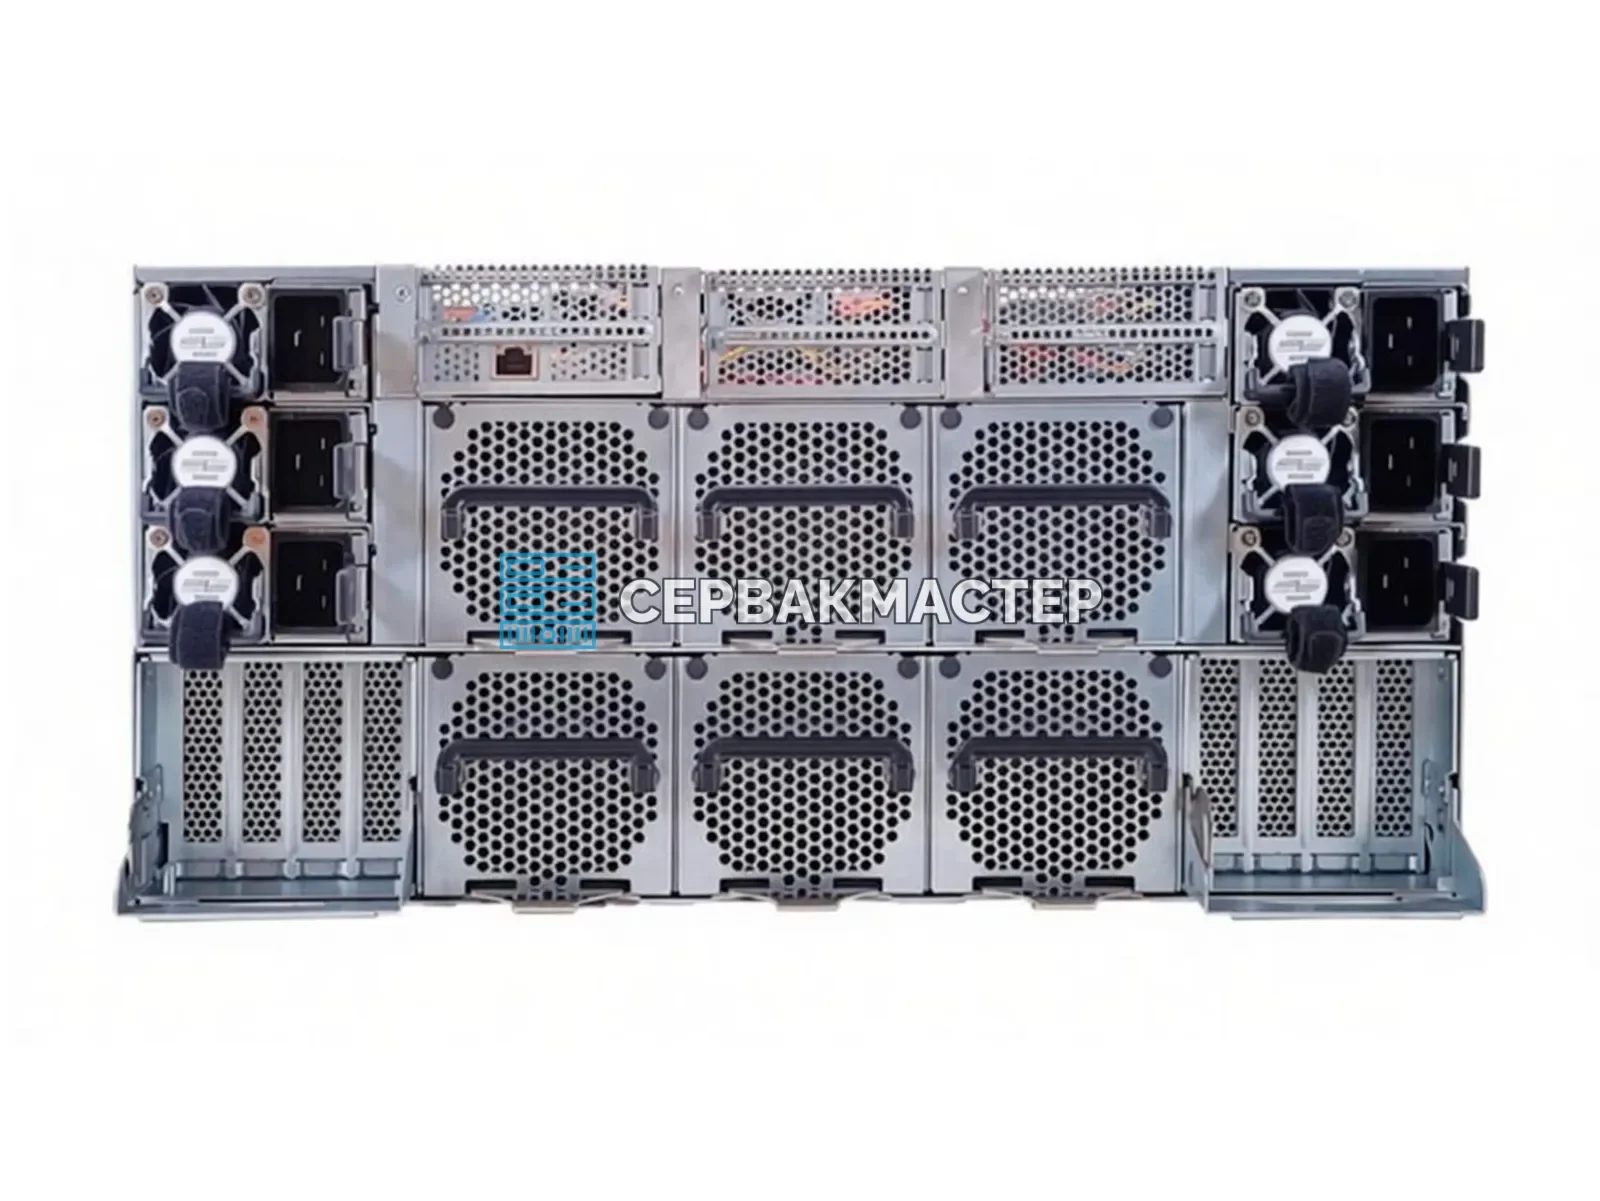
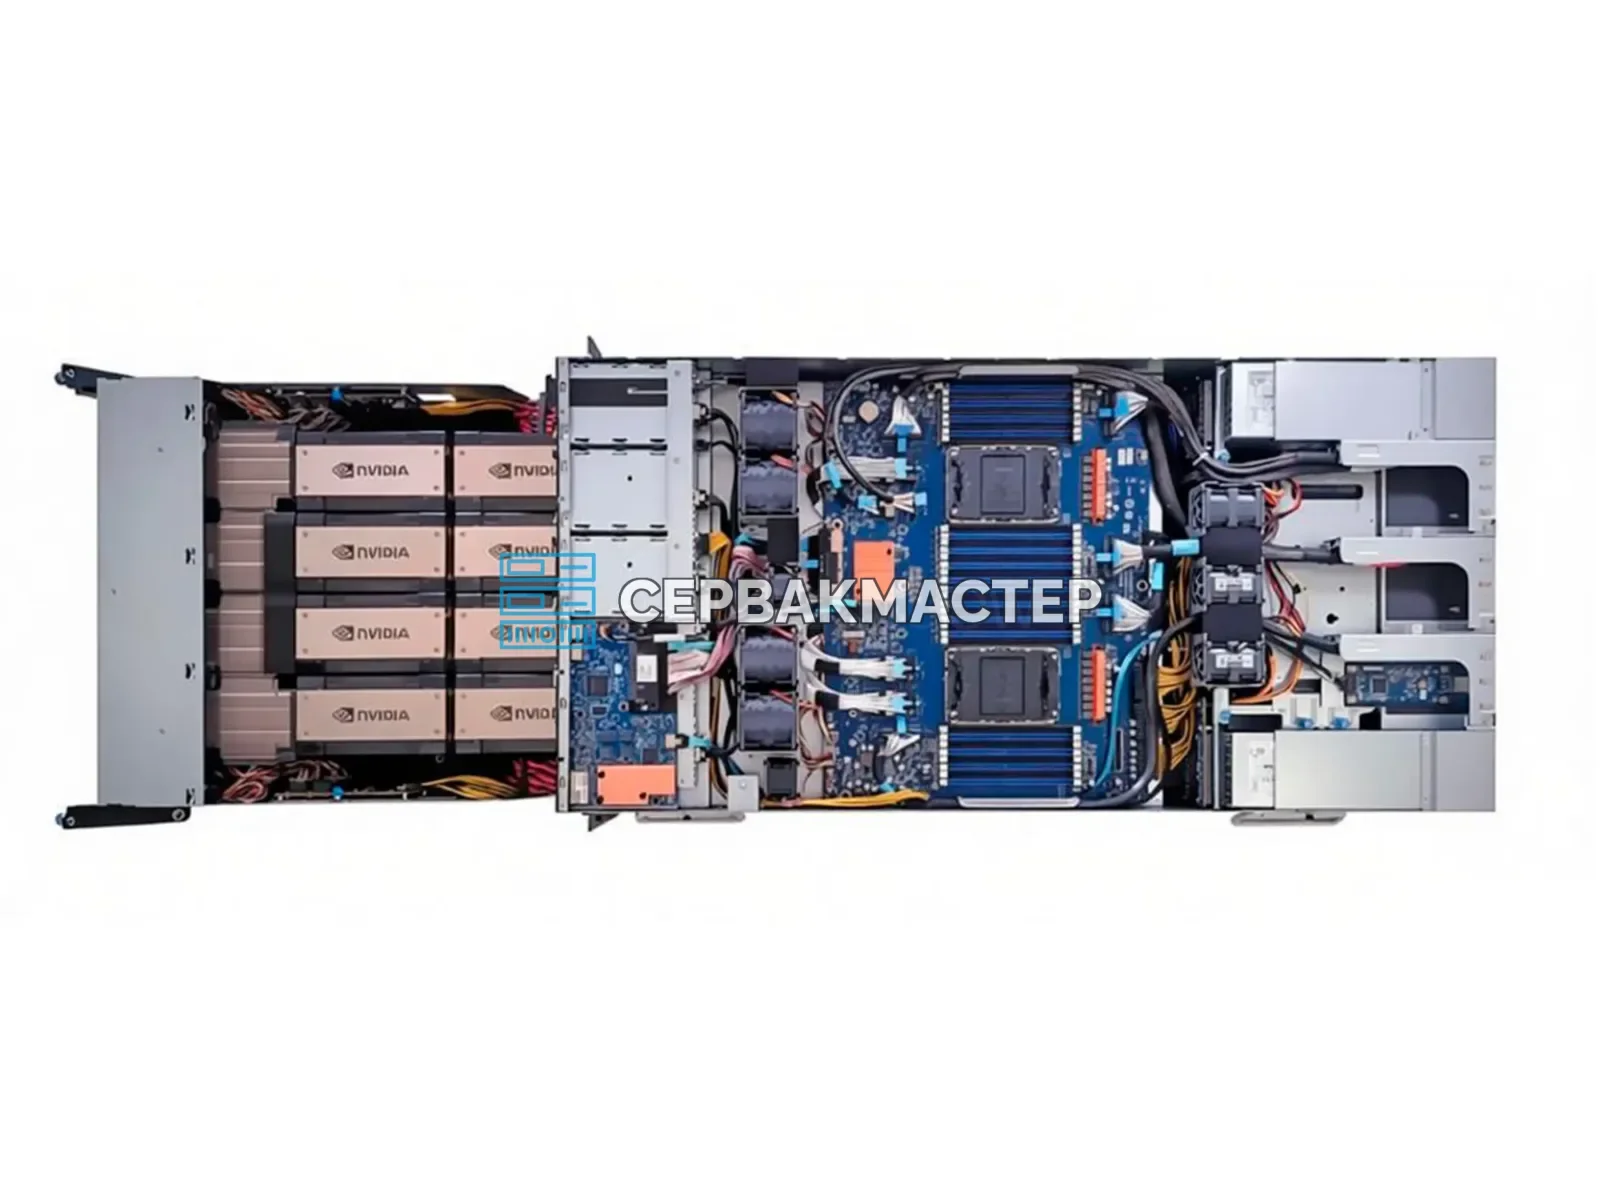
HPE Cray XD670 Gen11 — восемь H100 в одном узле
HPE Cray XD670 Gen11 — это плотная GPU-платформа для тех, кому нужна производительность уровня небольшого кластера в одном шасси. Внутри восемь ускорителей NVIDIA H100 SXM по 80 ГБ HBM3, что даёт 640 ГБ общей видеопамяти. Такой объём позволяет обучать и дообучать крупные модели, а также держать в памяти современные LLM с большим контекстом.
Сервер рассчитан на длительную высокую нагрузку: масштабирование на 8 GPU, большие батчи и параллельные запросы. По охлаждению доступны варианты с воздушным контуром и опциональным прямым жидкостным охлаждением (DLC), что удобно для плотных стоек.
Ключевые особенности
- 8× NVIDIA H100 SXM 80GB HBM3 — 640 ГБ видеопамяти на узел.
- Архитектура Hopper с ускорением FP16, FP8 и INT8; заявлена поддержка Transformer Engine.
- Два процессора Intel Xeon Scalable 4-го поколения (Sapphire Rapids).
- До 4 ТБ оперативной памяти DDR5 ECC RDIMM, 32 DIMM-слота (до 5600 MT/s).
- До 8× NVMe U.2/U.3 2.5" и 2× M.2 RAID SSD (Read-Intensive и Mixed-Use).
- Воздушное охлаждение или опциональное DLC.
- Одноузловое шасси для стойки, без необходимости собирать кластер из нескольких машин.
Характеристики
| Параметр | Значение |
|---|---|
| Состояние | Новое |
| GPU | 8× NVIDIA H100 SXM 80GB |
| Видеопамять | 640 ГБ HBM3 |
| Процессор | 2× Intel Xeon Scalable 4-го поколения |
| Оперативная память | до 4 ТБ DDR5 ECC RDIMM, 32 слота |
| Накопители | до 8× 2.5" NVMe U.2/U.3, 2× M.2 RAID SSD |
| Охлаждение | воздушное, опционально DLC |
| Форм-фактор | 6U (по данным каталога) |
| FP8 Tensor Core (8 GPU) | 31 664 TFLOPS |
| BF16 / FP16 Tensor Core (8 GPU) | 15 832 TFLOPS |
Для каких задач подходит
- Обучение и дообучение (fine-tuning) больших языковых моделей.
- Инференс и развёртывание LLM в продакшене с высокой параллельностью запросов.
- RAG-системы и агентные сценарии с длинным контекстом.
- Научные расчёты и HPC: совокупная мощность восьми H100 по FP64 Tensor Core составляет 536 TFLOPS.
- Генерация изображений и видео: Stable Diffusion XL, Kandinsky и аналоги, с масштабированием очередей по нескольким GPU.
По совместимости с LLM заявлены, в частности, DeepSeek-R1 685B в квантизации Q4_K_M (около 404 ГБ VRAM), Qwen3.5-397B-A17B в FP8 (около 406 ГБ), GigaChat3.5-432B-A28B (около 438 ГБ), GLM-5 в Q4_K_M (около 456 ГБ). Для стабильной работы стоит оставлять запас видеопамяти под KV-cache при длинном контексте и использовать tensor parallel на 8 GPU.
Состояние, проверка и поставка
Сервер поставляется новым. «СервакМастер» тестирует оборудование перед отправкой, предоставляет гарантию 1 год с заменой компонентов и организует доставку по России через СДЭК и другие ведущие службы. Если нужна конфигурация под ваши задачи и бюджет, свяжитесь с менеджером — мы подберём подходящий вариант на этой платформе.
Характеристики
| Тип | Новые |
| Основная задача | Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) |
| Процессор (CPU) | Intel Xeon |
| Видеокарта (GPU) | NVIDIA H100 |
| Количество GPU, шт | 8 |
| Общий объем видеопамяти (VRAM), ГБ | 640 |
| Тип памяти GPU | HBM3 |
| Объем оперативной памяти (RAM), ГБ | 4096 |
| Тип оперативной памяти | DDR5 ECC REG |
| Форм-фактор | 6U |