
Сервер DELL PowerEdge XE9680 (8× H100 SXM 80GB) для обучения и инференса ИИ

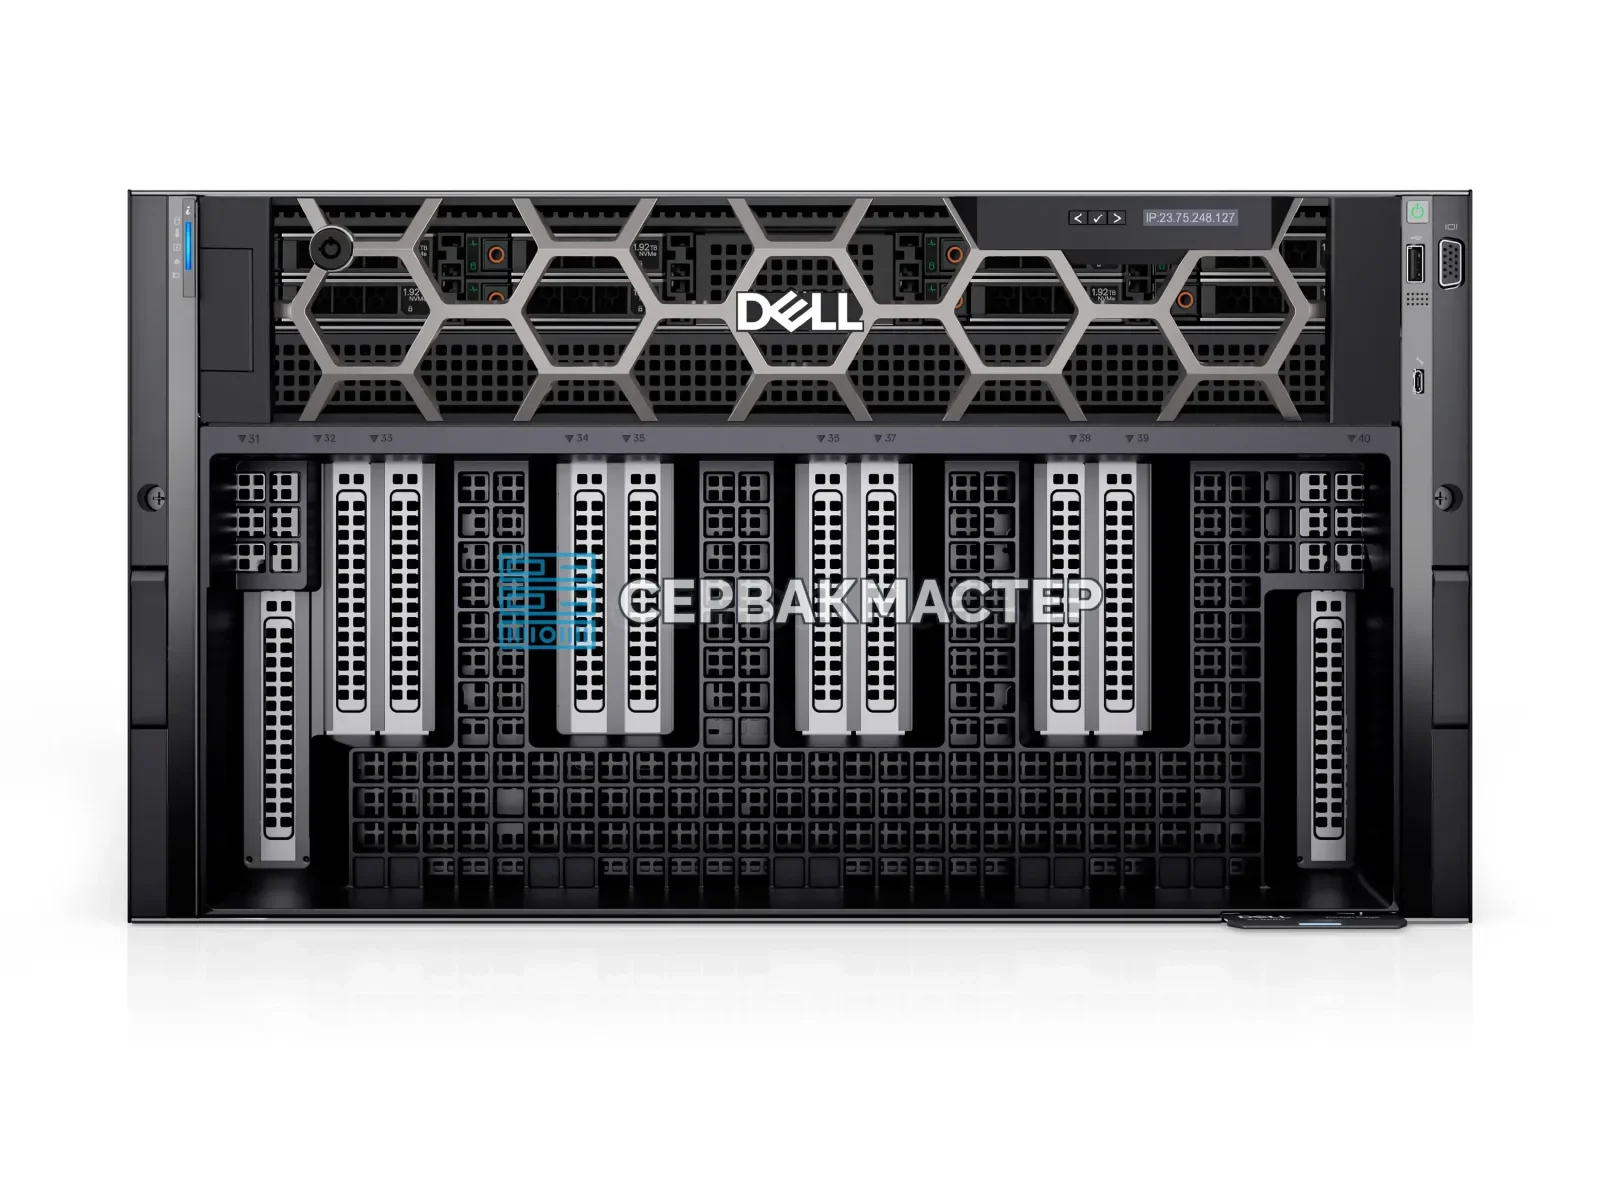


Обзор DELL PowerEdge XE9680 с восемью NVIDIA H100 SXM
DELL PowerEdge XE9680 в этой конфигурации построен на платформе NVIDIA HGX H100 80GB: восемь ускорителей в форм-факторе SXM5 объединены в одном шасси и работают как единый вычислительный узел. Суммарно сервер даёт 640 ГБ памяти HBM3, чего хватает для обучения, дообучения и развёртывания крупных языковых и мультимодальных моделей.
Архитектура Hopper с поддержкой FP16, FP8 и INT8 подходит и для тренировки, и для промышленного инференса. Большой запас видеопамяти оставляет место под KV-cache, длинный контекст и рост числа одновременных запросов. Для стабильной работы в продакшене обычно подбирают схему распараллеливания (TP/PP) и параметры батчей под конкретную модель.
Ключевые особенности
- 8× NVIDIA H100 SXM 80GB с памятью HBM3, всего 640 ГБ VRAM.
- Платформа HGX H100 8-GPU SXM5 с PCIe Gen5, рассчитанная на интенсивный обмен данными между GPU.
- Два процессора Intel Xeon Scalable 4-го или 5-го поколения (на 5-м поколении до 64 ядер и 350 Вт).
- До 4 ТБ оперативной памяти DDR5 ECC RDIMM, 32 слота.
- Варианты хранения: до 8× 2.5" NVMe/SAS/SATA либо до 16× E3.S NVMe, в обоих случаях до 122.88 ТБ.
- Совокупная производительность восьми GPU: 31 664 TFLOPS в FP8 Tensor Core, 15 832 TFLOPS в BF16/FP16, 7 912 TFLOPS в TF32, 536 TFLOPS в FP64 Tensor Core.
Характеристики
| Параметр | Значение |
|---|---|
| Состояние | Новое |
| Видеокарты | 8× NVIDIA H100 SXM 80GB |
| Тип памяти GPU | HBM3 |
| Общий объём VRAM | 640 ГБ |
| Платформа GPU | HGX H100 8-GPU SXM5, PCIe Gen5 |
| Процессоры | 2× Intel Xeon Scalable 4-го/5-го поколения |
| Оперативная память | до 4 ТБ DDR5 ECC RDIMM, 32 слота |
| Накопители | до 8× 2.5" NVMe/SAS/SATA или до 16× E3.S NVMe |
| Максимальный объём хранилища | до 122.88 ТБ |
| FP8 Tensor Core (8 GPU) | 31 664 TFLOPS |
Для каких задач подходит
Сервер рассчитан на обучение и дообучение моделей, инференс, RAG-системы, анализ данных и научные расчёты (HPC). По ориентировочным оценкам, в 640 ГБ VRAM помещаются квантизированные версии очень крупных LLM: например, DeepSeek-R1 685B в Q4_K_M требует около 404 ГБ, Mistral-Large-3 675B в Q4_K_M около 407 ГБ, Qwen3.5-397B-A17B в FP8 около 406 ГБ. Модели меньшего размера, такие как gpt-oss:120b (около 196 ГБ), можно запускать на 2-4 GPU и оставить остальные ускорители под другие задачи.
Платформа подходит и для диффузионных моделей: SDXL, SD Turbo и Kandinsky 5.0 работают с высокими разрешениями и крупными батчами, а генерацию удобно распараллеливать по GPU. Для Flux.2-dev обычно требуется multi-GPU или offload, итог зависит от пайплайна.
Состояние, проверка и поставка
Сервер поставляется новым. Перед отправкой «СервакМастер» тестирует оборудование, на него действует гарантия 1 год с заменой компонентов. Доставка выполняется по России СДЭК и другими ведущими службами. Если нужна конфигурация под ваши задачи и бюджет, свяжитесь с менеджером, и мы предложим подходящий вариант.
Характеристики
| Тип | Новые |
| Основная задача | Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) |
| Процессор (CPU) | Intel Xeon |
| Видеокарта (GPU) | NVIDIA H100 |
| Количество GPU, шт | 8 |
| Общий объем видеопамяти (VRAM), ГБ | 640 |
| Тип памяти GPU | HBM3 |