Нет в наличии
- ТипНовые
- Основная задачаИнференс / Дообучение моделей / RAG-системы / Анализ данных / Визуализация и рендеринг
- Процессор (CPU)AMD EPYC
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Магазин «СервакМастер» специализируется на подборе и поставке серверных платформ для запуска открытых языковых моделей семейства GPT-OSS. Мы помогаем компаниям выстроить собственную AI-инфраструктуру без привязки к внешним облачным API — с полным контролем над данными, предсказуемыми расходами и возможностью тонкой настройки моделей под конкретные задачи.
GPT-OSS (Open Source Series) — открытые языковые модели с публично доступными весами, которые разворачиваются на собственном железе. Локальный инференс принципиально отличается от работы через коммерческие API:
Вместе с тем большие языковые модели (7B–70B+ параметров) предъявляют жёсткие требования к объёму видеопамяти и пропускной способности шины. Универсальные серверы общего назначения плохо справляются с этими задачами — нужны платформы, спроектированные именно для AI-нагрузок.
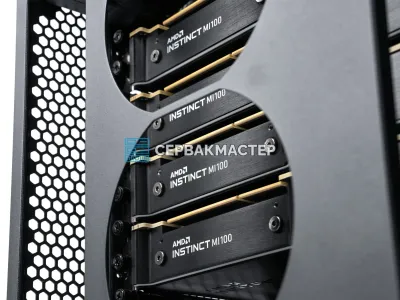
Серверы в ассортименте «СервакМастер» комплектуются ускорителями высокой плотности памяти:
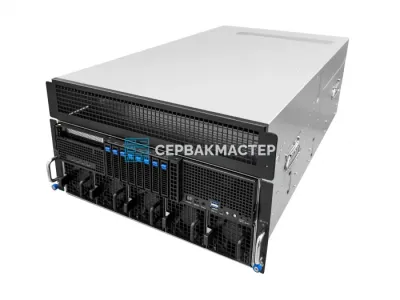
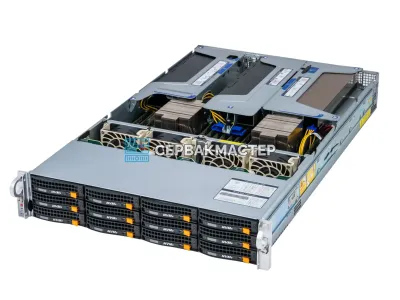
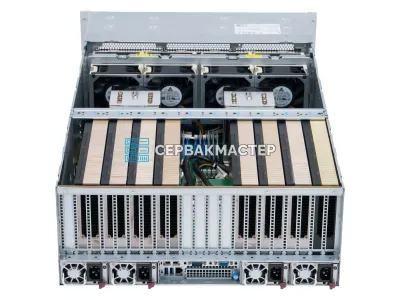
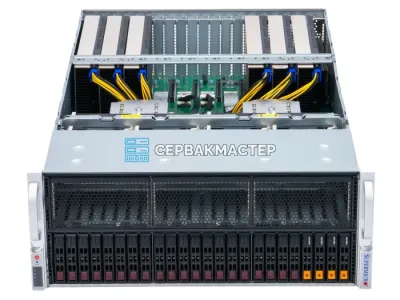
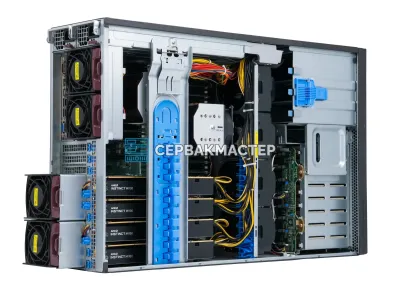
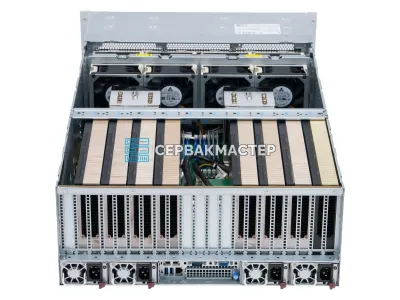
| Платформа | Ускорители | Суммарная память GPU | Цена |
|---|---|---|---|
| Supermicro AS-4125GS-TNRT | 8× A100 80 GB | 640 ГБ | от 1 718 800 руб. |
| Dell PowerEdge XE9680 | 8× H100 SXM5 | 640 ГБ | по запросу |
| ASUS ESC N8-E11 | 8× A100 40 GB | 320 ГБ | по запросу |
| Supermicro SYS-821GE-TNHR | 8× H100 PCIe | 640 ГБ | по запросу |
Актуальное наличие и сроки поставки уточняйте у менеджеров «СервакМастер». Позиции со статусом «по запросу» доставляются в срок от 4 до 8 недель с момента подтверждения заказа.
Разверните LLM внутри инфраструктуры компании для автоматизации службы поддержки, генерации документов и суммаризации данных. Конфигурация на базе 2× A100 80 GB обеспечивает комфортный инференс Llama-3 70B для 50–100 одновременных пользователей с приемлемым временем отклика.
Связка embedding-модели и LLM позволяет построить интеллектуальный поиск по внутренним документам, регламентам и техническим руководствам. Платформа с 4 GPU перекрывает потребности среднего предприятия с контекстом в несколько миллионов токенов.
Серверы с NVLink-коммутатором объединяют видеопамять нескольких ускорителей в единое пространство, что обязательно при PEFT-адаптации моделей 30B–70B без разбиения на шарды. Это ускоряет цикл обучения и снижает сложность оркестрации.
Академические лаборатории и R&D-команды получают полную независимость от коммерческих API при работе с экспериментальными архитектурами, закрытыми датасетами и нестандартными режимами квантизации.
Свяжитесь с нами через форму на сайте или раздел «Контакты» — менеджеры ответят в течение рабочего дня.