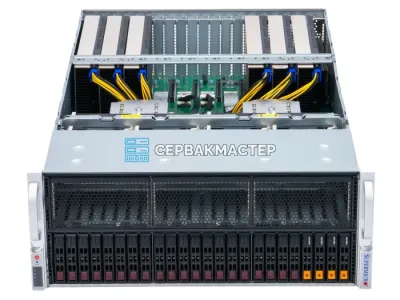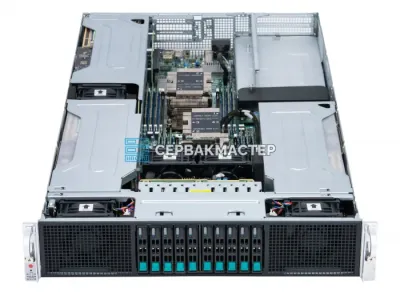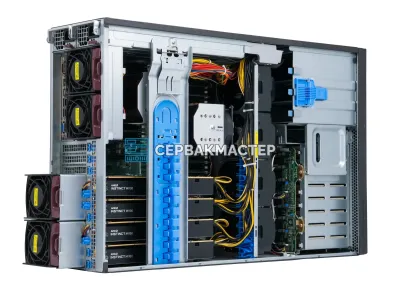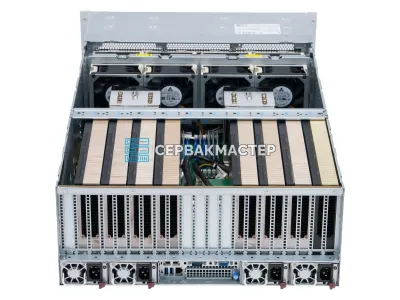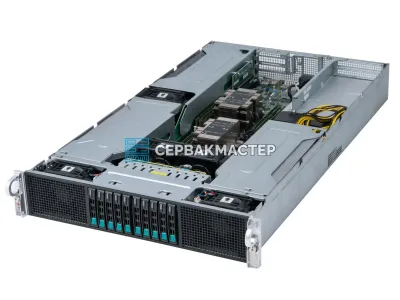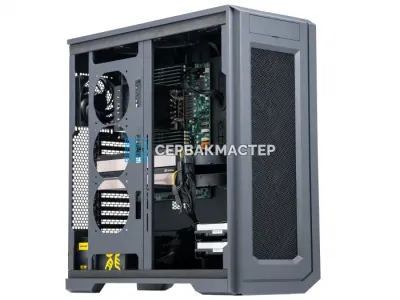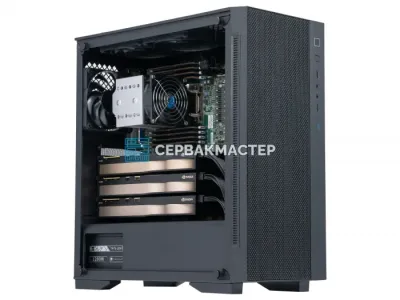
Нет в наличии
- ТипБ/У
- Основная задачаИнференс / Дообучение моделей / RAG-системы
- Процессор (CPU)AMD EPYC
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Kandinsky 5.0 — флагманская российская диффузионная нейросеть для генерации изображений по текстовым и мультимодальным запросам. Модель опирается на многошаговый диффузионный процесс в латентном пространстве и предъявляет жёсткие требования к вычислительной базе: высокая пропускная способность GPU, большой объём видеопамяти и быстрая подсистема хранения. В каталоге «СервакМастер» собраны конфигурации, прошедшие практическую проверку на AI-нагрузках именно этого класса.
Каждый шаг диффузионного сэмплирования — это интенсивные матричные вычисления над тензорами высокой размерности. При единичных запросах десктопная видеокарта ещё справляется, но при коммерческой эксплуатации с очередью от десятков до сотен одновременных пользователей стандартное оборудование не обеспечит ни стабильного времени отклика, ни бесперебойной работы 24/7.
Специализированный AI-сервер решает несколько задач сразу:
Оптимальна для пилотных проектов, внутреннего тестирования и небольших API с нагрузкой до 50–100 генераций в час:
Сбалансированное решение для платформ с умеренно-высоким трафиком и требованиями к SLA:
Для SaaS-платформ, корпоративных систем и исследовательских центров с максимальными требованиями к пропускной способности:
При генерации изображений разрешения 1024×1024 пикселей модель потребляет от 16 до 24 ГБ видеопамяти в зависимости от числа шагов диффузии и применяемого формата вычислений (FP16, BF16 или INT8-квантование). Для работы с батчами и оставления резерва под оркестрацию рекомендуются GPU с объёмом VRAM не менее 40 ГБ:
Большой объём системной памяти позволяет кешировать промпты, промежуточные латенты и результаты, сокращая дисковые обращения. Практический минимум — 256 ГБ; рекомендуемый объём для производственных систем — 512 ГБ и более. DDR5-4800 МГц снижает задержки при активном обмене данными между CPU и GPU по шине PCIe.
Быстрый доступ к диску критичен в трёх ситуациях:
Рекомендуемые характеристики NVMe-накопителя: последовательное чтение от 6 000 МБ/с, случайные IOPS от 1 000 000.
Одиночному серверу достаточно интерфейса 25 GbE. При построении многоузлового кластера для параллельного инференса или fine-tuning необходима низколатентная фабрика: InfiniBand HDR (200 Гбит/с) обеспечивает минимальные задержки при межузловой передаче активаций и градиентов.
Разместите Kandinsky 5.0 за Triton Inference Server или FastAPI-прокси и открывайте доступ через REST или gRPC. Конфигурация на 4× NVIDIA H100 позволяет стабильно обрабатывать от 500 до 2 000 запросов в час в зависимости от сложности промптов и числа шагов сэмплирования.
Компании интегрируют Kandinsky 5.0 в процессы создания маркетинговых материалов, иллюстраций к публикациям и прототипов дизайна. Собственный сервер гарантирует полный контроль над данными, соответствие требованиям ИБ и независимость от внешних облачных провайдеров.
Fine-tuning диффузионных моделей на корпоративных датасетах, эксперименты с архитектурой и дистилляция — задачи, для которых нужна не только мощная GPU, но и надёжная серверная платформа с возможностью длительной непрерывной работы.
Интеграция Kandinsky 5.0 с CMS, DAM-системами и рекламными платформами позволяет автоматически формировать уникальные визуальные активы для публикаций, e-commerce и таргетированной рекламы без участия дизайнера на рутинных задачах.
Поставляемые серверы готовы к развёртыванию типового AI-окружения. Рекомендуемый стек для Kandinsky 5.0:
По запросу инженеры «СервакМастер» проводят первичную настройку окружения и стресс-тест производительности перед отправкой.
Если вы не определились с конфигурацией — оставьте заявку или напишите нашим инженерам: они помогут подобрать оптимальное решение под конкретную нагрузку и бюджет.
«СервакМастер» — надёжный партнёр по построению инфраструктуры генеративного AI для российского рынка.