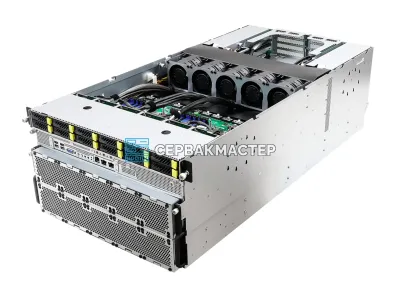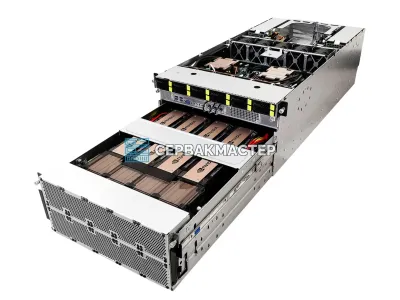
Нет в наличии
- ТипБ/У
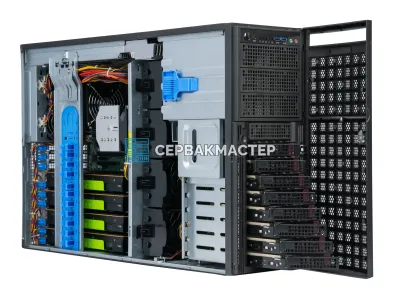
- Основная задачаИнференс / Дообучение моделей / RAG-системы
- Процессор (CPU)Intel Xeon E5-series
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Qwen 2 — серия больших языковых моделей от Alibaba Cloud с поддержкой русского и английского языков. Семейство охватывает конфигурации от 1,5 до 72 млрд параметров, включая мультимодальные варианты Qwen2-VL. Для промышленного запуска таких моделей требуется оборудование с достаточным объёмом видеопамяти, высокой пропускной способностью шины PCIe или NVLink и надёжным охлаждением GPU. В каталоге «СервакМастер» собраны готовые конфигурации стоечных AI-серверов, проверенных под рабочие нагрузки всей линейки Qwen 2.
Размер модели напрямую определяет требования к VRAM и межузловой связности. Ориентируйтесь на следующую градацию:
Неверно подобранный сервер приводит к перегреву GPU, деградации throughput и внеплановым простоям. Инженеры «СервакМастер» помогут с точным расчётом конфигурации под вашу целевую нагрузку.
Двухпроцессорная платформа на базе AMD EPYC 9004 с поддержкой до восьми GPU NVIDIA A100/H100 SXM. Оснащена NVLink4 для полносвязного объединения ускорителей, поддерживает до 6 ТБ DDR5 ECC RDIMM. Отличный выбор для развёртывания Qwen2-72B в промышленной среде с требованиями к высокой доступности.
Восьми-GPU сервер с фирменной системой прямого жидкостного охлаждения Dell Direct Liquid Cooling. Поддерживает NVIDIA H100 SXM5 80 ГБ, суммарная VRAM на узел — 640 ГБ. Совместим с NVIDIA NVSwitch: полносвязная топология между всеми восемью ускорителями без потери полосы. Предпочтительная платформа для корпоративного развёртывания Qwen2-72B и мультимодальных вариантов Qwen2-VL.
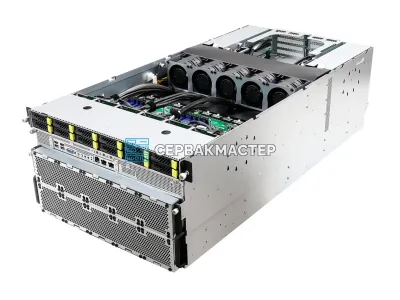
Серверная платформа 4U с поддержкой до восьми двухслотовых GPU. Процессоры AMD EPYC 9654 (96 ядер, Boost до 3,55 ГГц), 24 слота DDR5 RDIMM (до 3 ТБ). Встроенный BMC с IPMI 2.0 и Redfish API для удалённого управления. Хорошее соотношение цены и производительности для нагрузок среднего масштаба.
Готовые вычислительные узлы на базе NVIDIA HGX A100 4-GPU и HGX H100 8-GPU. Поставляются в проверенных конфигурациях с предустановленными ускорителями, кабелями NVLink и блоками питания. Оптимальны для быстрого ввода в эксплуатацию без дополнительной сборки и пусконаладки.
Квантизация позволяет снизить объём необходимой видеопамяти за счёт уменьшения разрядности весов модели:
| Точность | Примерный объём VRAM для Qwen2-72B | Деградация качества |
|---|---|---|
| FP32 | ~280 ГБ | отсутствует (референс) |
| BF16 / FP16 | ~144 ГБ | минимальная |
| GPTQ / AWQ 8-bit | ~72 ГБ | незначительная |
| GPTQ / AWQ 4-bit | ~36 ГБ | умеренная |
| GGUF Q4_K_M | ~26 ГБ | умеренная |
Для production-среды, где важно качество выходных данных, оптимальны BF16 или GPTQ 8-bit. Для edge-инсталляций с ограниченным бюджетом подойдёт 4-bit квантизация.
Все серверы из каталога «СервакМастер» работают с популярными решениями для развёртывания LLM:
Приобретая AI-сервер для Qwen 2 в «СервакМастер», вы получаете:
Для получения коммерческого предложения или технической консультации обращайтесь через форму обратной связи или контакты в разделе «Контакты».
«СервакМастер» специализируется на серверном и AI-оборудовании профессионального уровня. Мы работаем с корпоративными клиентами, исследовательскими центрами, облачными провайдерами и командами разработки AI-продуктов.