Нет в наличии
- ТипНовые
- Основная задачаОбучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC)
- Процессор (CPU)Intel Xeon
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
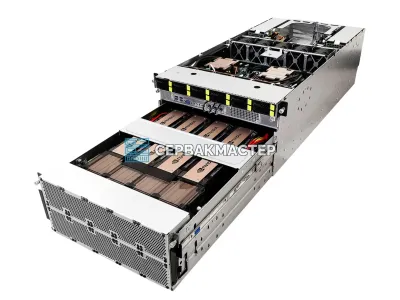
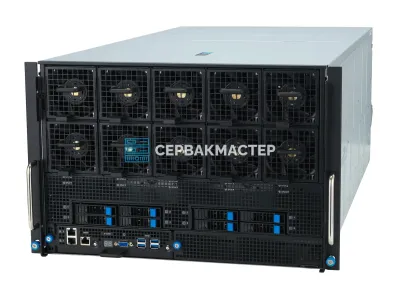
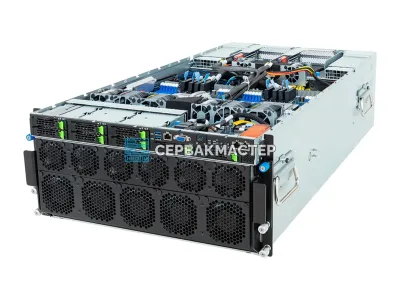
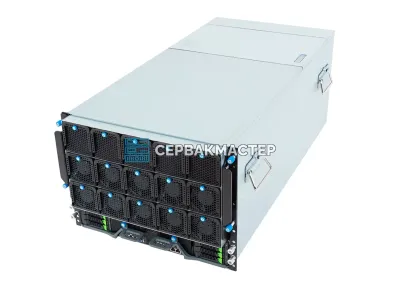
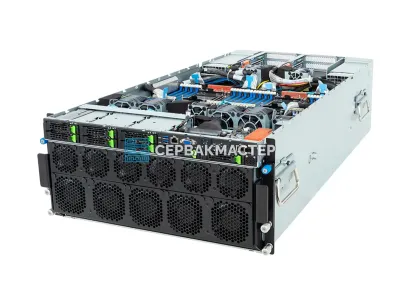
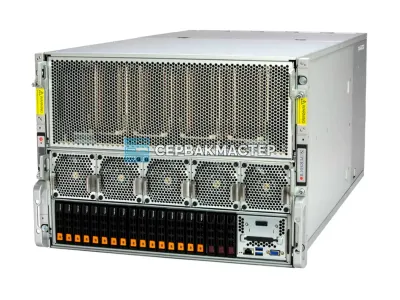
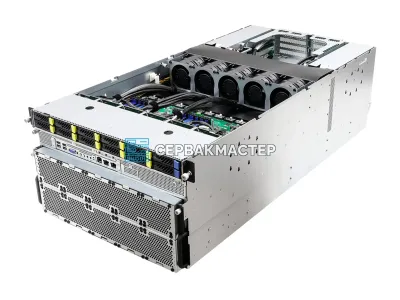
Серверы на базе платформы NVIDIA HGX H200 — это эталонное решение для организаций, работающих с самыми ресурсоёмкими задачами: обучением больших языковых моделей (LLM), генеративным ИИ, молекулярным моделированием и высокопроизводительными научными вычислениями. В каталоге СервакМастер представлены готовые конфигурации с ускорителями H200 SXM5 от ведущих производителей серверного оборудования — Supermicro, Dell и ASUS.
Ключевое достижение платформы H200 по сравнению с предшественником H100 — замена памяти HBM3 на HBM3e: объём на ускоритель вырос с 80 до 141 ГБ, а пропускная способность увеличилась с 3,35 до 4,8 ТБ/с. Именно это узкое место — объём и скорость памяти — чаще всего ограничивало эффективность работы с многомиллиардными параметрическими моделями, и H200 устраняет его в полной мере.
Базовая конфигурация сервера HGX H200 включает восемь ускорителей H200 SXM5, объединённых высокоскоростным интерконнектом:
141 ГБ HBM3e на ускоритель позволяет загружать в GPU-память модели с числом параметров от 70 млрд и выше без принудительного разбиения на шарды. Это напрямую сокращает время итерации при тренировке архитектур класса GPT-4, LLaMA 3, Mistral и других мощных LLM. Суммарный объём памяти системы 8×H200 превышает 1 ТБ — достаточно для работы с моделями, которые ещё год назад требовали целого вычислительного кластера.
Диффузионные модели для синтеза изображений, системы видеогенерации, мультимодальные ассистенты, работающие одновременно с текстом, аудио и видео, — все они выигрывают от высокой пропускной способности HBM3e и производительности Tensor Core в режимах FP8 и BF16. Увеличенная ёмкость памяти позволяет держать в GPU более крупные KV-кэши, что снижает задержку при параллельной обработке запросов.
Молекулярная динамика, квантовая химия, вычислительная гидродинамика (CFD), климатическое и геофизическое моделирование — задачи, где критически важна двойная точность FP64. Производительность H200 в режиме FP64 составляет 34 ТФЛОПС на ускоритель, что сохраняет позиции платформы в традиционном HPC-сегменте наряду с ИИ-задачами.
При обслуживании тысяч пользовательских запросов в секунду к большим языковым моделям размер GPU-памяти определяет допустимый размер батча и, как следствие, throughput всей системы. H200 позволяет увеличить батч-размер по сравнению с H100 примерно в 1,7 раза, существенно снижая стоимость одного запроса при масштабировании.
Монте-Карло-симуляции, оценка портфельных рисков в реальном времени, стресс-тестирование финансовых инструментов — задачи, требующие и высокой производительности, и корпоративной надёжности оборудования. Серверы HGX H200 отвечают обоим требованиям.
Платформа HGX H200 полностью интегрирована в экосистему NVIDIA и поддерживает весь современный стек ПО для ИИ и HPC:
Совместимые операционные системы: Ubuntu 20.04/22.04 LTS, RHEL 8/9, Rocky Linux 8/9, NVIDIA DGX OS (на базе Ubuntu).
В нашем каталоге представлены серверы от ведущих производителей:
Каждая система проходит предпродажное тестирование и поставляется с полным комплектом технической документации.
Приобретая серверы NVIDIA HGX H200 у нас, вы получаете:
Для уточнения наличия, сроков поставки и возможности индивидуальной конфигурации свяжитесь с нами через форму на сайте СервакМастер.
В чём принципиальное отличие H200 от H100? Вычислительные блоки (Streaming Multiprocessors, Tensor Core) у обеих платформ идентичны. Главное изменение — тип и объём памяти: H200 оснащается HBM3e (141 ГБ) вместо HBM3 (80 ГБ) у H100, а пропускная способность памяти выросла с 3,35 до 4,8 ТБ/с. Это эволюционное обновление, целенаправленно устраняющее главный bottleneck для LLM-задач.
Какие требования к охлаждению и электропитанию? TDP одного GPU H200 составляет 700 Вт, суммарный тепловой пакет 8-GPU-системы — до 5,6 кВт только на GPU-блок. Для воздушного охлаждения необходимо обеспечить подачу не менее 25 м³/мин на стойку. Альтернатива — прямое жидкостное охлаждение (DLC), которое снижает нагрузку на систему вентиляции ЦОД и повышает плотность размещения оборудования.
Можно ли строить кластеры из нескольких серверов HGX H200? Да. Для многоузловых кластеров от 2 до сотен систем используется InfiniBand NDR (400 Гбит/с) или Ethernet 400GbE. NVIDIA предлагает референсные архитектуры DGX SuperPOD и BasePOD, адаптированные под платформу HGX H200 и обеспечивающие линейное масштабирование производительности.