Нет в наличии
- ТипНовые
- Основная задачаОбучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC)
- Процессор (CPU)AMD EPYC
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
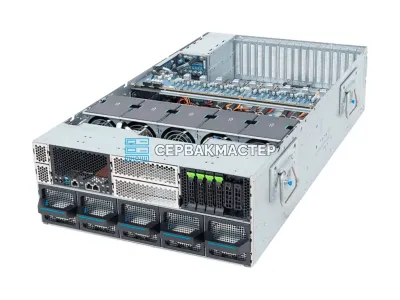
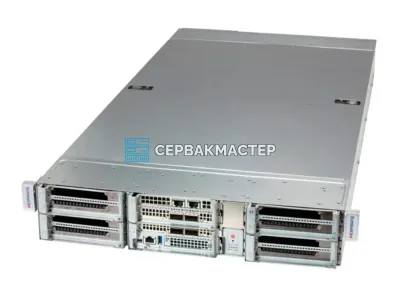
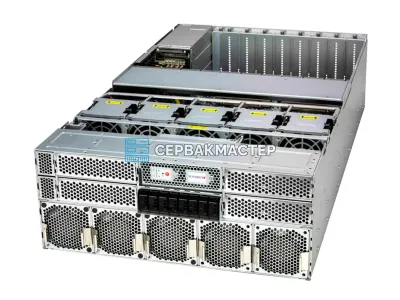
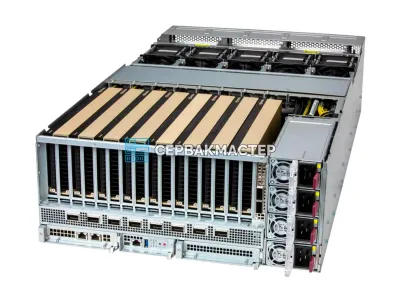
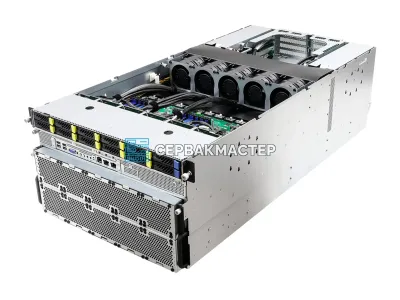
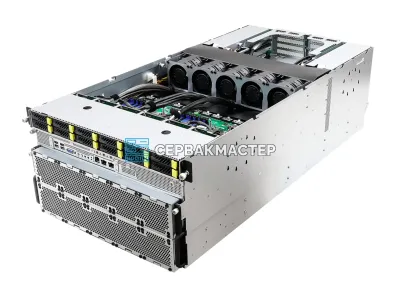
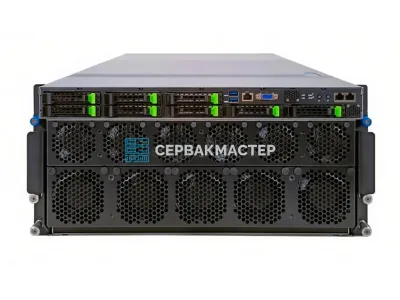
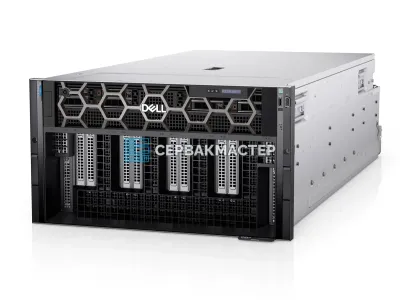
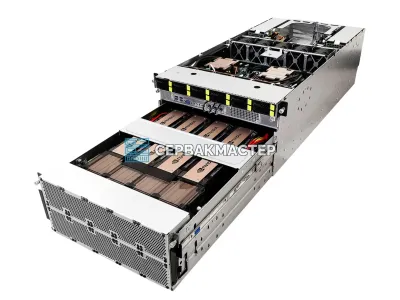
Ускоритель NVIDIA H200 построен на архитектуре Hopper и стал логичным развитием линейки H100 — принципиальное отличие заключается в кардинально обновлённой подсистеме памяти. Именно этот компонент превратил H200 в наиболее производительную серийную платформу для задач обучения и инференса нейронных сетей. В каталоге «СервакМастер» доступны серверные платформы ведущих мировых производителей — Supermicro, Dell, ASUS и других вендоров, оснащённые данным ускорителем.
Архитектурно GPU идентичен H100, однако заменённая память HBM3e переводит систему в другой класс возможностей:
| Параметр | Значение |
|---|---|
| Архитектура | Hopper (GH100) |
| Объём памяти | 141 ГБ HBM3e |
| Пропускная способность памяти | 4,8 ТБ/с |
| Производительность FP8 (Tensor Core) | 3958 TFLOPS |
| Производительность FP16 (Tensor Core) | 1979 TFLOPS |
| Производительность FP64 | 67 TFLOPS |
| Флагманский интерфейс | SXM5 |
| Бюджетный интерфейс | PCIe Gen5 x16 |
| TDP (SXM-версия) | 700 Вт |
| NVLink | 4.0, 900 ГБ/с (full mesh до 8 GPU) |
| Поддержка MIG | До 7 экземпляров |
Модели класса GPT-4, LLaMA-3, Mixtral и их производные при полном обучении требуют сотен гигабайт VRAM под параметры, градиенты и состояния оптимизатора. Восьмикарточный узел с суммарным объёмом 1128 ГБ HBM3e позволяет обучать модели до 100B параметров без применения схем разгрузки на CPU или NVMe.
Большой объём памяти напрямую влияет на латентность — чем больше модель умещается в VRAM, тем выше throughput при обработке параллельных запросов. H200 сокращает время ответа чат-ботов, систем рекомендаций и пайплайнов генерации изображений по сравнению с предшественниками.
Производительность в двойной точности FP64 на уровне 67 TFLOPS соответствует требованиям задач квантовой химии, вычислительной гидродинамики, молекулярной динамики и астрофизических симуляций.
Параллельная обработка тысяч видеопотоков востребована в системах видеонаблюдения, промышленного контроля качества, автономных транспортных систем и медицинской визуализации.
Монте-карло симуляции, оценка рыночных рисков, ценообразование деривативов и бэктестинг торговых стратегий — задачи, где H200 обеспечивает кратное ускорение по сравнению с традиционными CPU-кластерами.
Оптимальны для разработки, прототипирования и небольших production-инсталляций. Форм-фактор 1U или 2U, типовое энергопотребление системы — от 1,2 до 2,4 кВт. Подходят для задач инференса моделей до 13B параметров и компьютерного зрения.
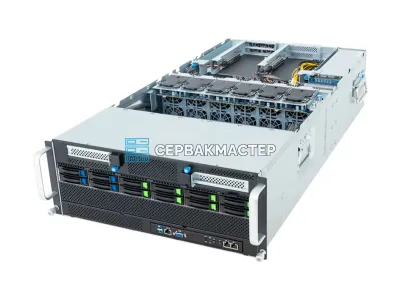
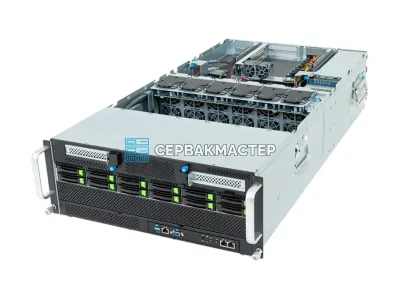
Сбалансированный вариант для производственной нагрузки среднего масштаба. Форм-фактор 4U, потребление порядка 4–5 кВт. Позволяют обучать модели до 70B параметров с применением техник параллелизма и запускать несколько независимых задач инференса одновременно.
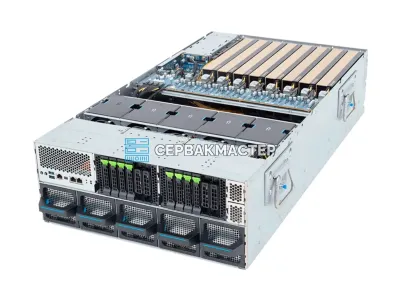
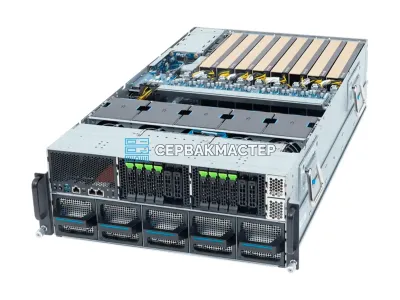
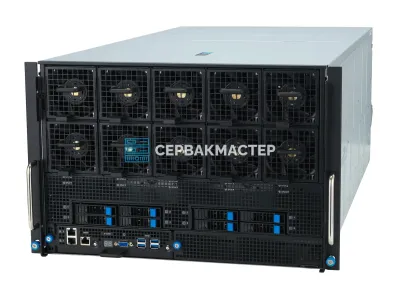
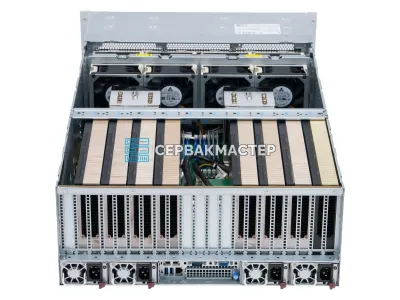
Флагманские платформы Supermicro SYS-821GE-TNHR, Dell PowerEdge XE9680 и аналогичные решения размещают восемь ускорителей H200 SXM в одном корпусе. Суммарное потребление — до 10–12 кВт. Для объединения таких узлов в кластер используются сети InfiniBand NDR (400 Гб/с) или Ethernet 400GbE, обеспечивающие линейное масштабирование при распределённом обучении.
Остались вопросы по выбору GPU-сервера с NVIDIA H200 или хотите рассчитать стоимость кластерного решения? Свяжитесь с командой «СервакМастер» через форму обратной связи на сайте или по электронной почте — поможем подобрать оптимальную конфигурацию под ваш бюджет и производственные требования.