
GPU-сервер GIGABYTE G893-SD1-AAX5 на 8× NVIDIA B200 SXM 180GB (8U, 1440 ГБ HBM3e)








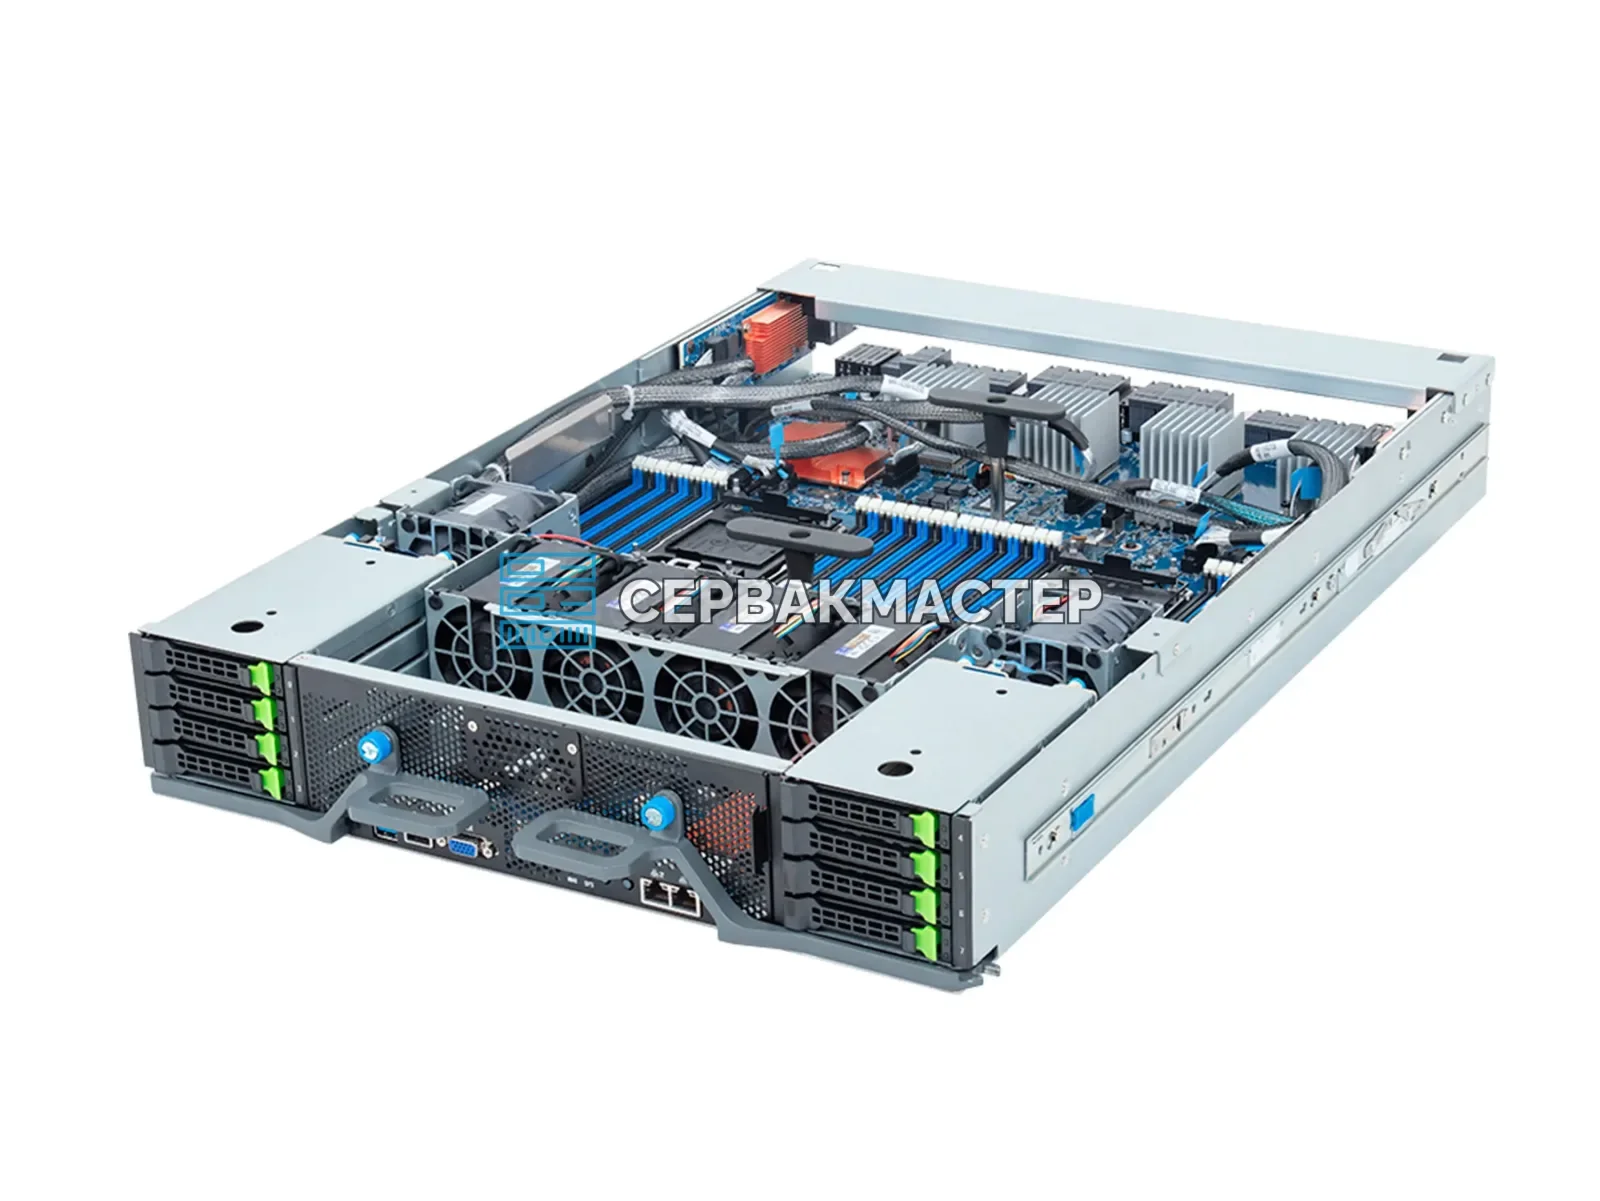
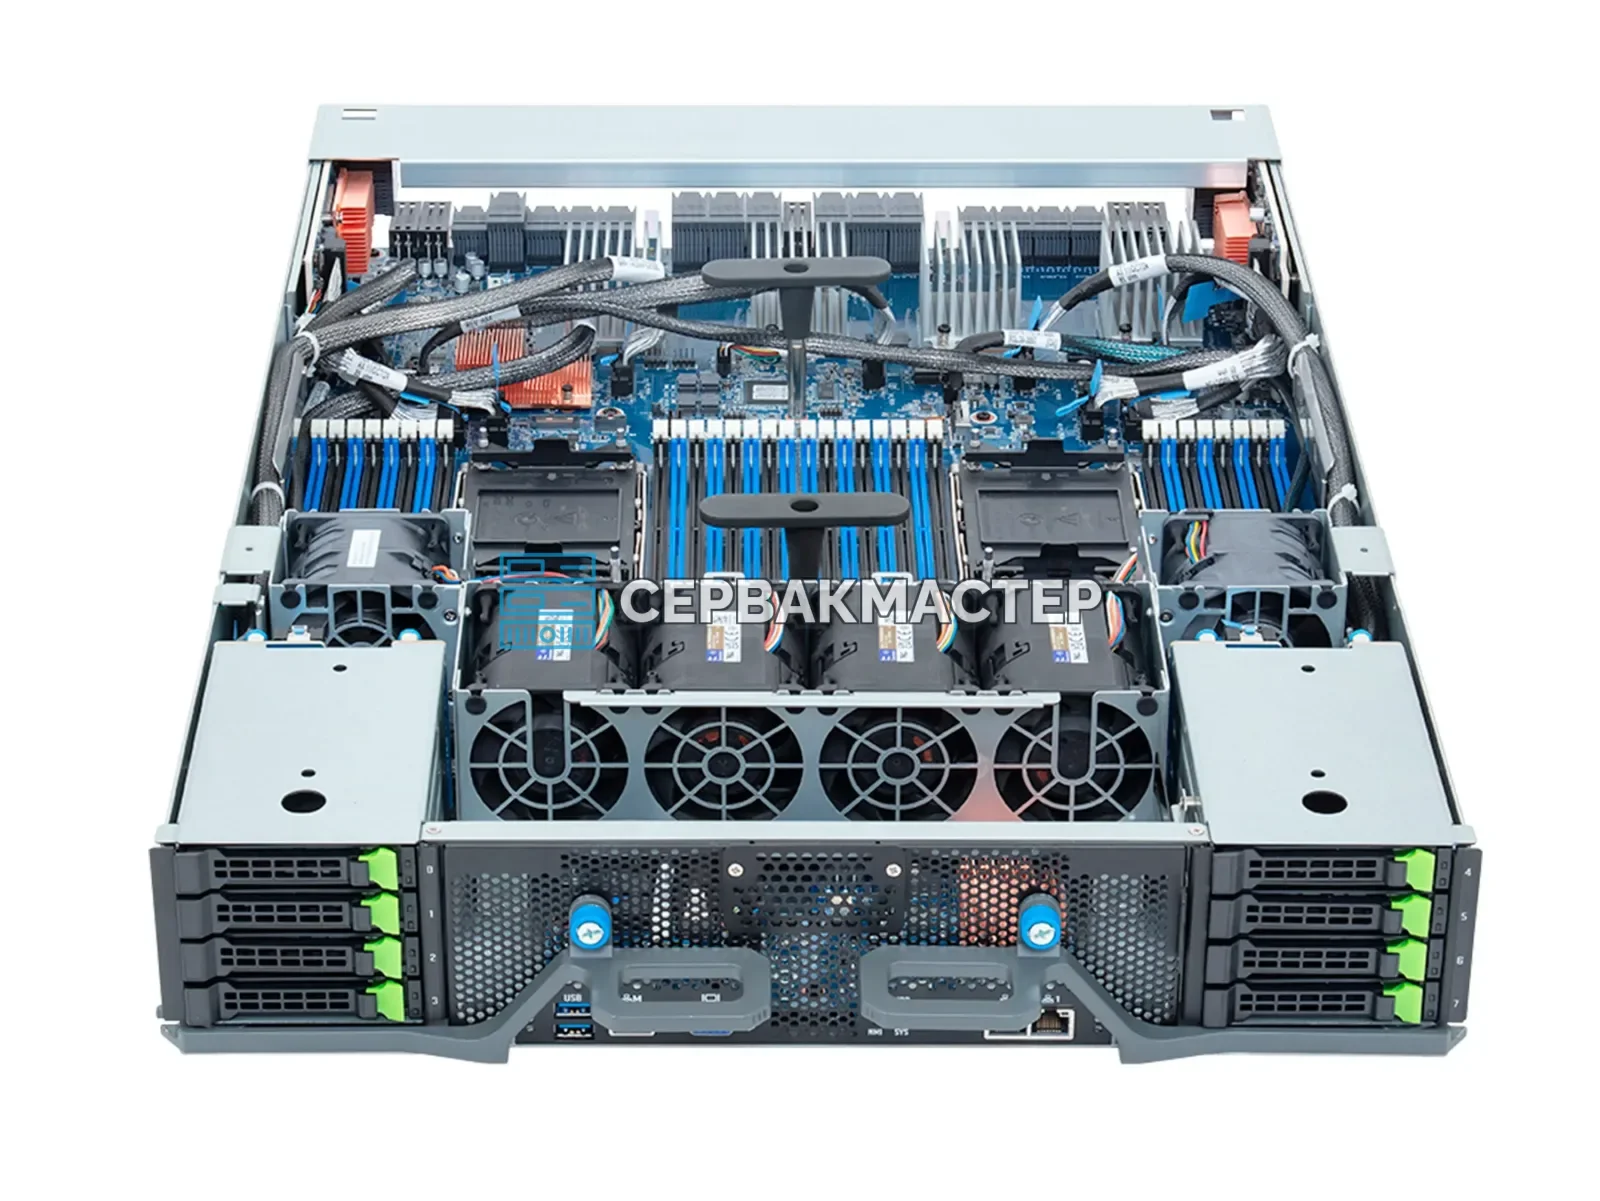

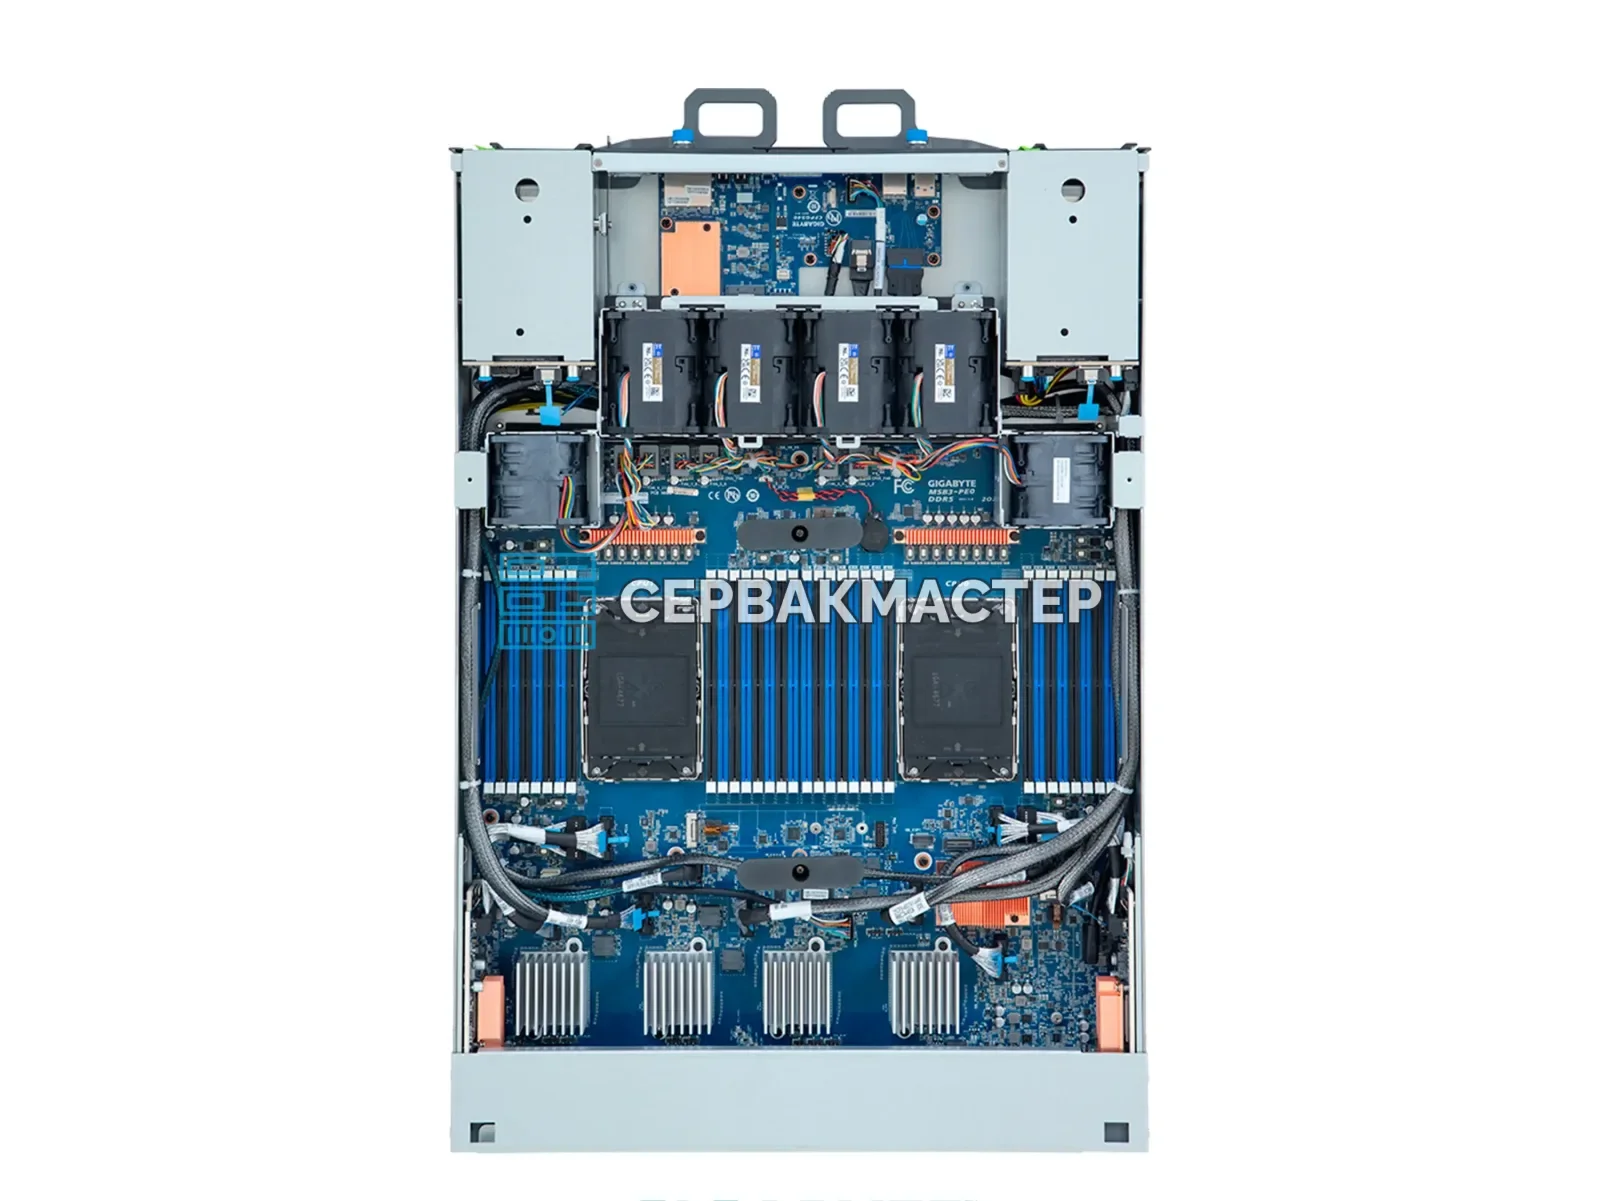


Обзор GIGABYTE G893-SD1-AAX5
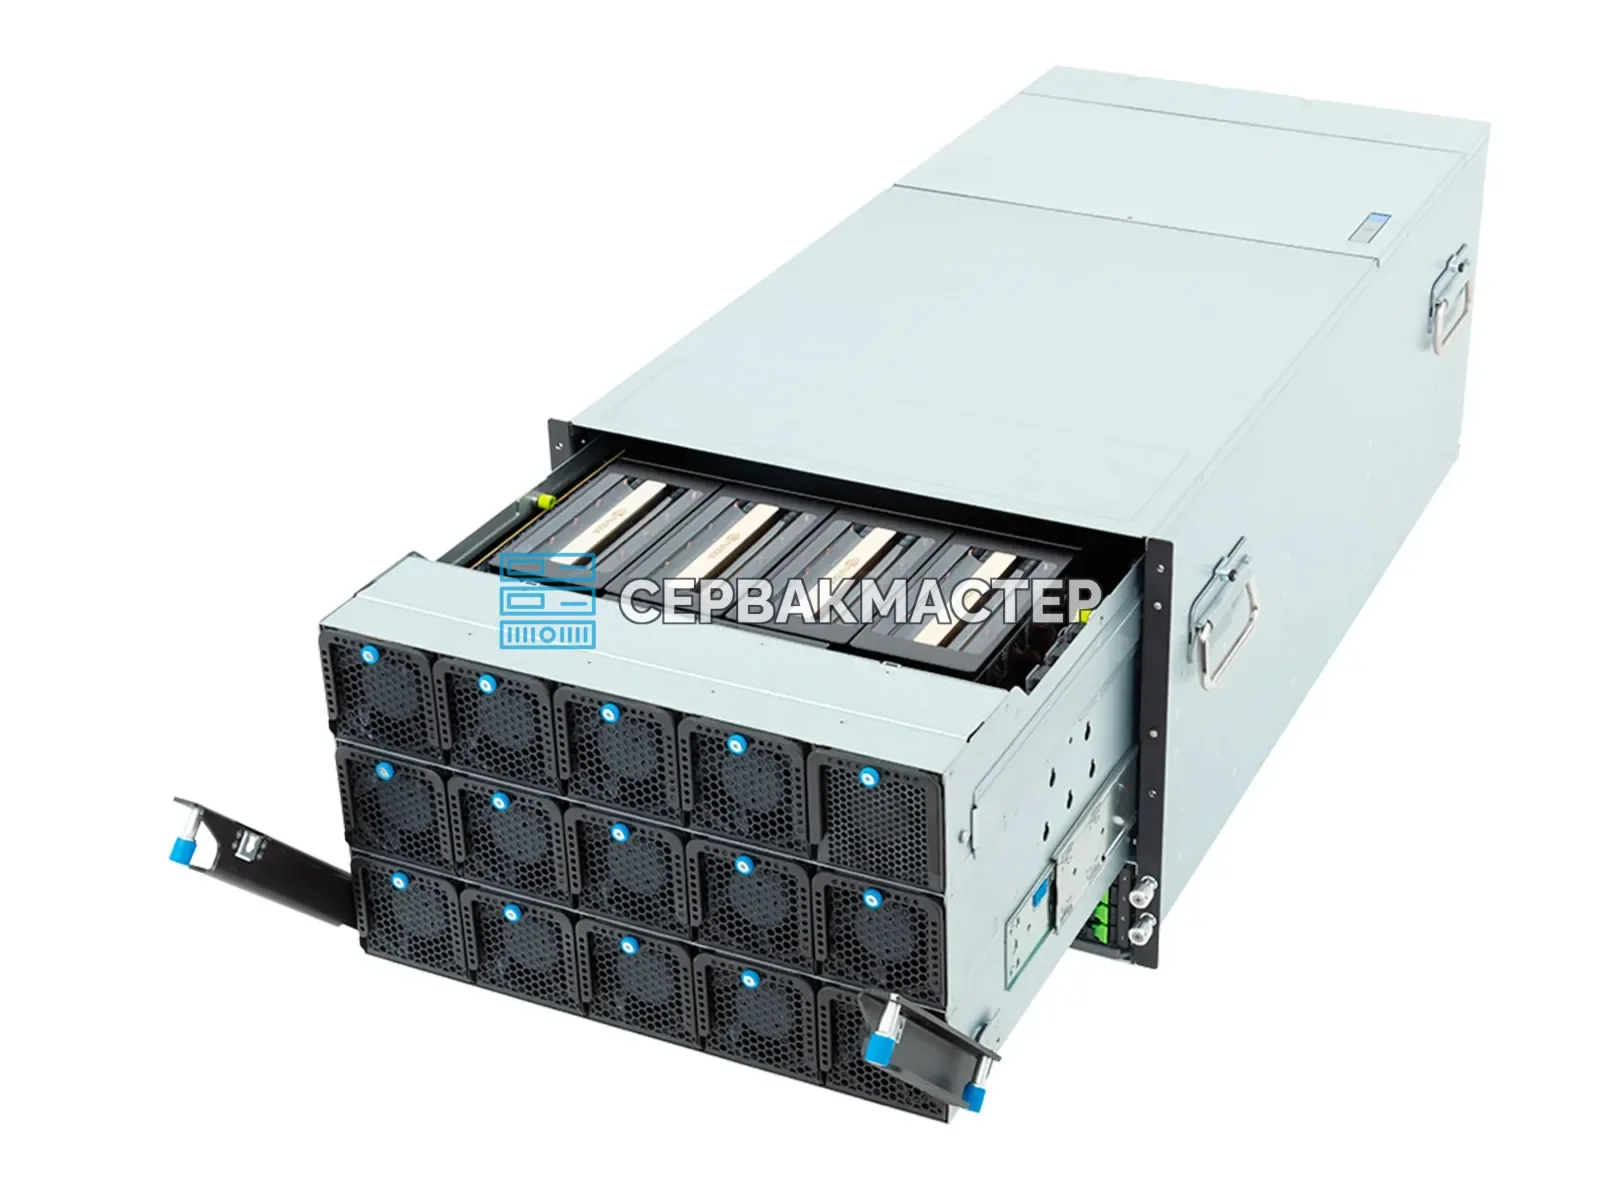
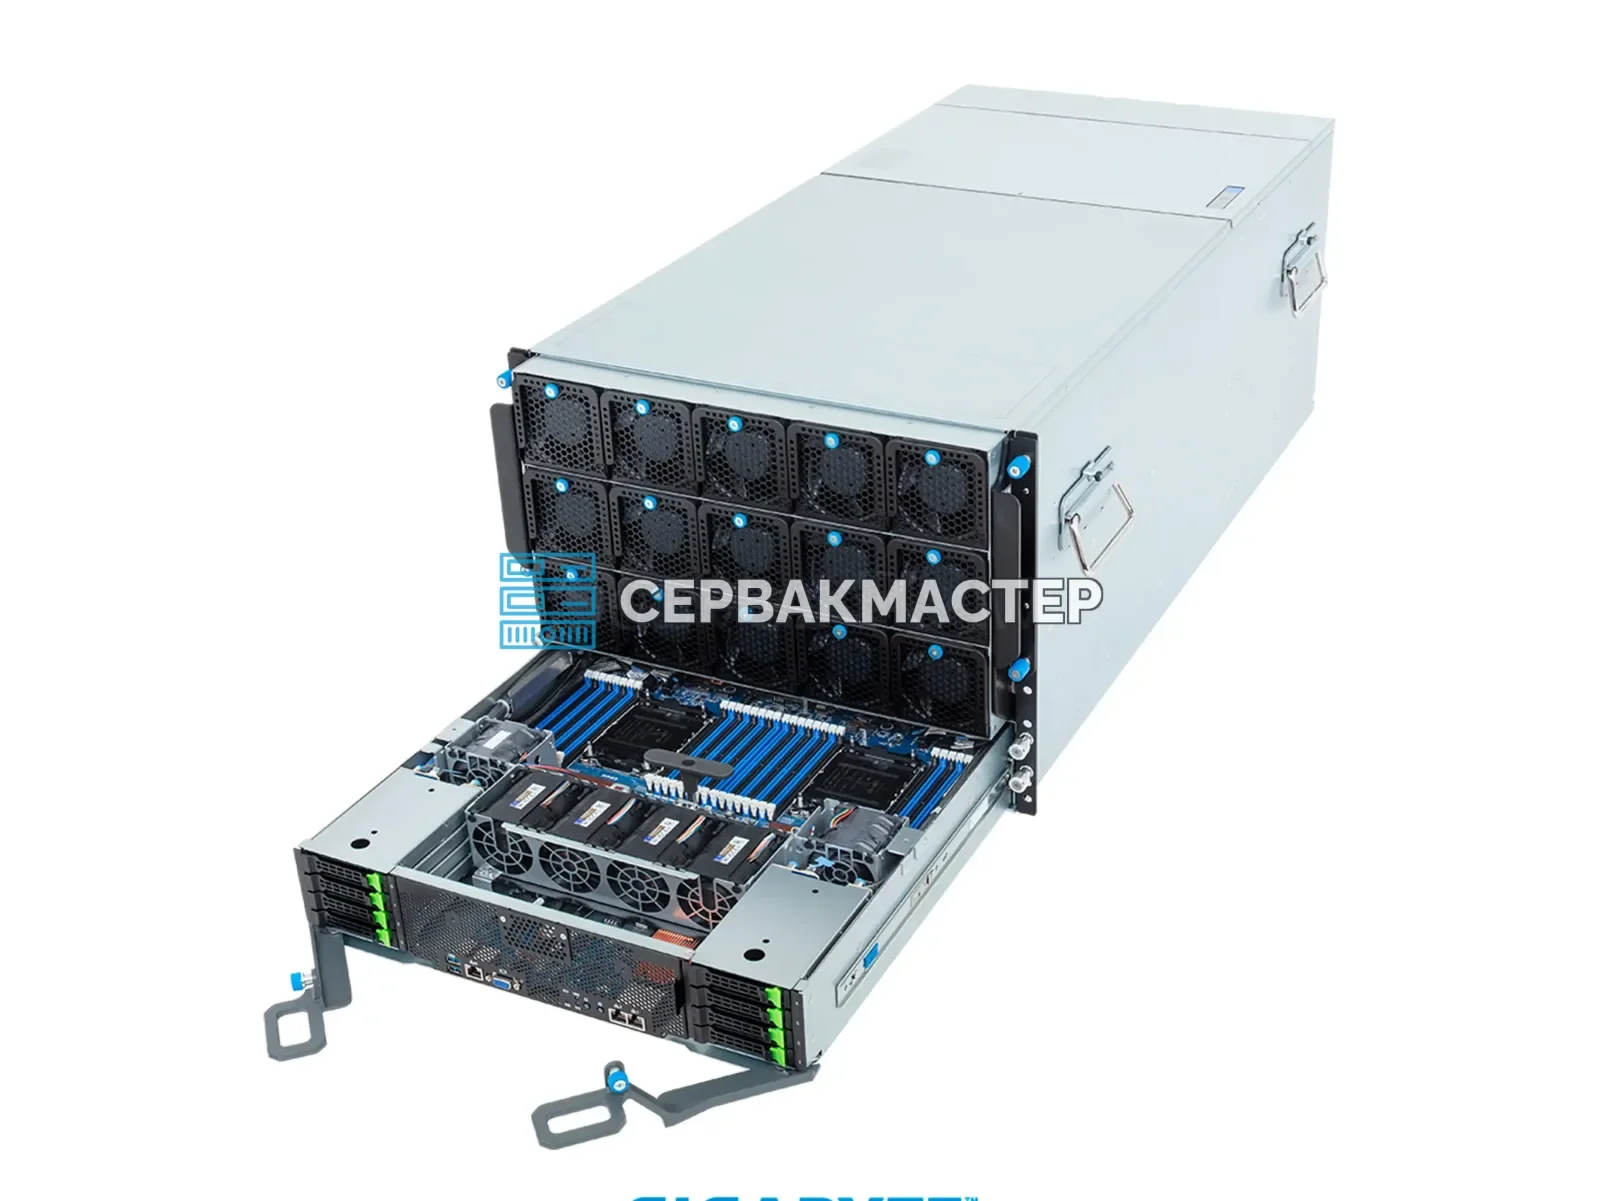
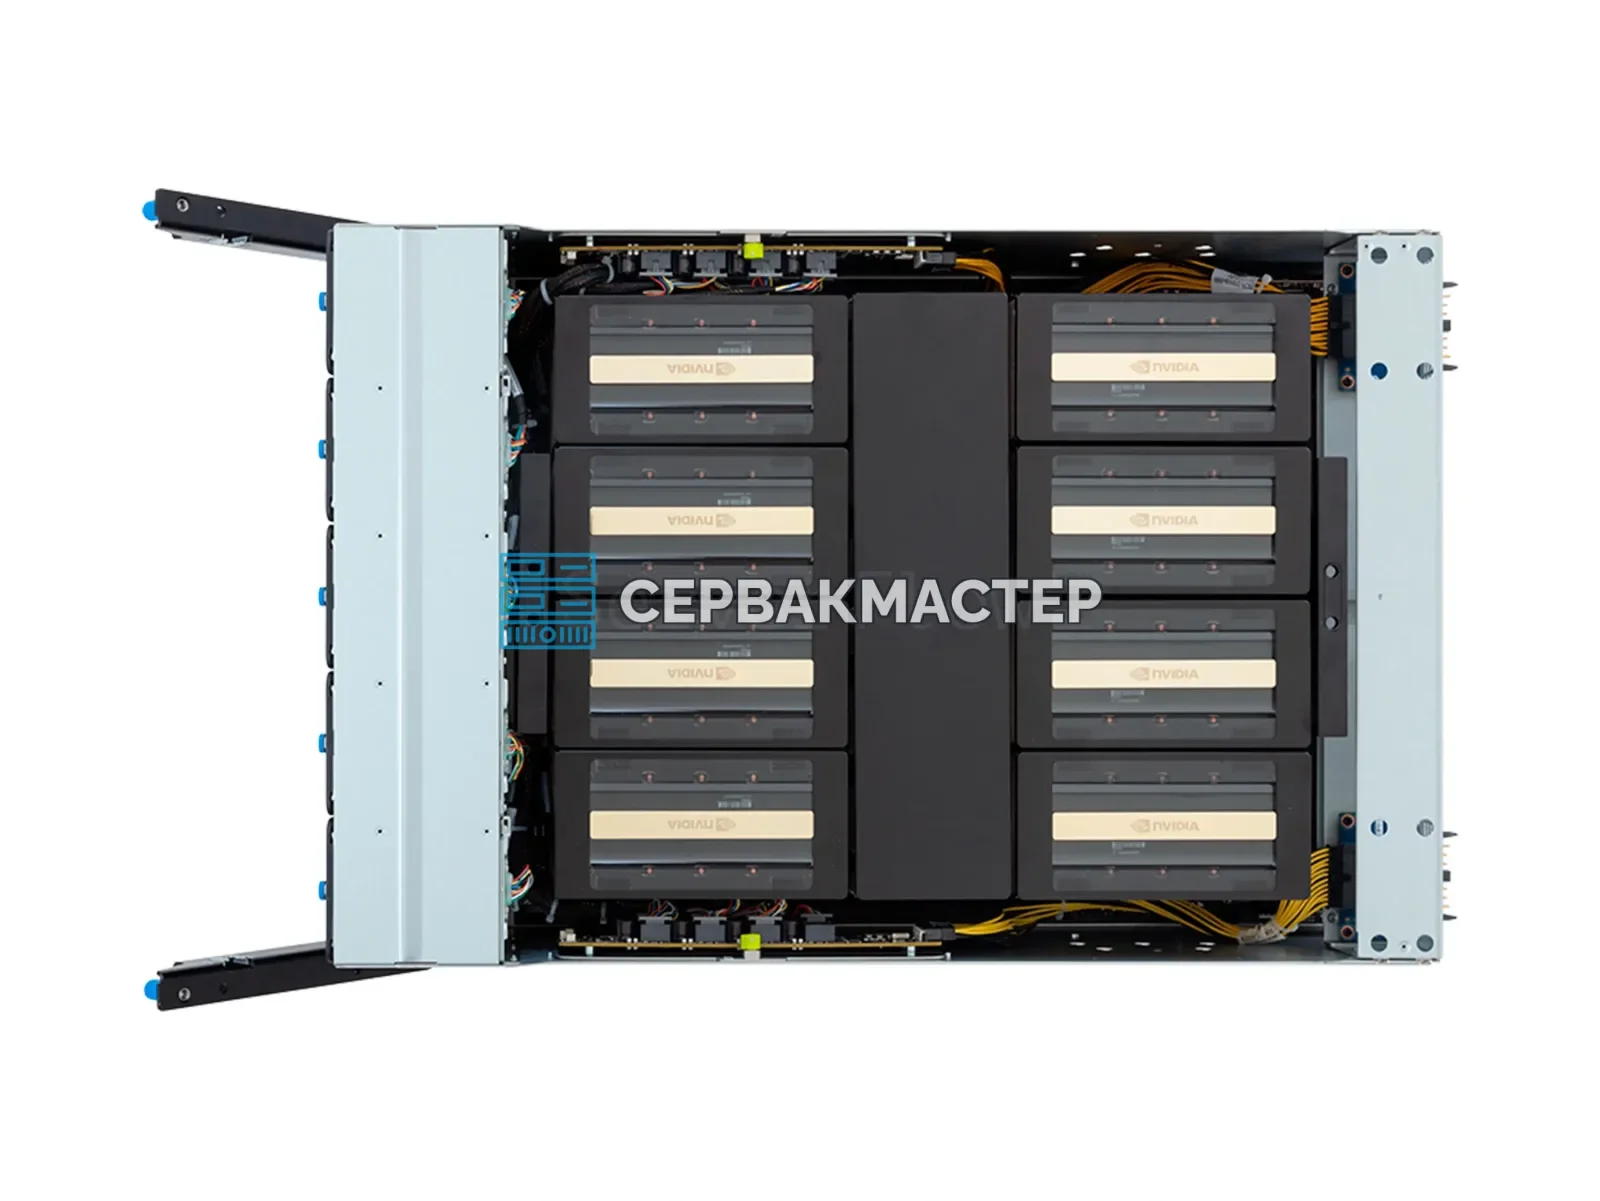
GIGABYTE G893-SD1-AAX5 — это 8U-платформа для ресурсоёмких задач искусственного интеллекта, построенная на модуле NVIDIA HGX B200 с восемью GPU в форм-факторе SXM. Суммарный объём видеопамяти HBM3e составляет 1440 ГБ (около 1,4 ТБ), поэтому система рассчитана на крупные модели, большие батчи и длинный контекст как при обучении, так и при промышленном инференсе.
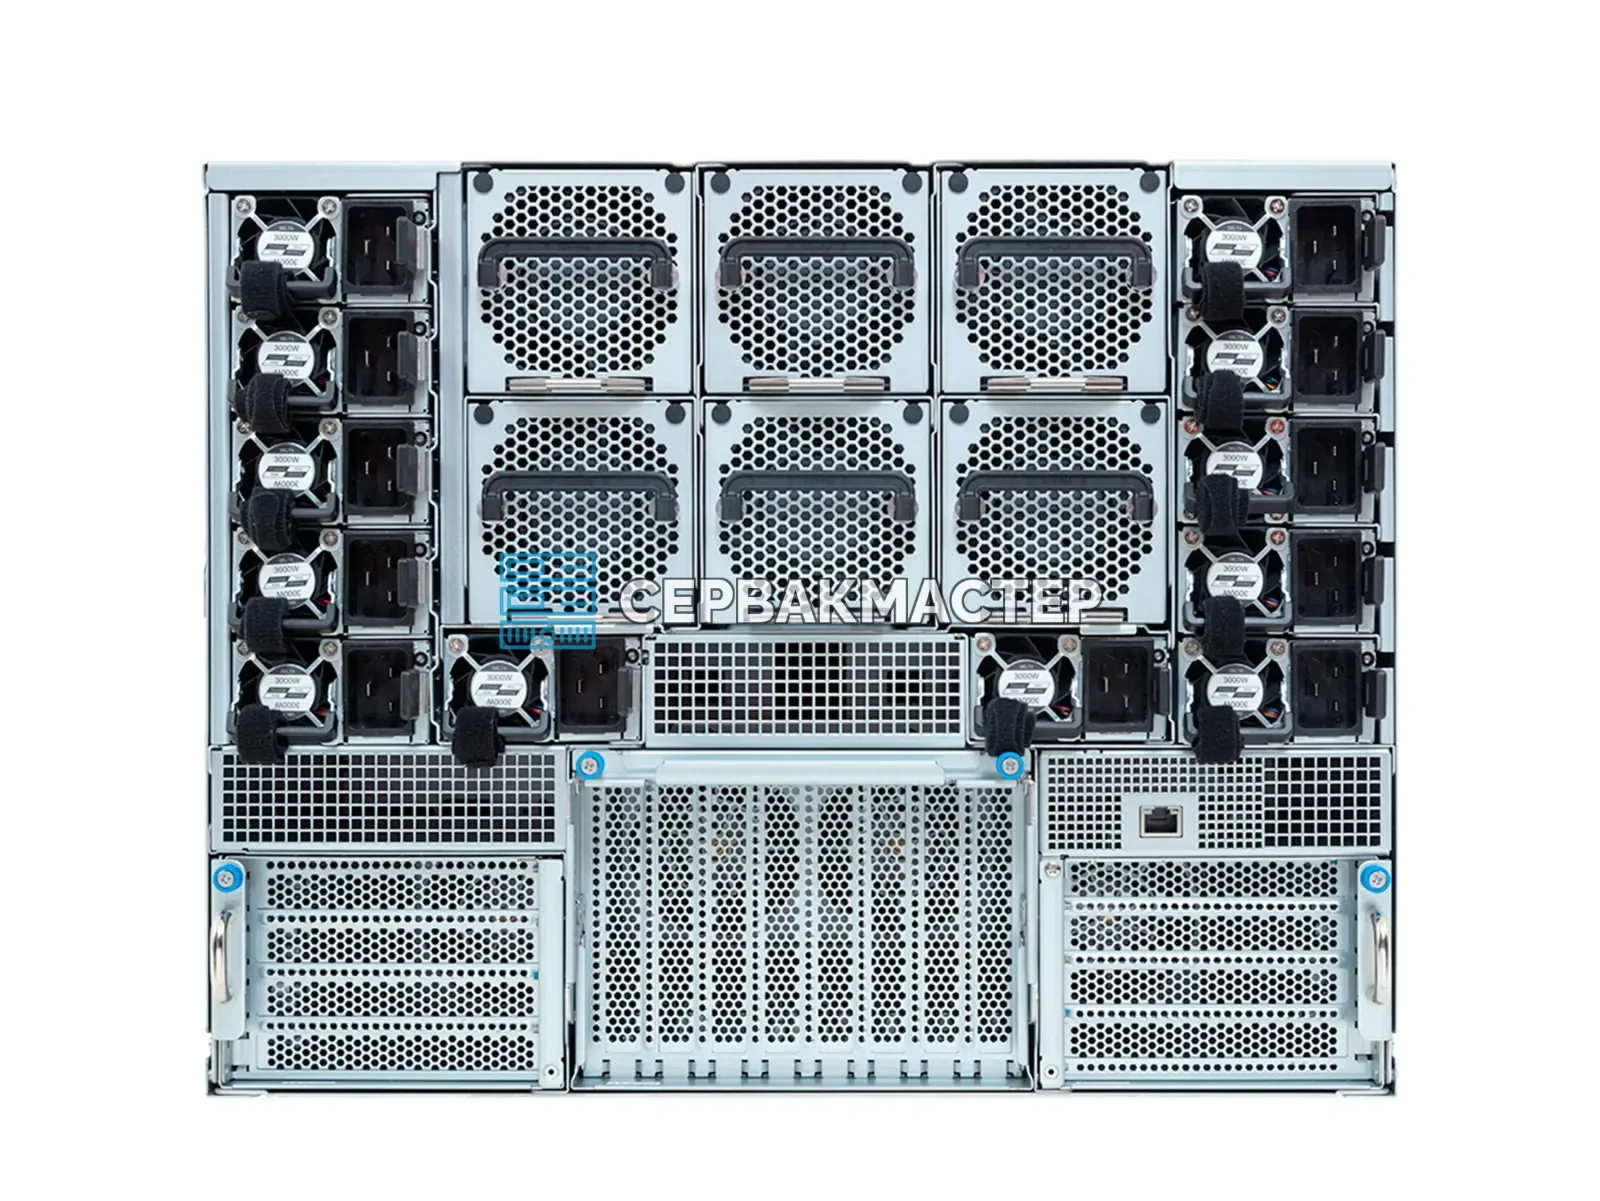
Вычислительную часть дополняют два процессора Intel Xeon и до 8 ТБ оперативной памяти DDR5. Такая конфигурация подходит там, где важны масштабирование на несколько GPU и стабильность под непрерывной нагрузкой: в дата-центрах, исследовательских лабораториях и в компаниях, которые разворачивают собственные языковые модели.
Ключевые особенности
- Восемь GPU NVIDIA B200 SXM по 180 ГБ HBM3e каждый, итого 1440 ГБ видеопамяти.
- Совокупная производительность HGX B200 (8 GPU): FP4 Tensor core — 144 PFLOPS, FP8/FP6 — 72 PFLOPS, BF16/FP16 — 36 PFLOPS, INT8 — 72 POPS, FP32 Tensor core — 600 TFLOPS, FP64 Tensor core — 296 TFLOPS.
- Два сокета LGA4677: поддерживаются Intel Xeon Scalable 4-го и 5-го поколений, а также Intel Xeon CPU Max Series, TDP до 350 Вт.
- Память DDR5 RDIMM: 32 слота, 8 каналов на процессор, до 8 ТБ. Для 5th Gen заявлены скорости до 5600 MT/s (1DPC) и 4400 MT/s (2DPC), для 4th Gen и Xeon Max — до 4800 и 4400 MT/s соответственно.
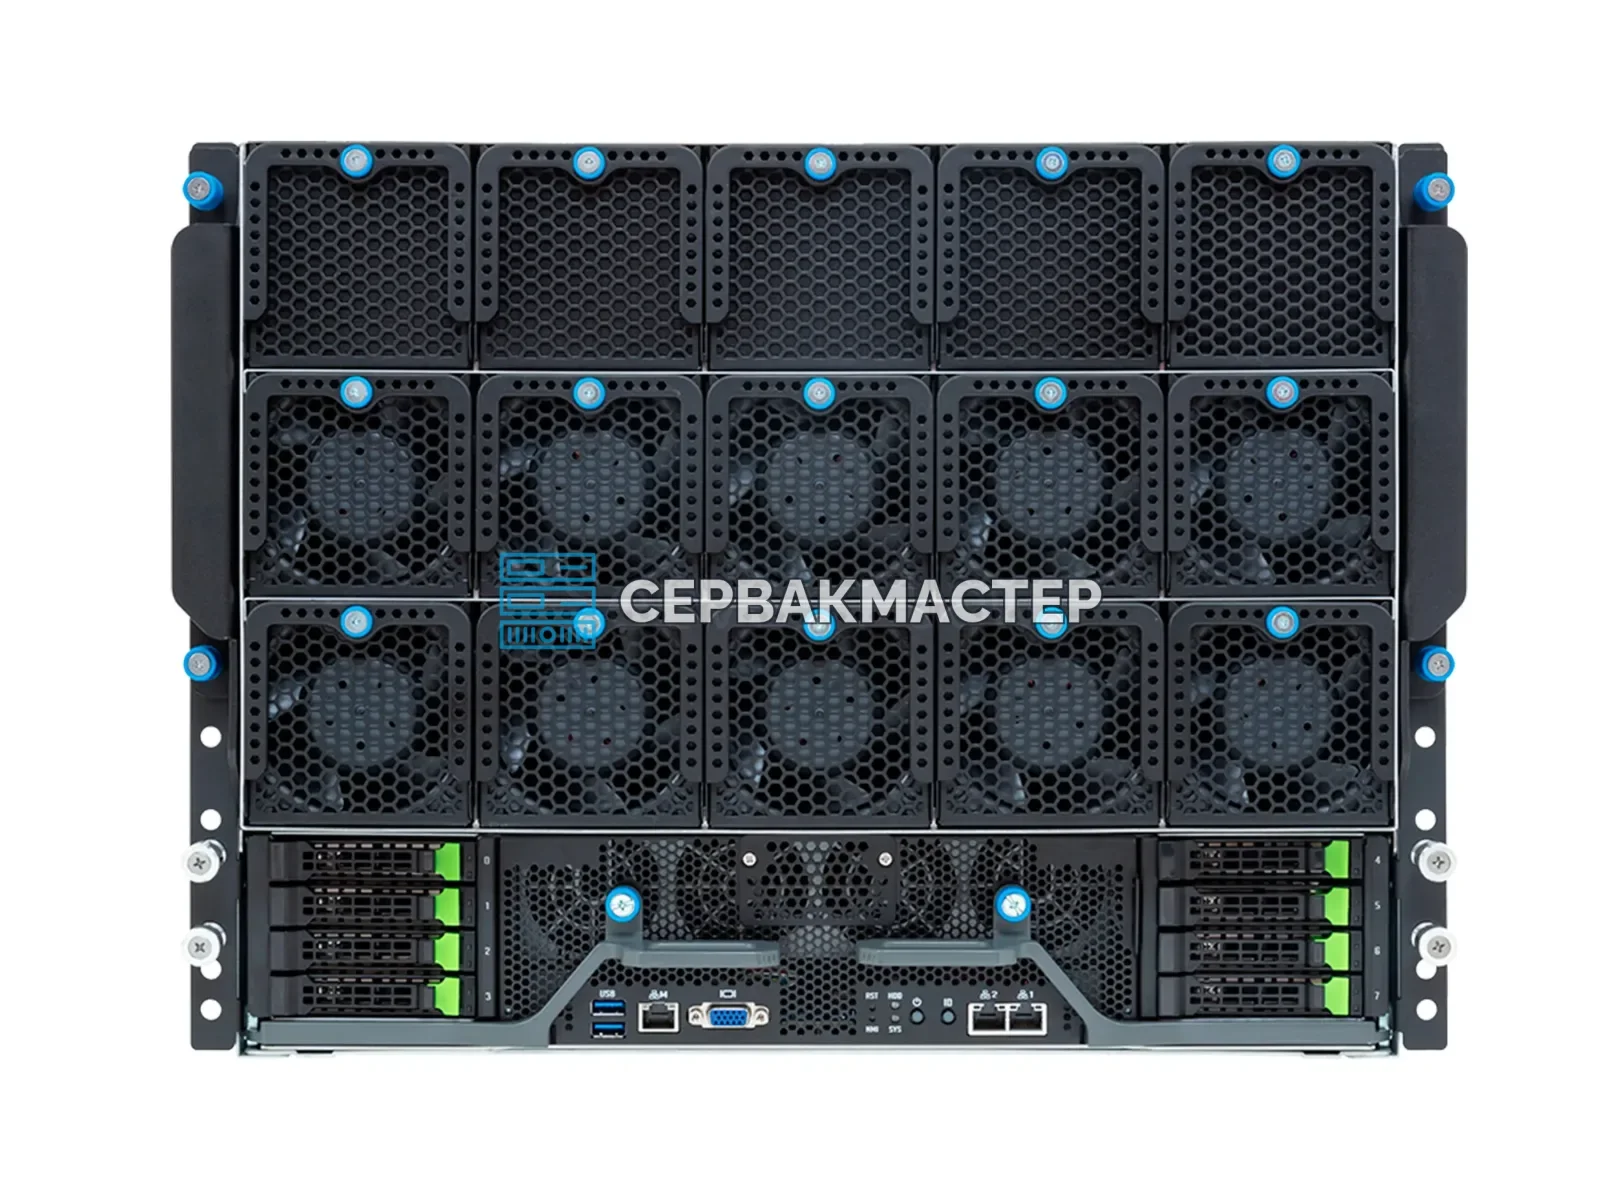
- Накопители: 8× 2,5" Gen5 NVMe/SATA с горячей заменой и 2× M.2 (PCIe Gen3 x2 и Gen3 x1).
- Ограничение платформы: при установке одного процессора часть функций PCIe и памяти может быть недоступна, поэтому для максимальной пропускной способности логично использовать два CPU.
Характеристики
| Параметр | Значение |
|---|---|
| Состояние | Новое |
| Форм-фактор | 8U |
| GPU | 8× NVIDIA B200 SXM 180GB |
| Видеопамять | 1440 ГБ HBM3e |
| Процессоры | 2× Intel Xeon (LGA4677, TDP до 350 Вт) |
| Оперативная память | до 8 ТБ DDR5 ECC RDIMM, 32 слота, 8 каналов на процессор |
| Накопители | 8× 2,5" Gen5 NVMe/SATA hot-swap |
| Дополнительно | 2× M.2 (PCIe Gen3 x2 и Gen3 x1) |
| FP4 Tensor core (8 GPU) | 144 PFLOPS |
| FP8/FP6 Tensor core (8 GPU) | 72 PFLOPS |
Для каких задач подходит
Платформа рассчитана на обучение и дообучение моделей, инференс и развёртывание сервисов, RAG-системы, анализ данных, научные расчёты (HPC), а также визуализацию и рендеринг.
По оценкам из описания, объёма памяти достаточно для запуска очень крупных языковых моделей: например, DeepSeek-V4-Pro требует примерно 865 ГБ, GLM-5.2-FP8 — около 756 ГБ, Mistral-Large-3-675B — порядка 682 ГБ, а MiMo-V2.5-Pro — примерно 1,03 ТБ VRAM. Модели меньшего размера, такие как gpt-oss:120b (около 196 ГБ), можно запускать на 2–4 GPU, оставляя запас под KV-cache и параллельные запросы.
Для генерации изображений и видео система тоже подойдёт: Stable Diffusion XL, Flux.2-dev (около 178 ГБ VRAM), SD Turbo и Kandinsky 5.0 распределяются между GPU и позволяют работать с большими батчами и высоким разрешением.
Состояние, проверка и поставка
Сервер поставляется новым. Перед отправкой «СервакМастер» тестирует оборудование, на него действует гарантия 1 год с заменой компонентов. Доставка по России осуществляется СДЭК и другими ведущими службами. Если нужна конфигурация под ваши задачи и бюджет, свяжитесь с менеджером — мы подберём подходящий вариант на этой платформе.
Характеристики
| Тип | Новые |
| Основная задача | Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) / Визуализация и рендеринг |
| Процессор (CPU) | Intel Xeon |
| Видеокарта (GPU) | NVIDIA B200 SXM |
| Количество GPU, шт | 8 |
| Общий объем видеопамяти (VRAM), ГБ | 1440 |
| Тип памяти GPU | HBM3e |
| Объем оперативной памяти (RAM), ГБ | 8192 |
| Тип оперативной памяти | DDR5 ECC REG |
| Форм-фактор | 8U |