
GIGABYTE G492-ID0 — GPU-сервер 4U с 8× NVIDIA A100 SXM 80GB (640 ГБ HBM2e)
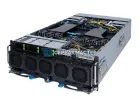

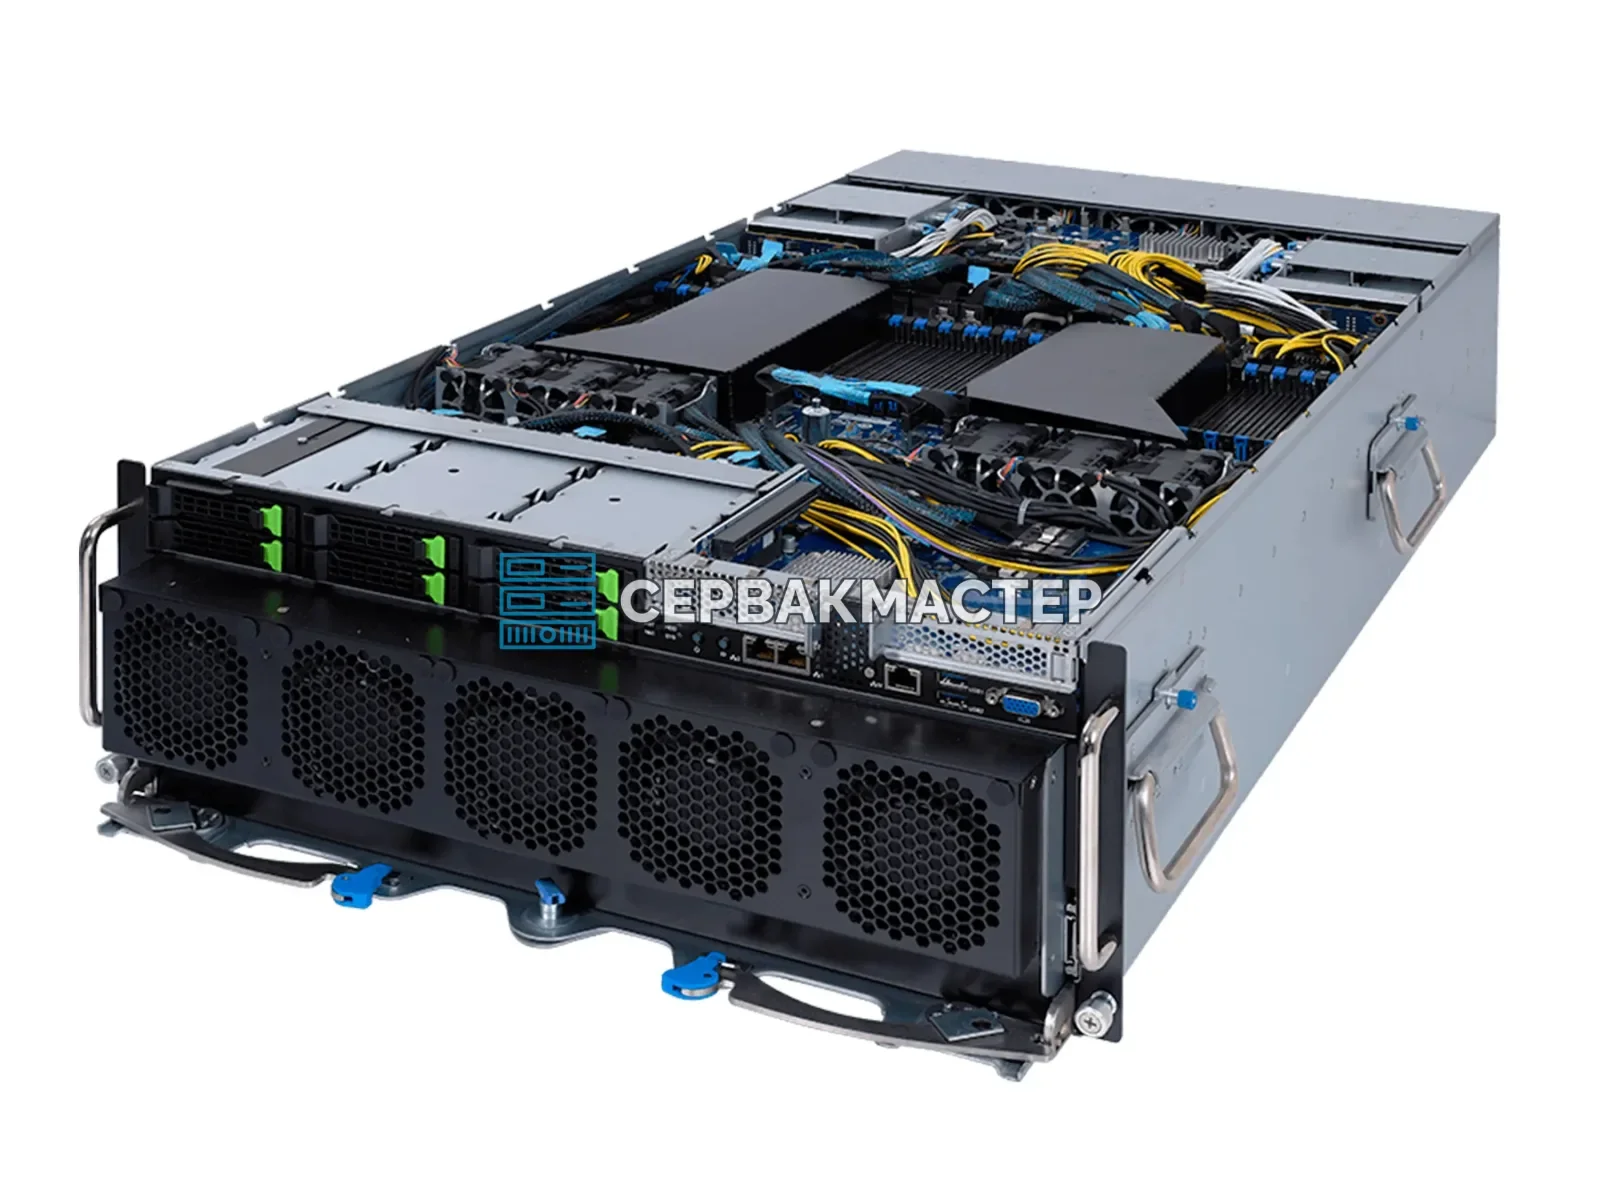


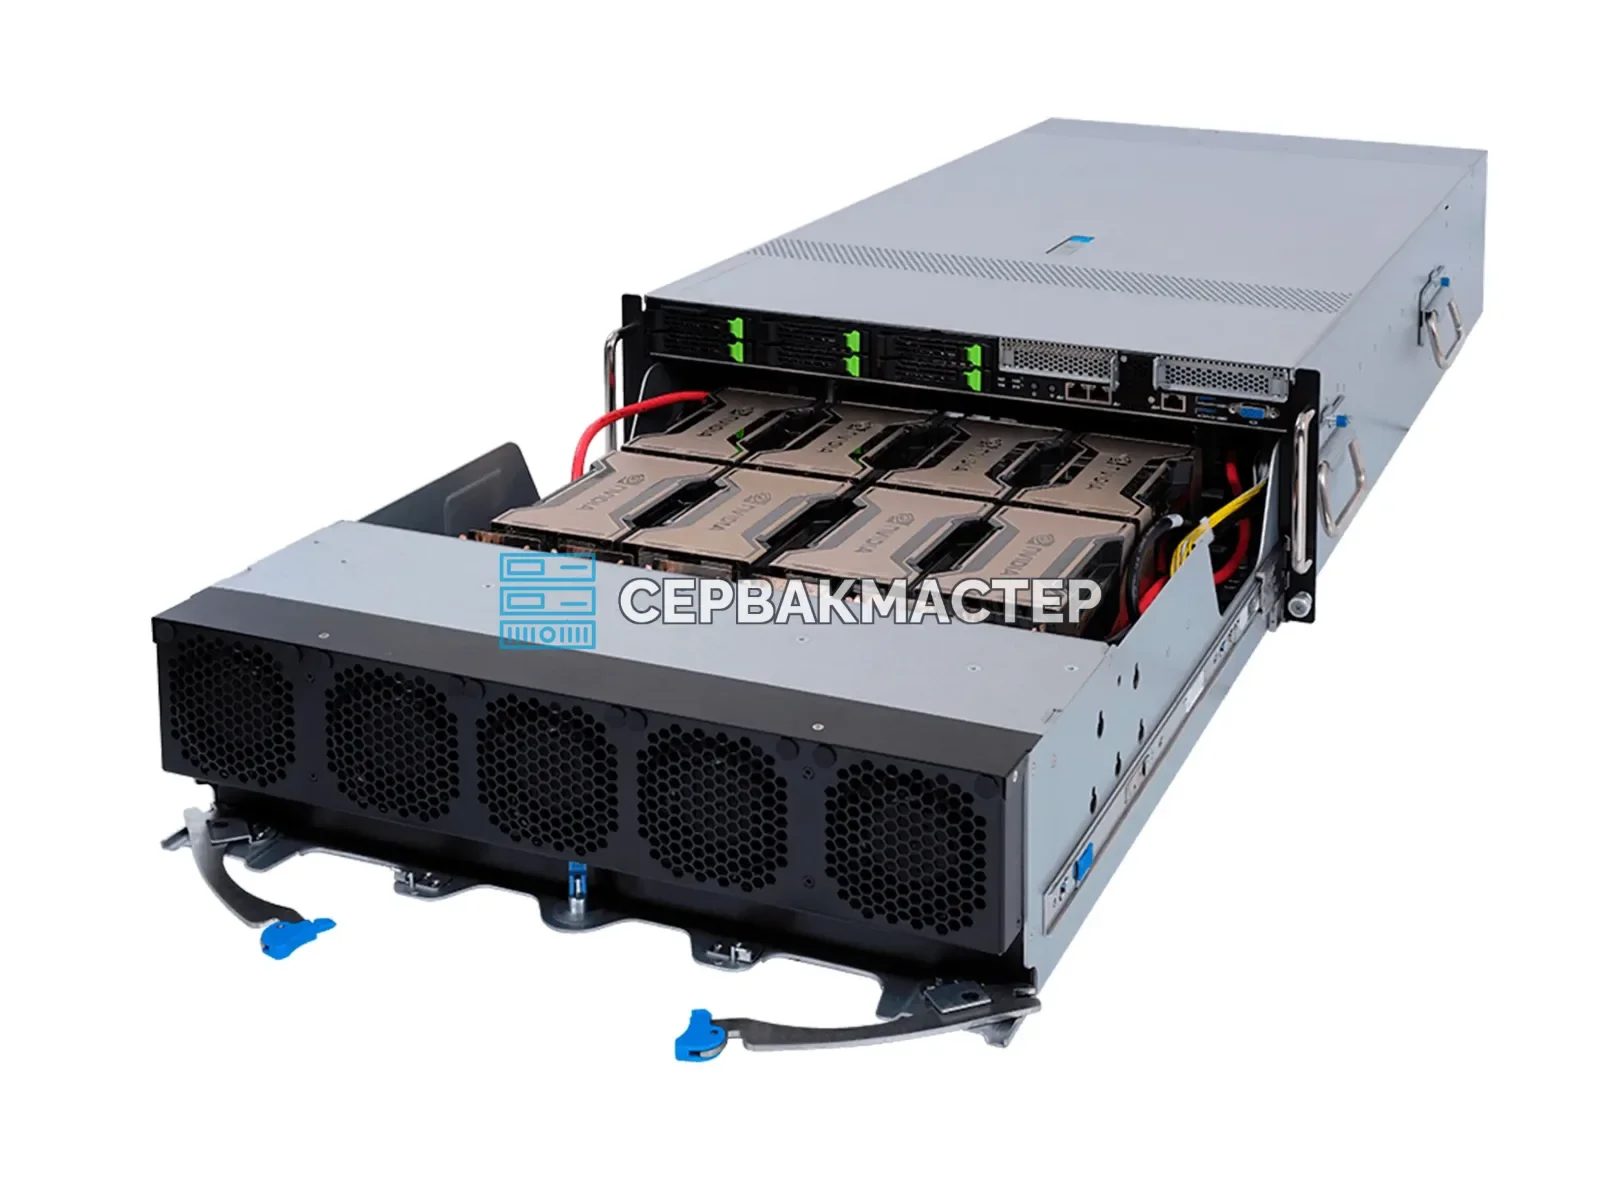


GIGABYTE G492-ID0: восемь A100 SXM в одном 4U-шасси
GIGABYTE G492-ID0 — это GPU-сервер на базе модуля NVIDIA HGX A100 с восемью ускорителями A100 SXM4 по 80 ГБ памяти HBM2e. Суммарно доступно 640 ГБ видеопамяти, а карты связаны между собой через NVLink и NVSwitch, поэтому обмен данными между GPU идёт заметно быстрее, чем по PCIe.
Платформа рассчитана на два процессора Intel Xeon Scalable 3-го поколения и до 8 ТБ оперативной памяти DDR4. Такая конфигурация подходит для задач, где модель или набор данных не помещаются в одну карту и нагрузку приходится распределять между несколькими GPU.
Ключевые особенности
- 8 GPU NVIDIA A100 (Ampere) SXM4 80GB — 640 ГБ HBM2e на сервер, достаточно для крупных моделей в распределённом режиме и для длинного контекста (KV-cache).
- NVLink/NVSwitch — быстрая связность между ускорителями, что помогает масштабировать tensor-, pipeline- и data-параллелизм.
- Два процессора Intel Xeon Scalable 3-го поколения (сокет LGA4189, TDP до 270 Вт).
- 32 слота DDR4, 8-канальная архитектура, модули RDIMM/LRDIMM до 128 ГБ и 3DS RDIMM/LRDIMM до 256 ГБ; в конфигурации указано 8192 ГБ.
- Накопители: 6 отсеков 2.5" Gen4 NVMe/SATA (NVMe без горячей замены) и 2 слота M.2 PCIe Gen4 x4 (2242/2260/2280).
- Форм-фактор 4U для стандартной серверной стойки.
Характеристики
| Параметр | Значение |
|---|---|
| Состояние | Новое |
| Форм-фактор | 4U |
| GPU | 8× NVIDIA A100 SXM4 80GB |
| Память GPU | HBM2e, 640 ГБ суммарно |
| Процессоры | 2× Intel Xeon Scalable 3-го поколения |
| Оперативная память | DDR4 ECC REG, 8192 ГБ, 32 слота |
| Накопители | 6× 2.5" Gen4 NVMe/SATA, 2× M.2 PCIe Gen4 x4 |
| Связность GPU | NVLink / NVSwitch |
| Совокупная мощность FP64 Tensor Core | 156 TFLOPS |
| Совокупная мощность BF16/FP16 Tensor Core | 4 992 TFLOPS |
| Совокупная мощность TF32 Tensor Core | 2 496 TFLOPS |
| Совокупная мощность INT8 Tensor Core | 9 984 TOPS |
Для каких задач подходит
Сервер ориентирован на ресурсоёмкие нагрузки искусственного интеллекта и научных расчётов:
- Обучение и дообучение моделей — плотная 8-GPU компоновка и NVLink позволяют распределять обучение между картами.
- Инференс больших языковых моделей — по данным поставщика, в 4-битной квантизации на 8 ускорителях запускаются модели класса DeepSeek-R1 685B, Mistral Large 3 675B и GLM-5; Qwen3.5-397B-A17B в FP8 требует порядка 406 ГБ видеопамяти. Для длинного контекста и больших батчей стоит заранее ограничивать параметры, чтобы не упереться в KV-cache.
- RAG-системы и агентные сценарии — запас памяти позволяет держать модель и обслуживать много параллельных запросов.
- Диффузионные модели — Stable Diffusion XL, Flux.2-dev, Kandinsky 5.0 и другие можно распределять по нескольким GPU и собирать очередь генерации.
- HPC и анализ данных — 156 TFLOPS FP64 Tensor Core на весь сервер для научных расчётов.
Состояние, проверка и поставка
Сервер поставляется новым. Перед отправкой «СервакМастер» тестирует оборудование, на него действует гарантия 1 год с заменой компонентов. Доставка по России осуществляется через СДЭК и другие ведущие службы доставки. Если нужна конфигурация под ваш бюджет и задачи, свяжитесь с менеджером — мы подберём подходящий вариант на этой платформе.
Характеристики
| Тип | Новые |
| Основная задача | Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) |
| Процессор (CPU) | Intel Xeon |
| Видеокарта (GPU) | NVIDIA A100 |
| Количество GPU, шт | 8 |
| Общий объем видеопамяти (VRAM), ГБ | 640 |
| Тип памяти GPU | HBM2e |
| Объем оперативной памяти (RAM), ГБ | 8192 |
| Тип оперативной памяти | DDR4 ECC REG |
| Форм-фактор | 4U |