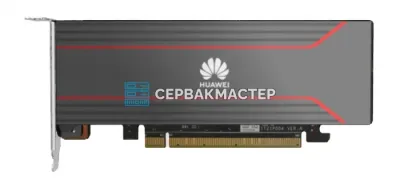
Нет в наличии
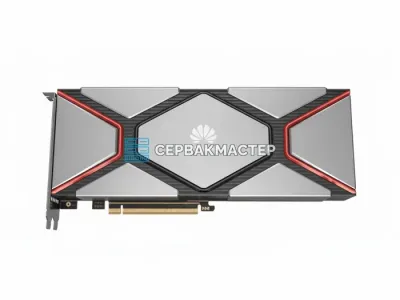
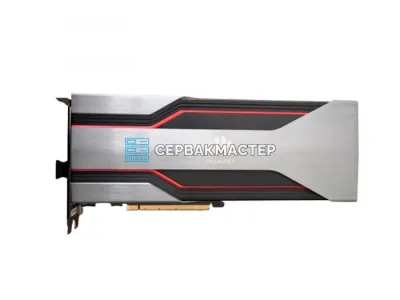
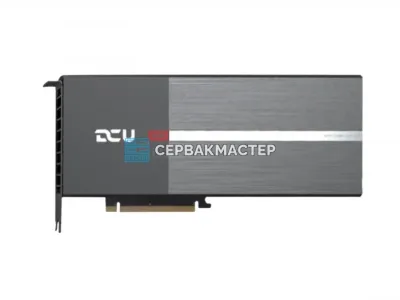
- ТипНовые
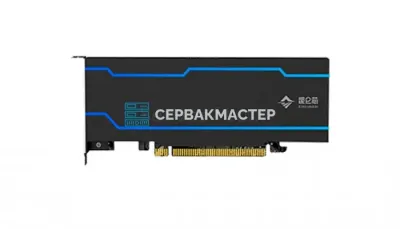
- ИИ-процессорAscend 910
- AI-мощность (INT8), TOPS560
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Современные задачи искусственного интеллекта — обучение трансформерных моделей, инференс больших языковых моделей (LLM), видеоаналитика в реальном времени — требуют принципиально иной аппаратной базы, нежели традиционные серверные CPU. Нейропроцессоры (NPU) и GPU-ускорители, представленные в каталоге «СервакМастер», обеспечивают тысячекратное ускорение тензорных вычислений по сравнению с процессорами общего назначения и позволяют строить эффективные AI-инфраструктуры любого масштаба.
Центральный процессор оптимизирован для последовательной логики с разветвлёнными условиями. Нейронные сети, напротив, состоят из миллиардов однотипных матричных умножений, которые можно выполнять параллельно. Именно для этого созданы NPU и специализированные ускорители: их архитектура содержит тысячи вычислительных ядер, заточенных под тензорные операции. Ключевые преимущества такого подхода:
Оборудование из каталога «СервакМастер» используется в самых разных задачах — от исследовательских лабораторий до промышленных систем:
Флагманские решения NVIDIA для дата-центров. H100 SXM5 несёт 80 ГБ памяти HBM3 с пропускной способностью 3,35 ТБ/с и тензорными ядрами четвёртого поколения с поддержкой FP8. A100 оснащён 80 ГБ HBM2e (2 ТБ/с) и тензорными ядрами третьего поколения. Оба поддерживают форматы FP64, FP32, BF16, FP16, INT8 и масштабируются через NVLink + NVSwitch до восьми ускорителей в одном когерентном узле.
Профессиональные ускорители на базе архитектуры Ada Lovelace в форм-факторе PCIe — для серверов без SXM-интерфейса. 48 ГБ GDDR6 ECC-памяти, 864 тензорных ядра Ada, поддержка DLSS 3 и профессиональных 3D-рабочих нагрузок. Оптимальный выбор, когда инференс LLM и GPU-рендеринг нужно объединить на одном устройстве.
Ускорители Intel на архитектуре Gaudi (разработка Habana Labs). Gaudi 2 — 96 ГБ HBM2e, 24 RDU-ядра, встроенный коммутатор для масштабирования без внешних InfiniBand-свитчей. Gaudi 3 удваивает производительность BF16 и увеличивает пропускную способность памяти. Полная поддержка PyTorch, TensorFlow и DeepSpeed через открытый стек Habana SynapseAI.
96 ГБ унифицированной памяти HBM3 с совокупной пропускной способностью 5,3 ТБ/с — рекордный показатель среди серийных ускорителей. Архитектура CDNA 3 обеспечивает высокую эффективность при инференсе крупных LLM-моделей: весь набор весов модели на 70 млрд параметров умещается на одном чипе без квантизации. Поддержка ROCm и HIP позволяет запускать большинство популярных ML-фреймворков.
Перед покупкой важно оценить несколько технических характеристик, которые напрямую влияют на применимость ускорителя в вашем проекте:
Мы специализируемся на профессиональном серверном оборудовании и предлагаем полный цикл сопровождения сделки:
Подойдёт ли PCIe-ускоритель к моему серверу? Большинство PCIe-моделей устанавливаются в стандартный слот PCIe x16 Gen 4/5. Убедитесь, что у вашего сервера достаточно мощности блока питания и присутствует слот нужного поколения. SXM-версии требуют специализированных серверных платформ с соответствующими разъёмами.
Под какой операционной системой работают ускорители? Большинство ускорителей поддерживают Linux и Windows Server. Для NVIDIA используется стек CUDA; для Intel — OneAPI; для AMD — ROCm/HIP. Linux является предпочтительной платформой для производственных ML-систем.
Как определить, сколько ускорителей нужно для моей задачи? Точный расчёт зависит от архитектуры модели, требуемой пропускной способности и бюджета задержки. Свяжитесь со специалистами «СервакМастер» — мы проведём бесплатную консультацию и предложим оптимальную конфигурацию под ваши задачи.