
Сервер Supermicro AS-4124GO-NART с 8× NVIDIA A100 SXM 40GB (HGX, 4U)
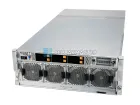
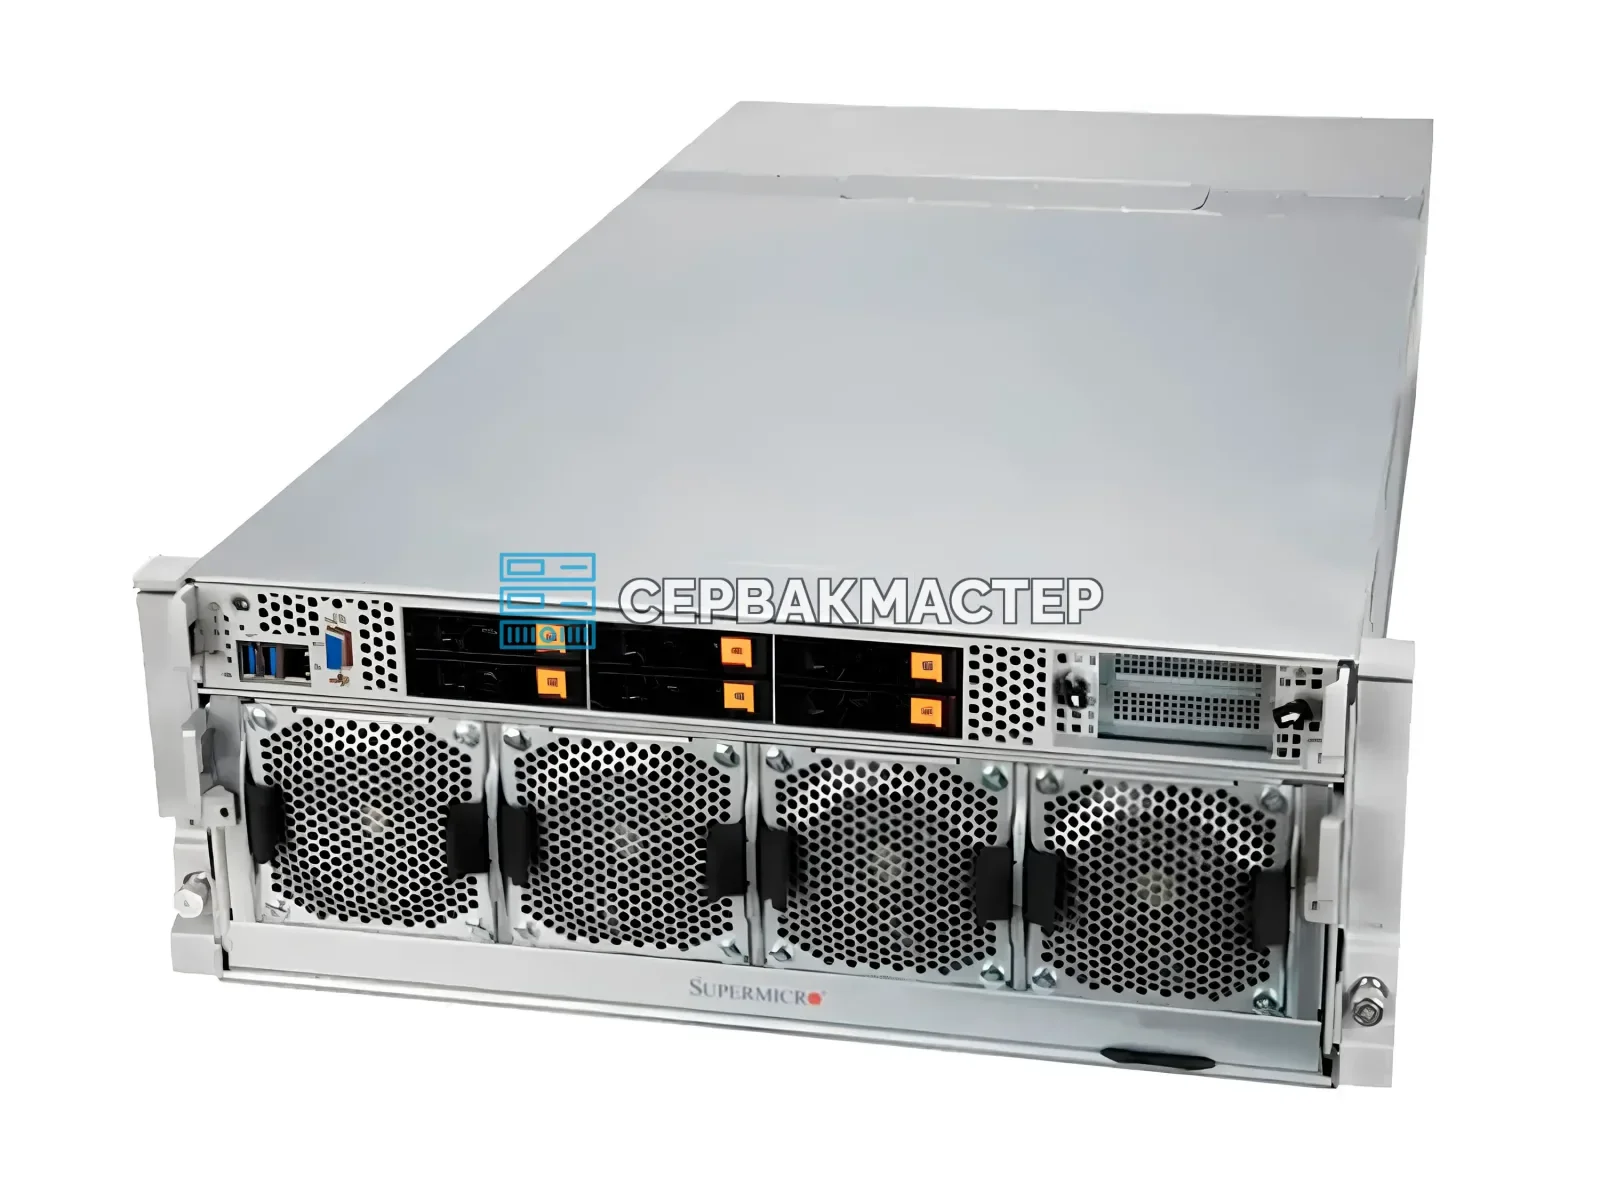
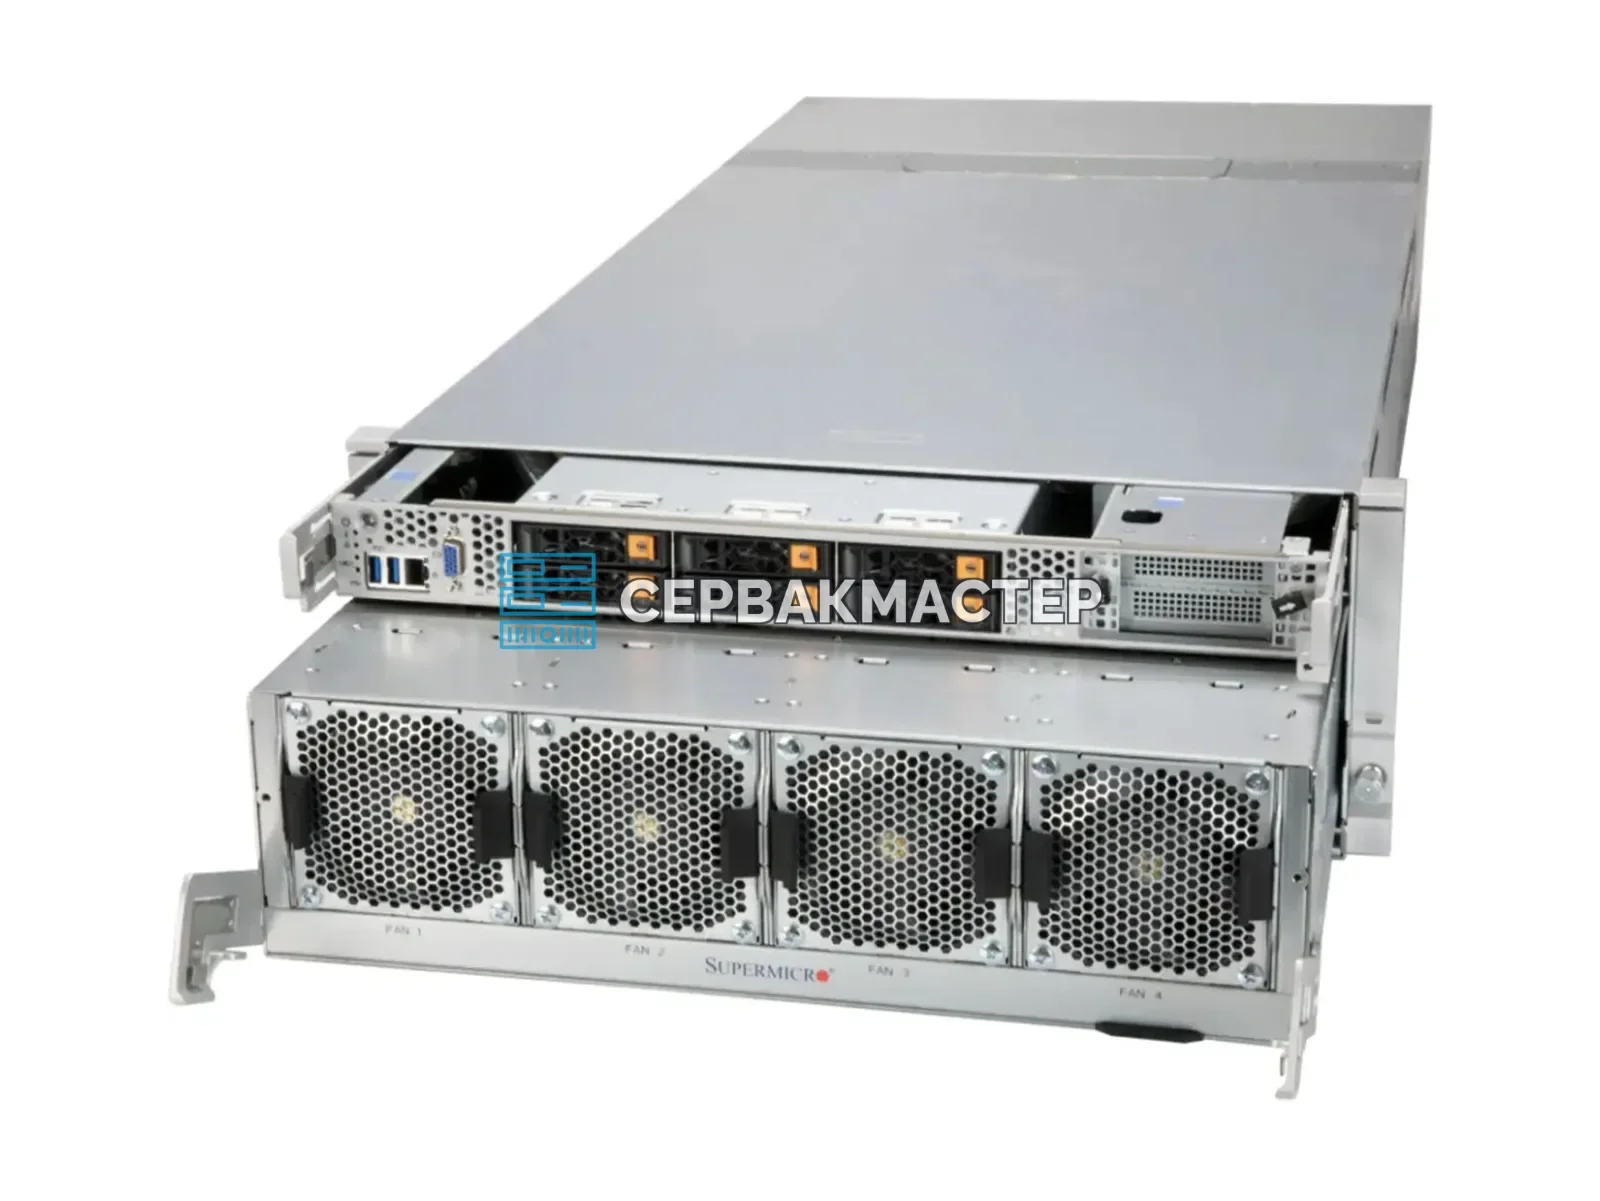
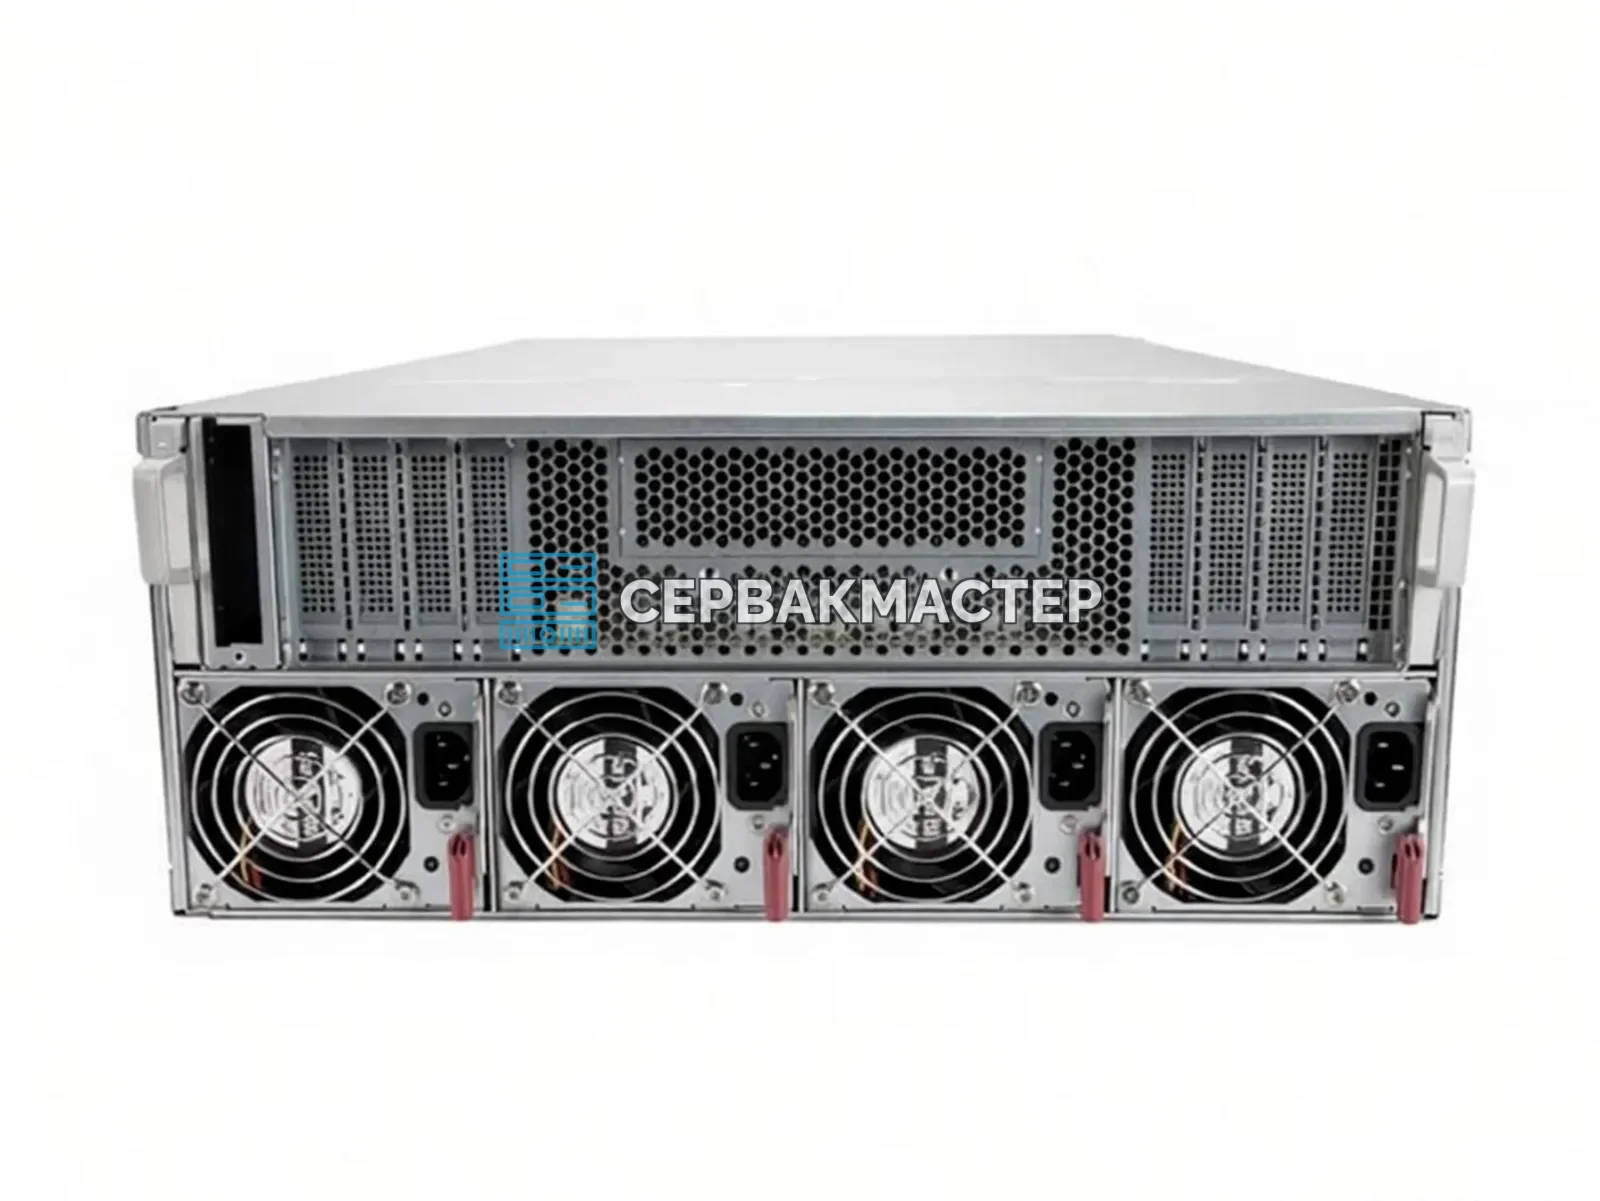
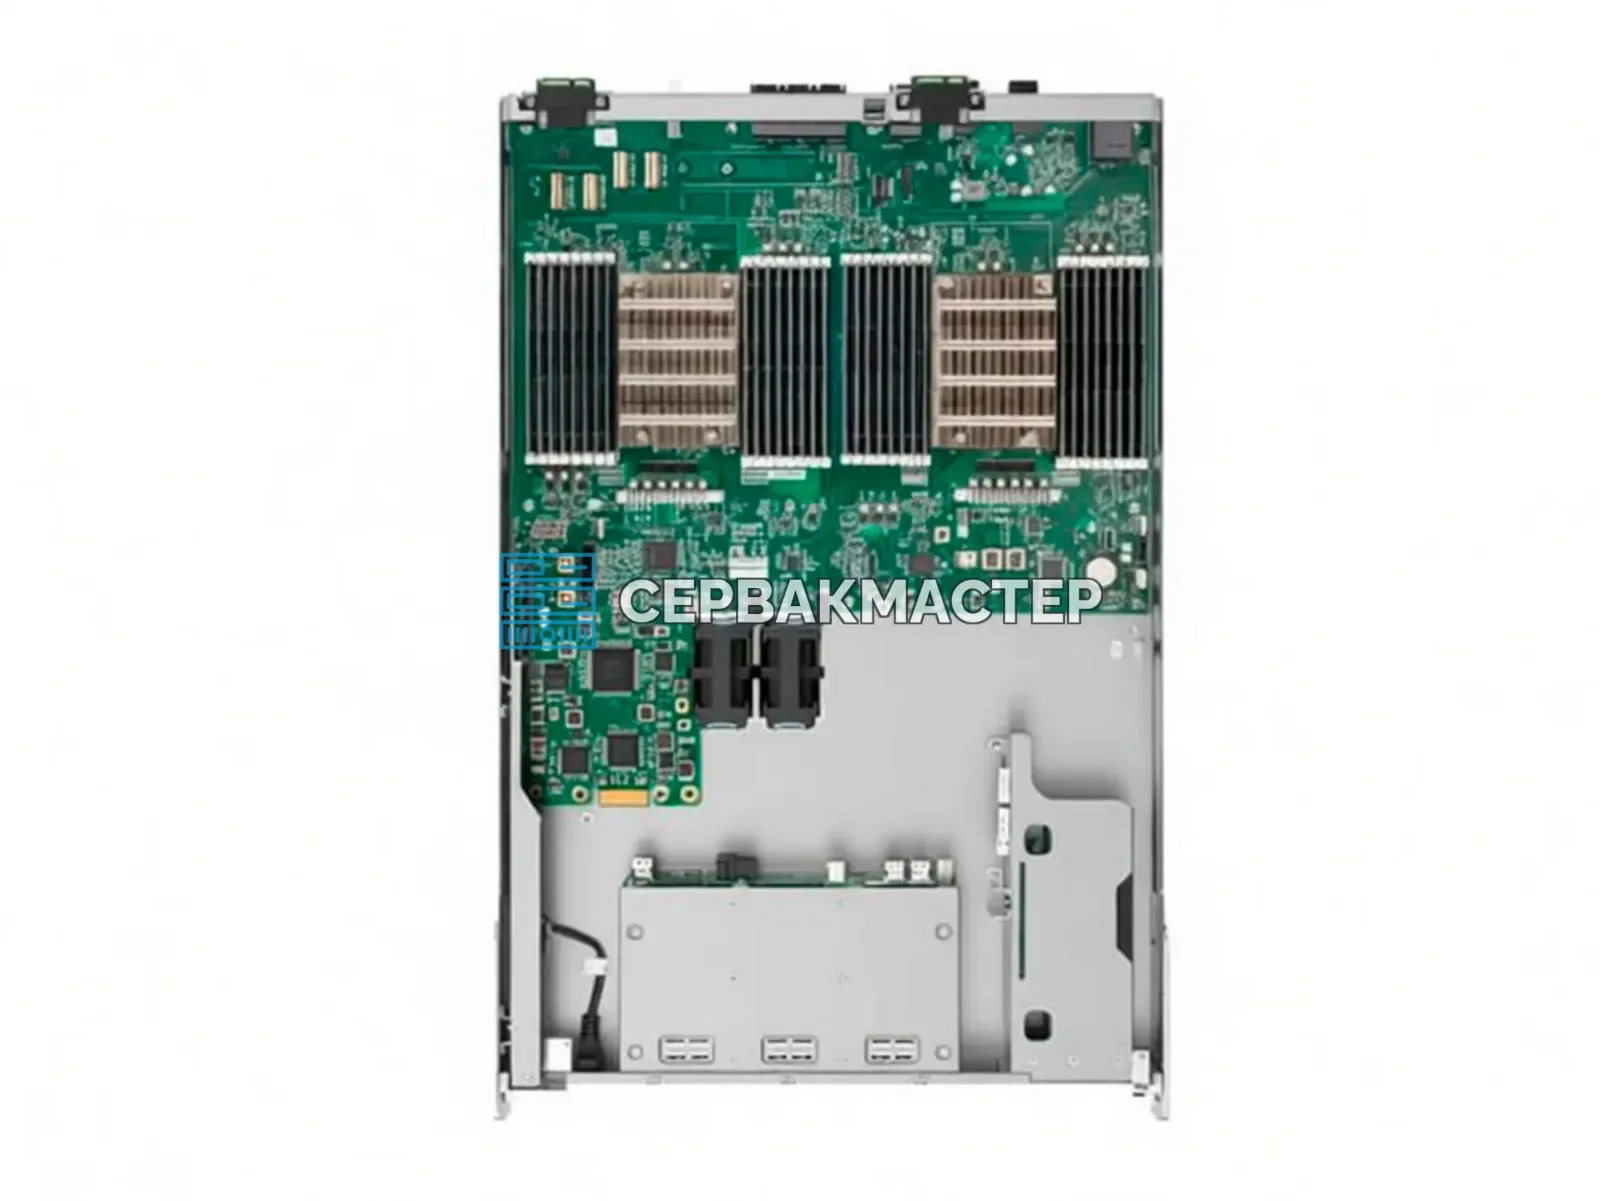

Supermicro AS-4124GO-NART: восемь A100 SXM в одном 4U-корпусе
Supermicro AS-4124GO-NART построен на платформе NVIDIA HGX A100 и объединяет восемь ускорителей A100 в форм-факторе SXM, по 40 ГБ памяти HBM2 у каждого. Суммарно получается 320 ГБ видеопамяти, с которой можно работать как с единым пулом ресурсов для крупных моделей.
Это система для команд, которым одной-двух видеокарт уже не хватает: обучение и дообучение нейросетей, промышленный инференс языковых моделей, RAG-системы и научные расчёты. Ускорители связаны через NVLink v3 и NVSwitch, поэтому обмен данными между GPU идёт с высокой связанностью.
Ключевые особенности
- Платформа HGX A100 с 8 GPU SXM и общим объёмом видеопамяти 320 ГБ.
- Связь между ускорителями через NVLink v3 и NVSwitch, что важно при масштабировании на несколько GPU.
- Поддержка GPUDirect RDMA в схеме «1 GPU на 1 сетевой адаптер» для распределённого обучения и обмена данными между узлами.
- Два процессора AMD EPYC 7002/7003 в Dual Socket SP3.
- Registered ECC DDR4-3200 в 32 слотах DIMM, максимум до 8 ТБ.
- Шесть hot-swap отсеков 2.5" NVMe, при установке дополнительных задних корзин возможно до 10× U.2 NVMe.
- Два слота M.2 NVMe PCIe 3.0 (2280, 22110).
- Режимы смешанной точности для ускорения типичных AI-нагрузок.
Характеристики
| Параметр | Значение |
|---|---|
| Бренд и модель | Supermicro AS-4124GO-NART |
| Состояние | Новое |
| Форм-фактор | 4U |
| Ускорители | 8× NVIDIA A100 SXM 40GB HBM2 |
| Общая видеопамять | 320 ГБ |
| Процессоры | 2× AMD EPYC 7002/7003 (SP3) |
| Оперативная память | до 8 ТБ DDR4 ECC REG, 32 DIMM |
| Накопители | 6× hot-swap 2.5" NVMe, опционально до 10× U.2 NVMe |
| Дополнительно | 2× M.2 NVMe PCIe 3.0 (2280, 22110) |
| Межсоединение GPU | NVLink v3 + NVSwitch |
Совокупная производительность восьми A100 по паспортным данным: FP64 Tensor Core 156 TFLOPS, TF32 Tensor Core 2 496 TFLOPS, BF16/FP16 Tensor Core 4 992 TFLOPS, INT8 Tensor Core 9 984 TOPS.
Для каких задач подходит
- Обучение и дообучение моделей. Плотная 8-GPU связка позволяет распределять нагрузку и масштабироваться по нескольким ускорителям.
- Инференс LLM. Модель вроде DeepSeek-R1-Distill-Llama-70B (около 141 ГБ VRAM) размещается на нескольких GPU с запасом под KV-cache. Для gpt-oss:120b в FP16 (около 260 ГБ) комфортнее использовать 4–8 GPU. Квантизированные Qwen3.5-397B-A17B (Q4_K_M, около 241 ГБ) и GLM-4.7 (Q4_K_M, около 216 ГБ) также помещаются в 320 ГБ.
- Генерация изображений и видео. Stable Diffusion XL, Flux.2-dev, Kandinsky-5.0 удобно распараллеливать по восьми GPU ради высокой пропускной способности.
- RAG-системы и корпоративные ассистенты, анализ данных и HPC-расчёты.
Состояние, проверка и поставка
Сервер поставляется новым. Перед отправкой «СервакМастер» тестирует оборудование, на него предоставляется гарантия 1 год с заменой компонентов. Доставка по России осуществляется СДЭК и другими ведущими службами доставки. Если нужна конфигурация на эту платформу под ваши задачи и бюджет, свяжитесь с менеджером, и мы подберём подходящий вариант.
Характеристики
| Тип | Новые |
| Основная задача | Обучение моделей / Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) |
| Процессор (CPU) | AMD EPYC |
| Видеокарта (GPU) | NVIDIA A100 |
| Количество GPU, шт | 8 |
| Общий объем видеопамяти (VRAM), ГБ | 320 |
| Тип памяти GPU | HBM2 |
| Объем оперативной памяти (RAM), ГБ | 8192 |
| Тип оперативной памяти | DDR4 ECC REG |
| Форм-фактор | 4U |