
Сервер Supermicro ARS-111GL-SHR на NVIDIA GH200: 96 ГБ HBM3, 480 ГБ LPDDR5X, 1U

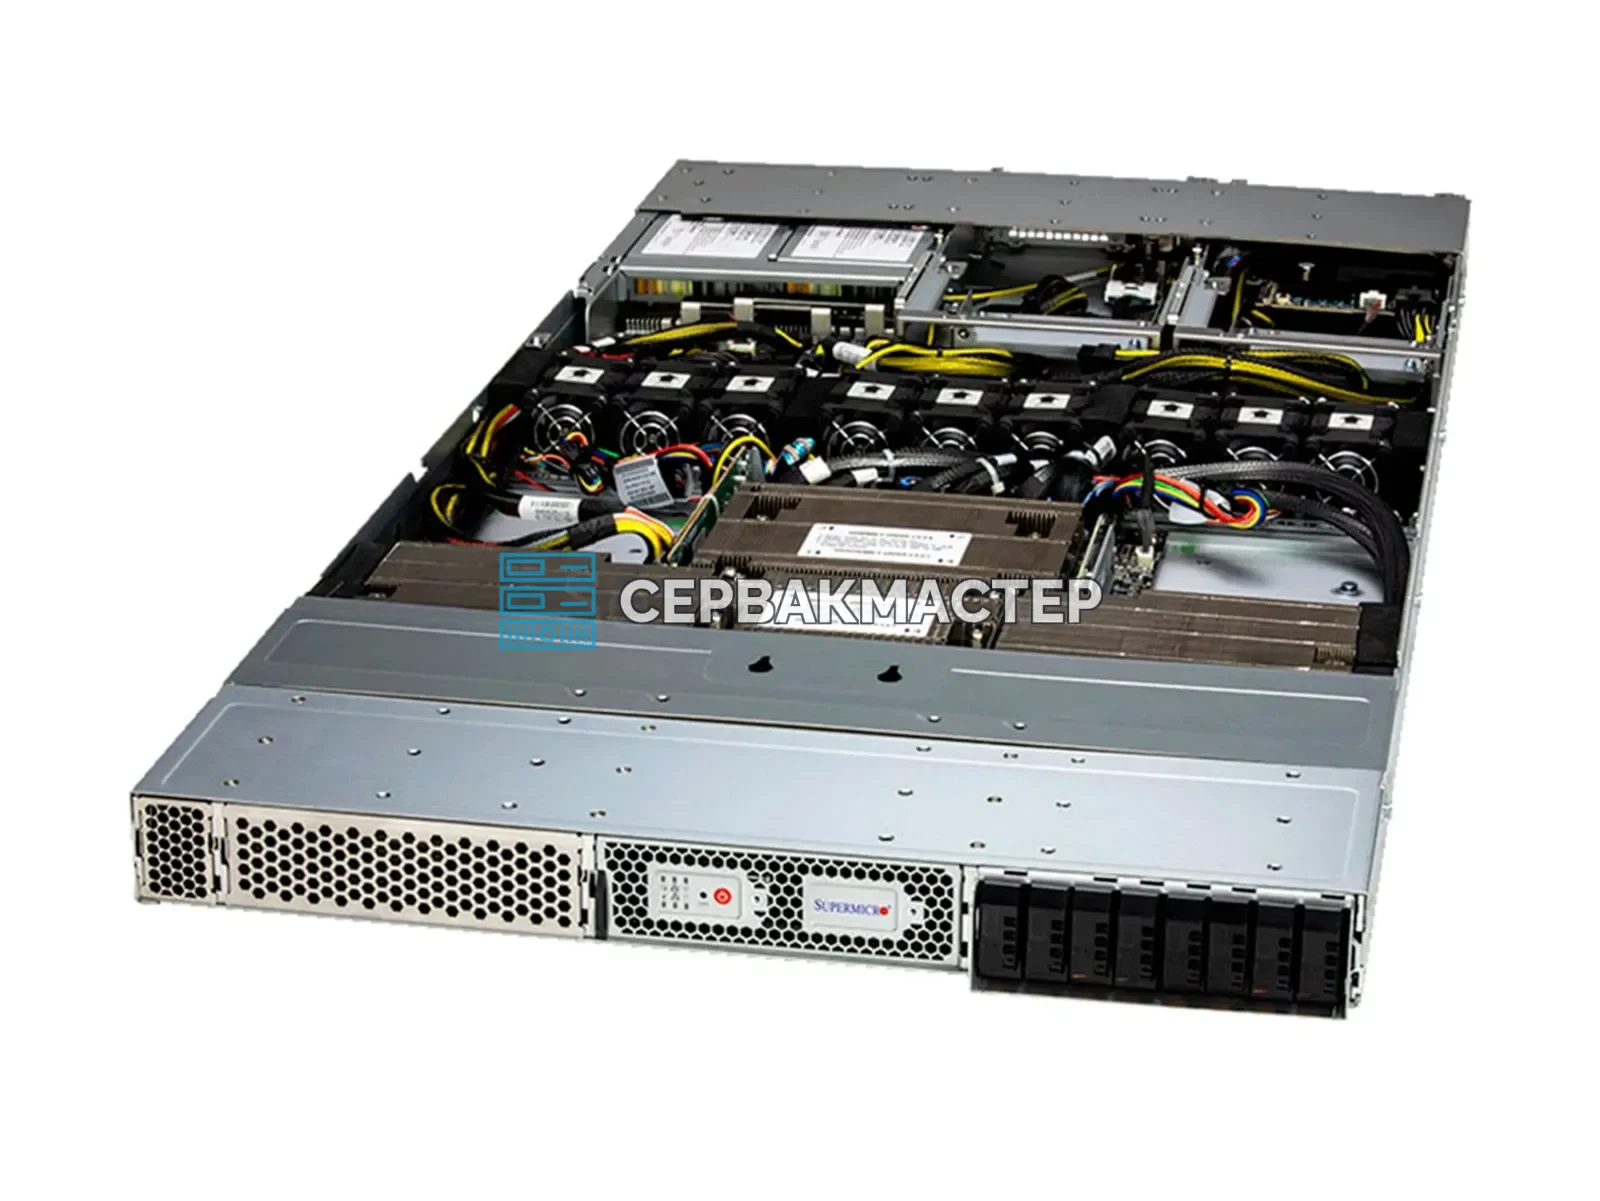
Supermicro ARS-111GL-SHR: компактная платформа на базе NVIDIA GH200
Supermicro ARS-111GL-SHR — это серверная платформа в корпусе 1U, построенная вокруг одного суперчипа NVIDIA GH200 Grace Hopper. В одном модуле объединены 72-ядерный процессор NVIDIA Grace и ускоритель архитектуры Hopper, поэтому у системы нет классического разделения на «процессор плюс отдельная видеокарта»: вычислительные блоки работают с общей быстрой памятью.
Конфигурация включает 96 ГБ ECC HBM3 на стороне ускорителя и 480 ГБ ECC LPDDR5X на стороне Grace. Такое сочетание полезно там, где важен не только объём видеопамяти, но и большой пул быстрой памяти рядом с GPU: для крупных моделей, длинного контекста и ресурсоёмких расчётов.
Ключевые особенности
- Один модуль NVIDIA GH200: процессор Grace и GPU Hopper в одном суперчипе.
- 96 ГБ видеопамяти HBM3 с ECC.
- 480 ГБ оперативной памяти LPDDR5X с ECC.
- Форм-фактор 1U — высокая плотность размещения в стойке.
- Фронтальные отсеки: 8 hot-swap накопителей E1.S NVMe для быстрого локального хранилища.
- Два слота M.2 NVMe (M-key), например под системные носители.
- От версии NHR модель отличается подсистемой накопителей: в SHR предусмотрено 8 слотов E1.S.
Характеристики
| Параметр | Значение |
|---|---|
| Платформа | Supermicro ARS-111GL-SHR |
| Состояние | Новое |
| Процессор | NVIDIA GH200 (Grace), 72 ядра |
| GPU | NVIDIA GH200 (Hopper), 1 шт. |
| Видеопамять | 96 ГБ HBM3 (ECC) |
| Оперативная память | 480 ГБ LPDDR5X (ECC) |
| Накопители | 8x E1.S NVMe (hot-swap) |
| Дополнительные накопители | 2x M.2 NVMe (M-key) |
| Форм-фактор | 1U |
Для справки, пиковая производительность GH200 по типам точности: FP8 Tensor Core — 3958 TFLOPS, BF16/FP16 Tensor Core — 1979 TFLOPS, TF32 Tensor Core — 989 TFLOPS, FP32 и FP64 Tensor Core — по 67 TFLOPS, INT8 Tensor Core — 3958 TOPS.
Для каких задач подходит
- Инференс языковых моделей. Платформа рассчитана на модели среднего и крупного размера: например, DeepSeek-R1-Distill-Qwen-32B (около 65,5 ГБ VRAM), Gemma-4-31B-it (около 62,6 ГБ) и gpt-oss-120b в квантизации Q4_K_M (около 62,8 ГБ) помещаются в 96 ГБ с запасом под контекст. Qwen3.5-35B-A3B требует около 71,9 ГБ, поэтому лучше использовать умеренный контекст и аккуратный размер батча.
- Дообучение моделей и RAG-системы, где нужен большой объём быстрой памяти.
- Генерация изображений и видео: подходят Stable Diffusion 3.5 Medium, FLUX.2-klein-9B, Kandinsky-5.0 (текст в изображение и короткое видео).
- Анализ данных и научные расчёты (HPC).
Состояние, проверка и поставка
Сервер поставляется новым. Перед отправкой «СервакМастер» тестирует оборудование, на него действует гарантия 1 год с заменой компонентов. Доставка по России осуществляется через СДЭК и другие ведущие службы. Если нужна конфигурация под ваши задачи и бюджет, свяжитесь с менеджером — мы подберём подходящий вариант.
Характеристики
| Тип | Новые |
| Основная задача | Инференс / Дообучение моделей / RAG-системы / Анализ данных / Научные расчеты (HPC) |
| Процессор (CPU) | NVIDIA GH200 (Grace) |
| Видеокарта (GPU) | NVIDIA GH200 (Hopper) |
| Количество GPU, шт | 1 |
| Общий объем видеопамяти (VRAM), ГБ | 96 |
| Тип памяти GPU | HBM3 |
| Объем оперативной памяти (RAM), ГБ | 480 |
| Тип оперативной памяти | LPDDR5x |
| Форм-фактор | 1U |