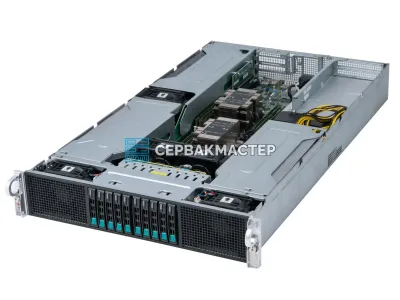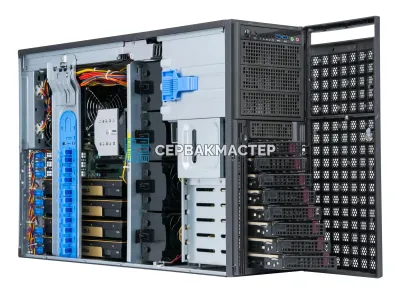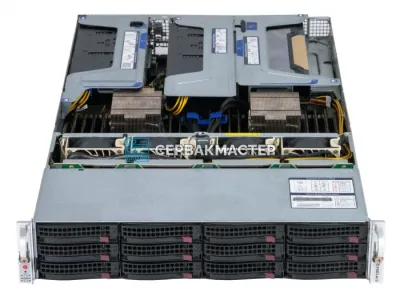
Нет в наличии
- ТипБ/У
- Основная задачаИнференс / Дообучение моделей / RAG-системы
- Процессор (CPU)AMD EPYC
Нет в наличии
Нет в наличии
Нет в наличии
Qwen 2.5 — линейка открытых языковых моделей от Alibaba Cloud, объединяющая варианты от лёгкого 0,5B до масштабного 405B. Семейство демонстрирует сильные результаты в генерации и анализе кода, многоязычном переводе, обработке длинных контекстов и аналитике структурированных данных. Запуск этих моделей в продакшне требует продуманного подбора серверной платформы: нехватка GPU-памяти или узкое межузловое соединение немедленно сказываются на задержке и пропускной способности.
В каталоге «СервакМастер» представлены одноузловые GPU-серверы, многоузловые кластерные решения и интегрированные AI-стойки, подобранные с учётом реальных требований инференса Qwen 2.5.
Инференс LLM — принципиально иная задача по сравнению с обучением. Перечислим факторы, которые определяют выбор оборудования:
Наиболее востребованный класс для развёртывания моделей Qwen 2.5 в диапазоне 7B–72B:
При batch size ≥ 256 или необходимости обслуживать сотни одновременных запросов рекомендуется распределённый инференс:
Для разработки, тестирования и edge-инференса подойдут более доступные платформы:
Серверы из каталога «СервакМастер» совместимы с ведущими открытыми фреймворками:
| Фреймворк | Ключевые особенности | Рекомендуемый GPU |
|---|---|---|
| vLLM | PagedAttention, continuous batching, OpenAI-совместимый API | H100, A100, L40S |
| TGI (Text Generation Inference) | Flash Attention 2, tensor parallelism, квантизация GPTQ/AWQ | H100, A100 |
| llama.cpp (CUDA backend) | INT4/INT8 квантизация, минимальные требования к VRAM | RTX 4090, L40S |
| TensorRT-LLM | Максимальная производительность на оборудовании NVIDIA, INT8/FP8 | H100 SXM, A100 SXM |
| DeepSpeed-FastGen | MII-ядра, speculative decoding, высокий throughput | H100, A100 |
Задача: продакшн-инференс Qwen 2.5 72B, 100 одновременных пользователей, задержка первого токена — не более 2 с.
Рекомендация «СервакМастер»:
Если бюджет ограничен, рассмотрите INT4 GPTQ-квантизацию: в этом режиме модель 72B занимает около 40 ГБ — она помещается в один узел с 2× H100 80 ГБ или 4× A100 40 ГБ.
Какой GPU лучше для инференса Qwen 2.5 72B? Приоритетный выбор — NVIDIA H100 SXM5 80 ГБ: восемь таких карт в одном узле вмещают модель целиком в BF16 и обеспечивают низкую задержку за счёт NVLink 4.0. При ограниченном бюджете подойдут NVIDIA A100 80 ГБ или L40S 48 ГБ с INT4-квантизацией.
Реально ли запустить Qwen 2.5 405B на одном сервере? Технически — да, при суммарном объёме VRAM не менее 800 ГБ (например, несколько узлов DGX H100, объединённых через NVSwitch). На практике для 405B чаще применяется распределённый инференс на 2–4 узлах с tensor-параллелизмом.
Поддерживается ли квантизация на рекомендуемых серверах? Да. Все конфигурации совместимы с GPTQ, AWQ, GGUF (llama.cpp), а также с нативными режимами INT8/FP8 в TensorRT-LLM и vLLM. Квантизация до INT4 снижает потребление VRAM примерно в 4 раза по сравнению с FP16.
Сколько ждать оборудование? Серверы из наличия отгружаем за 1–3 рабочих дня. Конфигурации под заказ (нестандартные сборки, крупные партии) — от 2 до 6 недель в зависимости от наличия компонентов у производителя. Точные сроки уточняйте у менеджеров «СервакМастер».