Нет в наличии
- ТипНовые
- Основная задачаИнференс / Дообучение моделей / RAG-системы / Анализ данных / Визуализация и рендеринг
- Процессор (CPU)AMD EPYC
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
Нет в наличии
DeepSeek R1 32B — открытая языковая модель с 32 миллиардами параметров, которая занимает особое место среди решений для корпоративного ИИ. Она демонстрирует качество рассуждений и генерации текста на уровне ведущих коммерческих моделей, но при этом полностью доступна для локального запуска без зависимости от сторонних API. «СервакМастер» предлагает тщательно подобранные серверные платформы, позволяющие развернуть DeepSeek R1 32B эффективно и надёжно.
Модель пользуется устойчивым спросом в самых разных отраслях. Среди основных сценариев:
Объём видеопамяти — ключевой параметр при выборе платформы для DeepSeek R1 32B.
| Конфигурация | VRAM | Режим работы |
|---|---|---|
| 1× NVIDIA H100 80 ГБ SXM | 80 ГБ | FP16, полная точность |
| 1× NVIDIA A100 80 ГБ | 80 ГБ | FP16, полная точность |
| 2× NVIDIA RTX 4090 | 48 ГБ | FP16 с незначительным оверхедом |
| 1× NVIDIA RTX 4090 | 24 ГБ | INT4/GGUF квантизация |
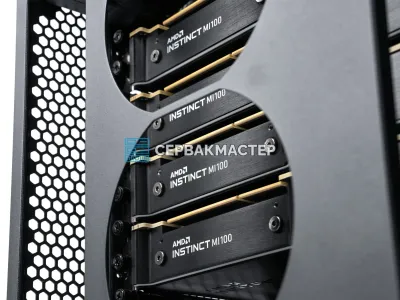
| 2× AMD Instinct MI250X | 128 ГБ | FP16 + запас для батчей |
Мы предлагаем готовые решения на базе проверенных платформ ведущих производителей серверного оборудования.
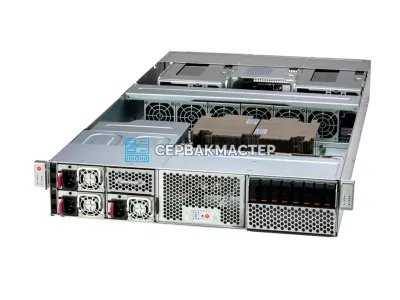
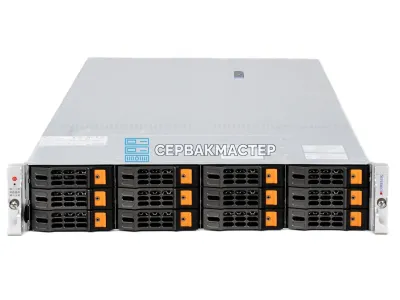
Компактная 2U-система, рассчитанная на установку до 8 GPU в формате PCIe/SXM. Оснащена процессорами Intel Xeon Scalable 4-го поколения, поддерживает до 4 ТБ DDR5 ECC RAM и NVMe SSD с интерфейсом PCIe 5.0.
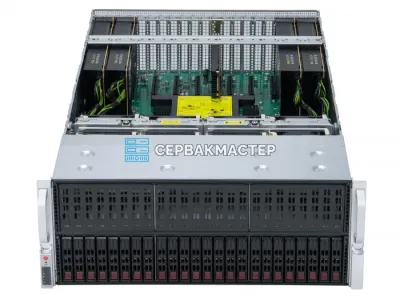
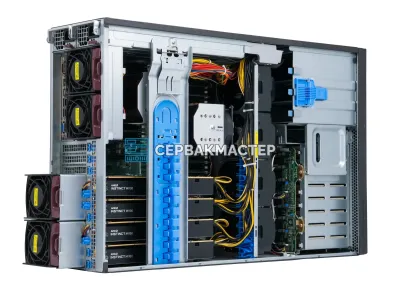
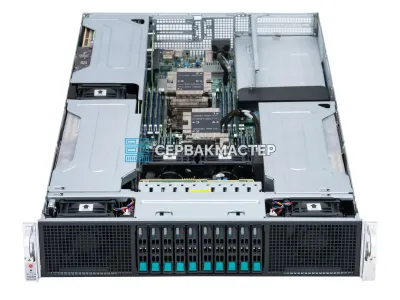
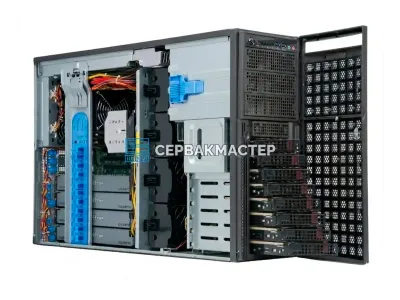
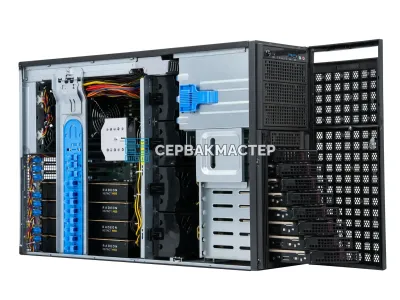
Серверная платформа форм-фактора 4U на процессорах AMD EPYC 9004 (Genoa). Поддерживает до 8 двусторонних полноразмерных GPU. Усиленная система охлаждения обеспечивает стабильную тактовую частоту при длительной непрерывной нагрузке.
Решение корпоративного класса, оптимизированное для задач машинного обучения и генеративного ИИ. Форм-фактор 8U, штатная поддержка 8 GPU NVIDIA HGX H100 с NVLink.
DeepSeek R1 32B поддерживает несколько схем квантизации для экономии видеопамяти без существенного снижения качества:
| Фреймворк | Ключевые особенности |
|---|---|
| vLLM | PagedAttention, высокий throughput, поддержка OpenAI-совместимого API |
| llama.cpp | CPU/GPU офлоадинг, широкая поддержка GGUF-форматов |
| Ollama | Простое локальное развёртывание, минимальная настройка |
| TGI (Text Generation Inference) | Серверное решение Hugging Face с потоковой генерацией |
| TensorRT-LLM | Максимальная скорость на NVIDIA GPU за счёт глубокой оптимизации |
Скорость генерации при длине контекста 2048 токенов:
Показатели носят ориентировочный характер и варьируются в зависимости от длины контекста, размера батча, температуры и используемого фреймворка.
«СервакМастер» — специализированный интернет-магазин серверного и AI-оборудования с фокусом на задачи машинного обучения и локального инференса нейросетей.
Чтобы получить коммерческое предложение или уточнить наличие конкретной конфигурации — используйте форму обратной связи или онлайн-чат на сайте.
Можно ли запустить DeepSeek R1 32B на одной видеокарте? Да. При квантизации Q4_K_M (GGUF) модель занимает 20–22 ГБ VRAM и запускается на NVIDIA RTX 4090 (24 ГБ) или аналогичных профессиональных GPU.
Какая операционная система рекомендуется? Большинство фреймворков инференса оптимально работают под Ubuntu 22.04 LTS или Rocky Linux 9. Для TensorRT-LLM рекомендуется официальный контейнер NVIDIA NGC.
Поставляются ли серверы с предустановленным ПО? По запросу «СервакМастер» комплектует системы с предустановленными драйверами NVIDIA, CUDA, cuDNN и выбранным фреймворком — уточняйте при оформлении заказа.
Как масштабировать решение при росте нагрузки? Оптимальный путь — переход на многосерверный кластер с InfiniBand или 100GbE-интерконнектом. Специалисты «СервакМастер» готовы помочь спроектировать архитектуру под ваши требования по latency и throughput.