
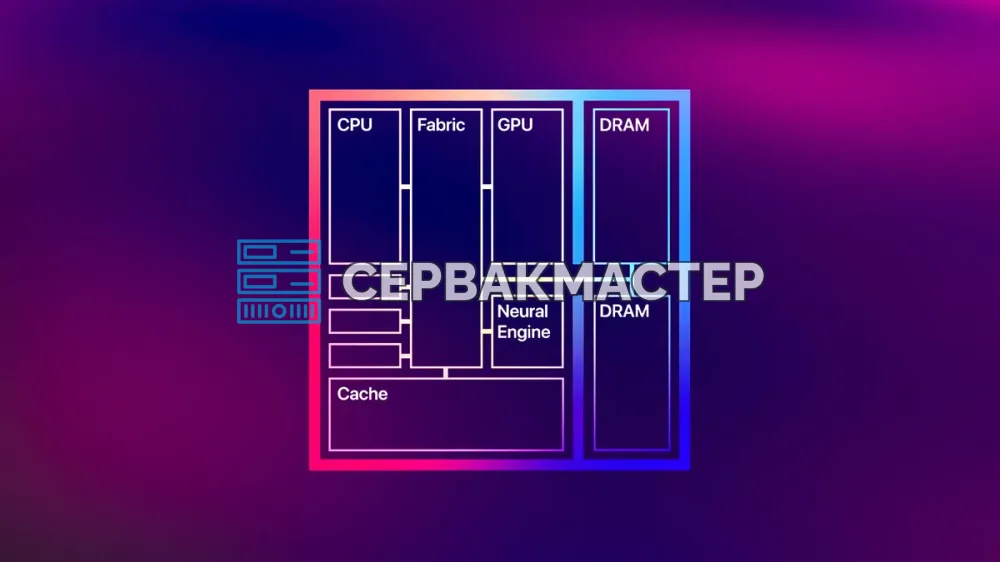
Компактные ИИ-ПК стали заметным трендом последних лет: нейросети класса 100b теперь запускаются на устройстве, которое помещается в углу рабочего стола и по габаритам уступает даже потребительскому NAS. Раньше такое было по силам лишь владельцам серверных или, в крайнем случае, профессиональных GPU. Секрет в технологии унифицированной памяти (Unified Memory), которая позволяет гонять полноразмерные LLM без жёсткой квантизации и архитектурных ухищрений. Ниже разберём, что это за архитектура, откуда она взялась, чем отличается от классической дискретной схемы и кто из производителей уже построил на ней свои платформы.
Что такое унифицированная память
Если отбросить инженерную терминологию, унифицированная память — это схема, в которой системная оперативная память доступна сразу всем вычислительным блокам. CPU, GPU и NPU работают с одним и тем же физическим пулом, видят одни и те же данные, и копировать информацию из одного хранилища в другое им не требуется.
Как устроена классическая схема
Чтобы почувствовать разницу, вспомните обычный ПК. Центральный процессор имеет прямой доступ только к оперативной памяти, а графический — только к собственной видеопамяти. Когда вы запускаете нейросеть на видеокарте, драйверу приходится сначала скопировать данные из RAM в VRAM, а после расчёта вернуть результат обратно. Это происходит при каждом инференсе локальной модели.
У такой пересылки через шину PCI Express три неприятных последствия:
- растут задержки, потому что данные тратят время на путь между пулами;
- растёт энергопотребление, ведь каждое копирование стоит энергии;
- размер модели ограничен именно объёмом видеопамяти, поскольку RAM и VRAM изолированы друг от друга.
Практический пример: при видеокарте на 16 ГБ модель весом 20 ГБ просто не загрузится, даже если в системе установлено 128 ГБ оперативной памяти.
Что меняет единый пул
Унифицированная память решает всё это радикально: вся память объединяется в один большой пул (LPDDR или, реже, DDR), к которому обращаются ядра CPU, GPU и NPU. Чипам не нужно перебрасывать друг другу данные, они берут нужное напрямую. Поэтому задержки сводятся к минимуму, а TDP не растёт лавинообразно.
Распределением можно управлять вручную. В BIOS всех систем с такой концепцией есть опция, определяющая, сколько памяти получит каждый блок. Хотите отдать графике все 128 ГБ, оставив процессору минимум? Это настраивается.
История идеи
Единое адресное пространство для CPU и GPU инженеры обсуждали ещё в девяностых, но упирались в техпроцессы и стоимость реализации. Путь к современной архитектуре прошёл несколько этапов.
Интегрированная графика и Shared Memory
Первыми шагами стали встроенные графические процессоры Intel и AMD. Например, во встройке Intel HD часть медленной системной оперативной памяти «откусывалась» под нужды графики. Эта технология называлась Shared Memory (общая память) и заметно тормозила систему: обычная DDR была слишком медленной для работы с графикой.
Игровые консоли
Дальше идею развили игровые консоли начала 2010-х. PlayStation 4 и Xbox One использовали единый пул быстрой памяти GDDR5 объёмом 8 ГБ, доступный и процессору, и графическим ядрам. Поначалу решение выглядело странным, но игроки и разработчики быстро оценили эффект: задержки упали до минимума, а игры и программы работали заметно живее. Для ПК, однако, подход всё ещё оставался экзотикой.
CUDA Unified Memory
Затем появилась программная технология Nvidia — CUDA Unified Memory. Она позволяла писать код так, будто у CPU и GPU общая память, но на физическом уровне данные по-прежнему копировались по шине PCIe. По сути, это была имитация настоящей унификации: инструмент удобства для программистов ядер, на задержки он не влиял.
Apple Silicon M1 и первые ИИ-станции
Переломным моментом для массового рынка стал выход процессоров Apple Silicon M1 в 2020 году. Опираясь на опыт мобильных чипов серии A, Apple спроектировала SoC, где восемь (позже больше) ядер CPU, мощный GPU и NPU-движок работают с одним пулом LPDDR4X/LPDDR5, физически распаянным на общей подложке с вычислительными блоками. Ширина шины памяти составляла 128–512 бит в зависимости от модели, а пропускная способность доходила до 400–800 ГБ/с — такими цифрами тогда могли похвастаться только дискретные GPU.
Сначала унифицированная память была скорее маркетинговой фишкой: MacBook Air и Mac Mini получали лишь 16 ГБ общего пула. Когда стал ясен коммерческий потенциал, вышли чипы M2 Ultra, на которых построили первые в индустрии ИИ-ПК — Apple Mac Studio и Apple Mac Pro со 192 ГБ унифицированной памяти. Таким образом, идею компактных ИИ-станций с единой памятью предложила не Nvidia, не AMD и не Intel, а именно Apple.
Ответ конкурентов
После этого подключились остальные:
- Intel применила унифицированную память в Meteor Lake и Lunar Lake;
- AMD использовала единый пул в линейке Ryzen AI;
- Nvidia сначала внедрила Unified Memory в системы серии Jetson для периферии, затем выпустила суперчипы GH200/GB200 с общим пулом памяти HBM3/HBM3E и LPDDR5X, а потом представила компактный DGX Spark, на который нацелилась AMD со своими грядущими Halo Box.
Любопытно, что именно Nvidia первой вывела унифицированную память в корпоративный сегмент. Она объединила на первый взгляд несовместимые типы памяти с помощью проприетарного интерконнекта NVLink C2C — по сути, открыв новый способ использования Unified Memory, который до сих пор никто не повторил.
Унифицированная и дискретная память: сравнение
Чтобы расставить точки над i, сопоставим две архитектуры по ключевым параметрам.
| Параметр | Унифицированная память | Дискретная память |
|---|---|---|
| Объём для модели | Почти вся RAM за вычетом нужд ОС и приложений | Ограничен объёмом VRAM видеокарты |
| Пропускная способность | LPDDR5X: 400–800 ГБ/с | HBM у топовых GPU: терабайты в секунду |
| Копирование через PCIe | Не требуется | Обязательно |
| Энергоэффективность | Выше, особенно при распайке рядом с чипом | Данные идут по длинным линиям PCIe |
| Апгрейд | Чаще всего невозможен (память распаяна) | Память и видеокарту можно менять отдельно |
Общий пул
В дискретной системе вы привязаны к фиксированному объёму видеопамяти. Купили карту на 24 ГБ — модель на 30 ГБ не запустится, даже если системной памяти 128 ГБ и она свободна. Унифицированная архитектура позволяет отдать GPU или NPU практически всю доступную RAM (за вычетом занятой ОС и приложениями). При 128 ГБ на борту можно выделить 64 ГБ под модель, а этого достаточно для инференса топовых нейросетей с 70+ миллиардами параметров. Для локального запуска LLM на компактных ИИ-ПК это решающий фактор.
Пропускная способность
Тут картина неоднозначнее. Топовые дискретные GPU используют специализированную память вроде HBM со скоростью в терабайты в секунду. Унифицированная память на базе LPDDR5X достигает 400–800 ГБ/с. Для большинства задач инференса этого хватает, но профессиональным и особенно дата-центровым флагманам она уступает. При обучении больших моделей высокая пропускная способность критична, а для инференса важнее объём. Кроме того, отсутствие задержек на копирование через PCIe частично компенсирует более низкую скорость.
Энергоэффективность
Каждый лишний акт копирования между чипами расходует энергию. Дискретным системам приходится гонять данные по длинным линиям PCIe на материнской плате. Унифицированной памяти на перемещение данных нужно заметно меньше энергии, особенно когда она распаяна рядом с процессором.
Стоимость и гибкость
Здесь преимущество у дискретных систем: память и видеокарту можно наращивать и менять по отдельности. Это удобно энтузиастам и серверному сегменту, где нагрузки постоянно растут. Унифицированные платформы почти всегда поставляются с распаянной памятью, которую увеличить нельзя.
Программная модель
Для разработчиков унифицированная память — настоящий подарок. Вместо ручного управления копированием между хостом и устройством (как cudaMemcpy в CUDA) можно один раз выделить буфер и использовать его в любых контекстах.
Кто использует унифицированную память
Сегодня это уже не экзотика, а стандарт де-факто для устройств, претендующих на звание ИИ-оборудования.
Nvidia
Компания применяет унифицированную память LPDDR5/X в системах серий Jetson Orin и Nano, а также во всех корпоративных суперчипах — от Grace Hopper до Vera Rubin. Самый известный представитель концепции в её ассортименте — компактный ИИ-ПК DGX Spark на чипе GB10. В нём CPU Grace и GPU Blackwell делят единый пул в 128 ГБ памяти LPDDR5X, что позволяет запускать крупные LLM объёмом до 120B.
AMD
Unified Memory есть в APU линейки Ryzen AI. Наиболее актуальны Ryzen AI Max+ 395, объединяющие процессор Zen 5, графику RDNA 3.5 и NPU XDNA2. Грядущие ИИ-боксы на этих чипах получат до 128 ГБ общей памяти LPDDR5X, из которых до 64 ГБ можно выделить для GPU. Кроме того, AMD анонсировала следующее поколение, Ryzen AI Max+ 400, с пулом унифицированной памяти до 192 ГБ и возможностью отдать графике до 160 ГБ.
Apple
Unified Memory Apple внедряет во все десктопные и профессиональные SoC линеек Pro/Max/Ultra. Так, прежде Mac Studio на процессорах M3 Ultra предлагался с памятью LPDDR5 объёмом до 192 ГБ, что позволяло инференсить огромные нейросети при условии поддержки программным стеком Metal. Однако из-за дефицита памяти компания урезала конфигурации станции, оставив версии Mac Studio лишь на 92 ГБ, а этого явно недостаточно для конкуренции с другими ИИ-ПК.
Выводы и практические рекомендации
Унифицированная память — едва ли не главный компонент современных домашних инференс-станций: именно она закрыла две фундаментальные проблемы логического вывода LLM на потребительских устройствах — высокую задержку и нехватку VRAM. Недостатки тоже есть: распаянные чипы ограничивают апгрейд, а пропускная способность пока уступает топовым дискретным решениям. Но тренд очевиден: с каждым поколением растут скорость (LPDDR6 не за горами), объём и эффективность. Все основные игроки уже сделали ставку на эту архитектуру, и на ней будут строиться ИИ-ПК следующего поколения.
Что это значит при выборе оборудования:
- для экспериментов с локальными нейросетями смотрите не только на бренд GPU, но и на наличие Unified Memory;
- если приоритет — запуск крупных моделей в компактном корпусе, ориентируйтесь на объём единого пула;
- если нужны масштабируемость, замена компонентов и максимальная пропускная способность для обучения, дискретные GPU в серверной платформе остаются разумным выбором.
Подобрать конфигурацию под вашу задачу поможет «СервакМастер»: присмотритесь к разделам серверов и ИИ-серверов, а с вопросами по выбору обращайтесь на страницу контактов.