
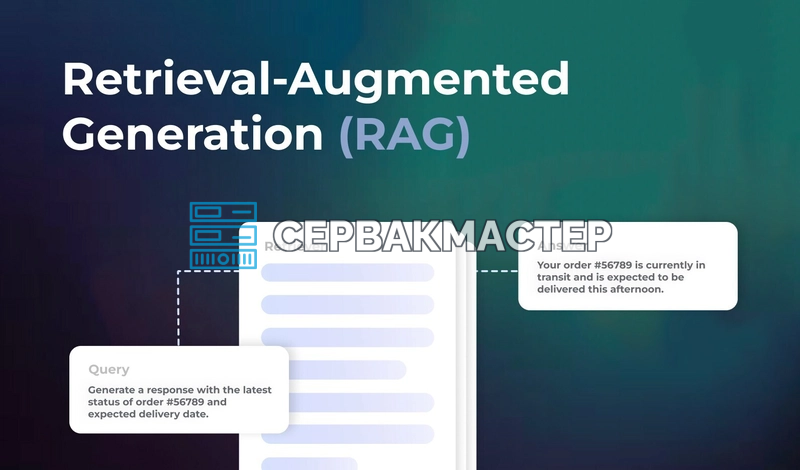
Искусственный интеллект в 2026 году встроен почти во все бизнес-процессы: от общения с клиентами и генерации контента до предиктивной аналитики и управления персоналом. Некоторые руководители уже делегируют ИИ часть своих обязанностей. Но фундаментальные ограничения больших языковых моделей никуда не делись: они ограничены исходными тренировочными данными, быстро устаревают и склонны к галлюцинациям. Для частного пользователя это почти безобидно, а для компании ошибка, например при анализе документации, может обернуться убытками и даже крахом бизнеса. Решением, которое стало стандартом оптимизации работы ИИ, считается RAG (Retrieval-Augmented Generation). Ниже разберём, что это такое, как устроено, где применяется и как будет развиваться.
Что такое RAG
Если коротко, RAG — это архитектурный подход, при котором перед генерацией текста модель получает релевантную информацию из внешнего источника, например из корпоративной базы знаний. Система работает как ассистент: сначала находит в документах нужные факты, затем передаёт их LLM, и та формирует точный ответ, опирающийся на контекст.
RAG и fine-tuning
Главное отличие от дообучения (fine-tuning) — скорость и стоимость. Fine-tuning требует значительных вычислительных ресурсов и много времени на адаптацию модели под новые задачи. RAG не меняет внутренние веса и архитектуру LLM: он работает с данными снаружи.
RAG и длинный контекст
Может показаться, что RAG не нужен, раз существуют LLM с очень длинным контекстом. Но длинное окно позволяет модели «запомнить» новые данные лишь временно: когда контекст израсходован, это своеобразное микро-дообучение придётся повторять. К тому же модели с окном в 1 миллион токенов и выше очень требовательны к вычислительным ресурсам, а когда появятся ИИ с окном в 2 миллиона токенов, вашей VRAM может просто не хватить. RAG лишён этих недостатков: ему не нужно много дополнительных ресурсов, а актуальные данные он подмешивает в запрос.
RAG и CAG
Параллельно развиваются смежные идеи, одна из которых — CAG (Cache-Augmented Generation). Она ускоряет работу модели за счёт кэширования часто запрашиваемых фрагментов данных с помощью механизмов вроде KV-cache. RAG и CAG не конкурируют: оба метода повышают эффективность LLM и дополняют друг друга в разных бизнес-задачах.
Как RAG работает на практике
Архитектура RAG реализуется как последовательный пайплайн из нескольких этапов.
- Загрузка и предобработка (чанкинг). Исходные данные — PDF, Word-документы, веб-страницы, отчётные таблицы — разбиваются на логические фрагменты оптимального размера, чанки, очищаются от лишнего форматирования и приводятся к единой структуре. Так системе проще искать нужное.
- Векторизация. Специальная эмбеддинговая модель превращает каждый чанк в вектор — последовательность чисел, отражающую семантику фрагмента. Смысл отдельного вектора определяется его положением относительно других векторов.
- Векторная база. Векторы складываются в специализированное хранилище: Pinecone, Qdrant, Milvus, FAISS или Chroma. Такие базы оптимизированы для быстрого поиска данных вектора и соседних с ним векторов.
- Поиск и извлечение контекста. Запрос пользователя тоже преобразуется в вектор, что нужно для эффективного поиска в векторном пространстве. Для точности часто используют гибридный поиск, сочетающий векторный и классический ключевой (например, по алгоритму BM25), а также техники переранжирования вроде HyDE или MMR, которые фильтруют и улучшают итоговый набор документов.
- Генерация ответа. Найденные фрагменты формируют контекст, который вместе с вопросом уходит в большую языковую модель. Ей дают инструкцию отвечать строго на основе этого контекста. Здесь важен KV-cache: он хранит промежуточные вычисления, заметно ускоряет инференс и делает RAG-систему отзывчивее.
В итоге ответ — это не просто результат «внутренних знаний» модели, а синтез наиболее релевантной информации из проверенного внешнего источника.
Чем RAG полезен бизнесу и разработчикам
Меньше галлюцинаций
Главный плюс — радикальное снижение галлюцинаций. Система заточена на поиск информации и повышение релевантности данных, поэтому модели не приходится выдумывать недостающее, а точность ответов растёт. Это особенно важно там, где цена ошибки высока: в юридическом консалтинге, технической поддержке, финансовой аналитике.
Свежие данные без переобучения
Второе ключевое преимущество — прямой доступ к самым свежим данным. Компания обновляет базу знаний, и уже через несколько минут чат-бот оперирует новой информацией, без полного переобучения и дополнительных вычислительных затрат. Источниками могут быть как внутренние корпоративные системы, так и внешние платформы: архитектура RAG обрабатывает любые типы данных, убирает лишние элементы и передаёт нейросети чистый текст. Это пока не автоматическое обучение, которое прогнозируют многие аналитики ИИ-индустрии, но и такой подход заметно расширяет датасет модели и кратно повышает её пригодность для корпоративных задач.
Примеры использования
- Интеллектуальные корпоративные чат-боты, отвечающие на внутренние вопросы сотрудников по актуальным инструкциям и регламентам.
- Автоматизация аналитики: система по свежим отчётам сама готовит информационные сводки для руководства и аналитиков.
- Генерация документации и текстового контента по продукту, всегда соответствующего актуальной информации о нём.
- Быстрое создание ИИ-приложений без глубокой экспертизы в тонкой настройке моделей — на готовых API для эмбеддингов и векторных баз.
RAG в экосистеме LLM
В 2026 году RAG перестал быть экзотикой и встроен в популярные инструменты. Для локальных экспериментов и развёртывания подходят Ollama, LM Studio и llama.cpp: они запускают мощные модели на собственном железе, и к ним легко подключить RAG. Например, Open WebUI предлагает функциональность RAG практически из коробки, с удобным интерфейсом для загрузки документов и диалога с моделью по ним.
Для промышленных решений используются высокопроизводительные движки инференса — vLLM и Triton Inference Server. Они рассчитаны на тысячи запросов в секунду, а тесная интеграция с KV-cache делает RAG в продакшене стабильным и экономичным. В таких средах особенно заметна синергия: RAG отвечает за релевантность данных, а CAG — за скорость их доставки и обработки, компенсируя ограничения по длине контекста у некоторых моделей.
Что это значит для выбора железа
Локальный RAG — это сразу несколько нагрузок: эмбеддинги, векторная база и инференс LLM. Для первого и второго обычно достаточно серверного процессора с большим объёмом оперативной памяти, а для третьего важны GPU и объём VRAM, который, как показывает пример длинных контекстов, быстро становится узким местом. Если вы планируете собственный контур на базе Ollama, vLLM или Triton, готовые варианты можно посмотреть в разделах серверы и серверы для ИИ, а подобрать конфигурацию под вашу задачу помогут специалисты «СервакМастер» на странице контактов.
Будущее RAG: Graph-RAG, Agentic RAG, Multimodal RAG
Развитие RAG идёт к большей интеллектуальности и многозадачности моделей.
- Graph-RAG. Вместо плоских текстовых чанков используются графы знаний (например, на платформе Neo4j). Модель лучше понимает сложные связи между сущностями и массивами информации, и глубина аналитики растёт. Microsoft активно развивает собственный фреймворк Microsoft Graph RAG, демонстрируя потенциал подхода.
- Agentic RAG. Система не просто пассивно извлекает данные, а действует как автономный ИИ-агент: сама формулирует подзапросы, выполняет сопутствующие действия (например, SQL-запросы к базам данных) и шаг за шагом углубляется в задачу, используя фреймворки вроде LangChain и LangGraph.
- Multimodal RAG. Выходит за рамки текста и работает с изображениями, визуальными таблицами и аудио, открывая путь к по-настоящему универсальным мультимодальным ассистентам.
RAG постепенно становится ключевым компонентом архитектуры любого агентного ИИ, повышая его функциональность, точность и эффективность.
Выводы
RAG — один из самых рациональных способов сделать большие языковые модели точными и актуальными без больших и регулярных вложений в оборудование для fine-tuning и работы с long-context LLM. Развитие смежных технологий, таких как Cache-Augmented Generation, усиливает позиции RAG, ускоряя и оптимизируя его работу. По сути, RAG — мост между абстрактными знаниями LLM и конкретными верифицированными данными внешнего мира, чего не может ни облачный ChatGPT, ни DeepSeek R1 и подобные модели. В следующих материалах мы подробнее поговорим об оптимизации LLM, использовании фреймворков LangChain и LlamaIndex для построения RAG-пайплайнов и развитии таких систем, как Graph-RAG.