
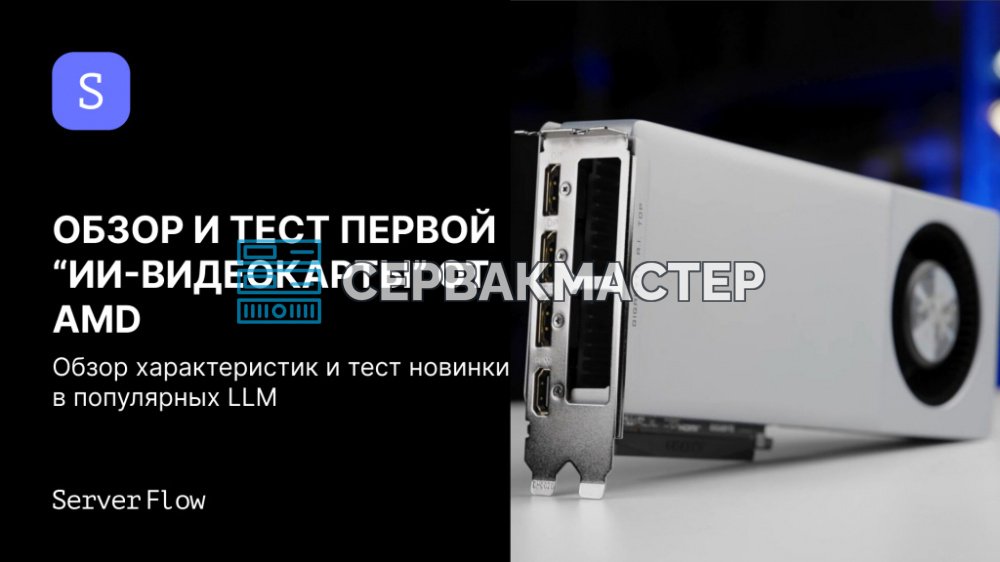
AMD впервые вынесла «AI» прямо в название ускорителя, и GIGABYTE пошла дальше: в имени её версии, Radeon AI PRO R9700 AI TOP, эта приставка встречается дважды. Маркетинг маркетингом, но карта действительно рассчитана на работу с нейросетями, по крайней мере на бумаге. Ниже проверяем, так ли это на практике: смотрим на архитектуру, охлаждение и питание, выясняем, какие движки инференса готовы к RDNA 4, и гоняем 19 языковых моделей под Ubuntu 24.04.4 LTS.
Архитектура и характеристики
В отличие от серверных ускорителей AMD, которые изначально создавались под нейросети, R9700 построена на микроархитектуре RDNA 4.0. С 2020 года у AMD две отдельные линии: RDNA для игровых и профессиональных GPU и CDNA для серверных и суперкомпьютерных ускорителей. Из этого следует практический минус: стек ROCm исторически выстраивался под CDNA, и для RDNA поддержка развивается с отставанием.
Зато в своей ценовой нише у R9700 почти нет конкурентов. Среди потребительских видеокарт сопоставимый объём памяти даёт только RTX 5090, но она заметно дороже.
Почему главное здесь именно 32 ГБ
Объём VRAM определяет сразу три вещи: какие модели вообще можно запустить, какой длины контекст удастся обслуживать и какой размер пакетов потянет карта при многопользовательском инференсе. Чем больше памяти, тем больше параметров помещается целиком на видеокарте, без выгрузки в оперативную память. Например, Llama* 3.1 32B в Q4_K_M на 16 ГБ без компромиссов не запускается, а на 32 ГБ помещается.
Конфигурация чипа
По остальным параметрам AI PRO R9700 идентична RX 9070 XT:
| Параметр | Значение |
|---|---|
| Архитектура | RDNA 4.0 |
| Видеопамять | 32 ГБ GDDR6, шина 256 бит |
| Пропускная способность памяти | 640 ГБ/с |
| Вычислительные блоки (CU) | 64 |
| Потоковые процессоры | 4096 |
| AI-ускорители | 128, второе поколение |
| Блоки трассировки лучей | 64 |
| Форматы вычислений | FP32, FP16, INT8, а также FP8 и INT4 |
Поддержка FP8 и INT4 особенно важна: именно эти форматы дают высокую скорость на современных LLM.
Конструктив, питание и охлаждение
Карта выполнена в компактном двухслотовом форм-факторе и рассчитана на сборки с несколькими GPU в ограниченном пространстве. Турбинная система охлаждения позволяет ставить адаптеры вплотную друг к другу без перегрева. Для рабочих станций с 2–4 GPU под обучение и запуск крупных локальных моделей это принципиально, и AMD на презентации отдельно показывала такие сборки: с турбиной проще проектировать продув и отвод тепла.
Что стоит учесть при проектировании питания:
- разъём один, 12V-2x6, вместо привычных 6- и 8-pin;
- потребление карты составляет 300 Вт;
- рекомендованный блок питания начинается от 750 Вт;
- переходник с двух 8-pin на 12V-2x6 лежит в комплекте.
По видеовыходам версия GIGABYTE отличается от референса: у неё три DisplayPort 2.1a и один HDMI 2.1b, тогда как в референсном дизайне HDMI нет вовсе, а все четыре порта — DisplayPort 2.1a. Больше ничего выдающегося: печатная плата полностью совпадает с обычной RX 9070 XT.
Готовность софта: llama.cpp, vLLM, SGLang
llama.cpp работает с R9700 через HIP-бэкенд (ROCm) и через Vulkan. Разрыв в скорости огромный: ROCm многократно быстрее Vulkan, поэтому основной вариант — ROCm, а Vulkan остаётся запасным.
vLLM получил официальную поддержку RDNA3 и RDNA4 в версии 0.15.0, вышедшей 29 января 2026 года. До этого работать с ним на таких картах можно было только через патчи сообщества. Нативная поддержка FP8 для RDNA4 в основную ветку пока не вошла и существует как отдельный патч.
SGLang в этой истории оказался в стороне: в документации RDNA даже не упоминается, а поддерживаются только ускорители Instinct серии MI300X. Тратить время на SGLang с R9700 сейчас не стоит.
Причина такой картины проста: AMD традиционно отдаёт приоритет Instinct и архитектуре CDNA. RDNA 4 новая, и экосистема только начинает под неё подтягиваться. Документация, официальные примеры и ответы сообщества пока ориентированы на Instinct, а не на профессиональные Radeon. Это скорее временный недостаток, чем фундаментальный изъян: со временем и AMD, и сообщество оптимизируют стек под новую линейку.
Условия тестирования
Единственный движок, который сегодня полноценно поддерживает R9700, — llama.cpp, поэтому тесты построены на нём. Система — Ubuntu 24.04.4 LTS, самый распространённый дистрибутив Linux, ROCm версии 7.1.1. Установка и настройка ROCm на R9700 такая же, как на любом Instinct.
Карта работает и под Linux, и под Windows, в отличие от Instinct. Но Linux остаётся для неё основной средой: там доступен полный стек, ROCm поддерживается официально, работает HIP-бэкенд и активна ECC-память. Windows — нестандартный сценарий, достойный отдельной статьи. Тесты R9700 в ComfyUI, Kandinsky и Wan2.2 автор делал отдельно, в видеоформате.
Набор моделей разбит на четыре группы: популярные, крупные, кодовые и недавние релизы. Он во многом совпадает со списком из обзоров AMD Instinct MI100 и NVIDIA Tesla V100.
Результаты тестов LLM
Все модели прогнаны на AMD Radeon AI PRO R9700 с контекстом 4096 токенов. Скорость генерации указана в токенах в секунду, «до первого токена» — это время от начала запроса до появления ответа.
Базовые популярные модели
| Модель | Квантизация | Скорость, т/с | До первого токена | Комментарий |
|---|---|---|---|---|
| Qwen 2.5 7B-Instruct | Q4_K_M | 80.80 | 0.07 с | Разумная, проверенная временем модель |
| Llama 3.1 8B-Instruct* | Q4_K_M | 67.05 | 0.06 с | Немногословна, но отвечает верно |
| Mistral 7B v0.3 | Q4_K_M | 73.31 | 0.05 с | Среднестатистическая, ничем не выделяется |
| gpt-oss-20b | MXFP4 | 109.68 (лучший результат) | 0.13 с | Одна из лучших моделей, подробные и быстрые ответы |
| Mistralai/Devstral-small-2-2512 24B | Q4_K_M | 72.28 | 0.05 с | Типовая dense-модель, пришедшая на замену Mixtral 8x7B, добротные ответы |
Крупные языковые модели
| Модель | Квантизация | Скорость, т/с | До первого токена | Комментарий |
|---|---|---|---|---|
| Qwen 2.5 14B-Instruct | Q4_K_M | 41.57 | 0.13 с | Иногда задумывается на сложных предложениях на доли секунды |
| Qwen3 14B | Q4_K_M | 38.19 | 0.12 с | Лишена изъянов версии 2.5 |
| Gemma 3 27B-IT-QAT | Q4_O | 30.81 | 0.22 с | Грамотные, логичные ответы без ошибок в словах |
| Qwen3 32B | Q4_K_M | 27.61 (медленно) | 0.26 с | Очень подробные ответы, хорошо владеет русским и английским |
| Kimi Linear 48B A3B Instruct | Q4_K_M | 16.81 (медленно) | 1.40 с | Предел возможностей R9700: с трудом помещается в память, но ответы развёрнутые и приемлемые |
Кодовые модели
| Модель | Квантизация | Скорость, т/с | До первого токена | Комментарий |
|---|---|---|---|---|
| Deepseek Coder 7B | Q4_K_M | 66.55 | 0.05 с | Легко пишет простые программы и скрипты |
| Code Llama 7B* | Q4_K_M | 80.54 (быстро) | 0.04 с | Самый шустрый из кодеров |
| Granite Code 8B | Q4_K_M | 68.27 | 0.07 с | Добротный кодер, но плохо понимает запросы на русском |
Недавние релизы
| Модель | Квантизация | Скорость, т/с | До первого токена | Комментарий |
|---|---|---|---|---|
| DeepSeek-R1 Distilled 14B | Q4_K_M | 56.37 | 0.16 с | Не очень дружит с русским языком |
| DeepSeek-R1 Distilled 32B | Q4_K_M | 27.63 (медленно) | 0.26 с | Немногим лучше версии на 14 млрд параметров |
| Ministral 3 14B-Instruct | Q4_K_M | 57.10 | 0.11 с | Очень развёрнутые и подробные ответы |
| Ministral 3 14B-Reasoning | Q4_K_M | 55.20 | 0.12 с | Прекрасная модель, может тягаться с gpt-oss-20b |
| Qwen3.5 9B | Q4_K_M | 51.57 | 0.57 с | Самая свежая модель Qwen, вышла 2 марта 2026 года; для своего размера мыслит масштабно и подробно |
| Qwen3.5 35B A3B | Q4_K_M | 60.06 (быстро) | 0.32 с | Ещё одна новая модель Qwen, вышла 24.02.2026; лучшие и самые подробные ответы, сильная логика и причинно-следственные связи |
Что видно по цифрам
Помимо заметно более долгой загрузки модели в память, на крупных моделях R9700 сильно теряет в скорости. Причина в типе памяти: у карты GDDR6, а не многослойная HBM, как у многих серверных ускорителей.
Картина получается такая. На некрупных моделях R9700 идёт вровень с AMD Instinct MI100 или даже опережает её. Но когда вес модели превышает 8–10 ГБ, «прошка» начинает отставать, на некоторых моделях вплоть до 30%.
Температурный режим
Здесь карта выигрывает у своего серверного собрата. В реальной нагрузке на крупных LLM, при получасовом прогоне, средняя температура не поднимается выше 70 °C, а хотспот лишь изредка выходит за это значение. Память прогревается до 71–73 °C.
Часовой прогон во встроенном в ROCm бенчмарке немного меняет картину, но не радикально: средняя температура едва превышает 70 °C, память нагревается примерно до 85 °C, а хотспот скачет выше остальных, до 90–95 °C.
Какие сборки с R9700 доступны в «СервакМастер»
Если вы выбираете платформу под локальные LLM, то при подборе стоит исходить из числа карт и объёма памяти: каждая R9700 добавляет 32 ГБ VRAM, а двухслотовая турбина позволяет плотную компоновку. В нашем каталоге есть готовые конфигурации с этой видеокартой (актуальные цены и наличие смотрите в карточках):
- Supermicro AS-2025HS-TNR, платформа 2U: 2× Radeon AI PRO R9700 32GB, 2× EPYC 9124, 128 ГБ RAM;
- Supermicro 2029GP-TR, платформа 2U: 4× Radeon AI PRO R9700 32GB, 2× Xeon Gold 6248, 384 ГБ RAM (б/у, восстановленная);
- Supermicro 4028GR-TR, платформа 4U: 6× Radeon AI PRO R9700 32GB, 2× Xeon E5 2697Av4, 128 ГБ RAM (б/у, восстановленная);
- Supermicro 747BTQ-R2K04B, платформа 4U: 4× Radeon AI PRO R9700 32GB, 1× EPYC 7502, 128 ГБ RAM (б/у, восстановленная);
- сборки СервакМастер Custom в корпусах Tower: Deepcool MATREXX 55 MESH с 1× R9700, Ryzen 9 9950X и 64 ГБ RAM, а также Phanteks Enthoo Pro 2 Server Edition с 4× R9700, Xeon Platinum 8341C и 128 ГБ RAM.
Все платформы комплектуются видеокартами GIGABYTE Radeon AI PRO R9700 AI TOP 32GB GDDR6. Посмотреть варианты можно в разделах серверы и AI-серверы, а если нужна нестандартная конфигурация, напишите нам через страницу контактов: подберём состав под ваши модели и бюджет.
Итог
AMD AI PRO R9700 AI TOP — видеокарта, которая явно удалась в своей нише. Если вам нужен «ИИ-ускоритель» за относительно небольшие деньги по меркам конкурентов, при этом вы не хотите мириться с ограничениями линейки Instinct и рассчитываете сохранить в одной карте весь функционал и поддержку Windows, то на текущем рынке это практически безальтернативный выбор.
*Llama — проект Meta Platforms Inc.**, деятельность которой в России признана экстремистской и запрещена.
**Деятельность Meta Platforms Inc. в России признана экстремистской и запрещена.