
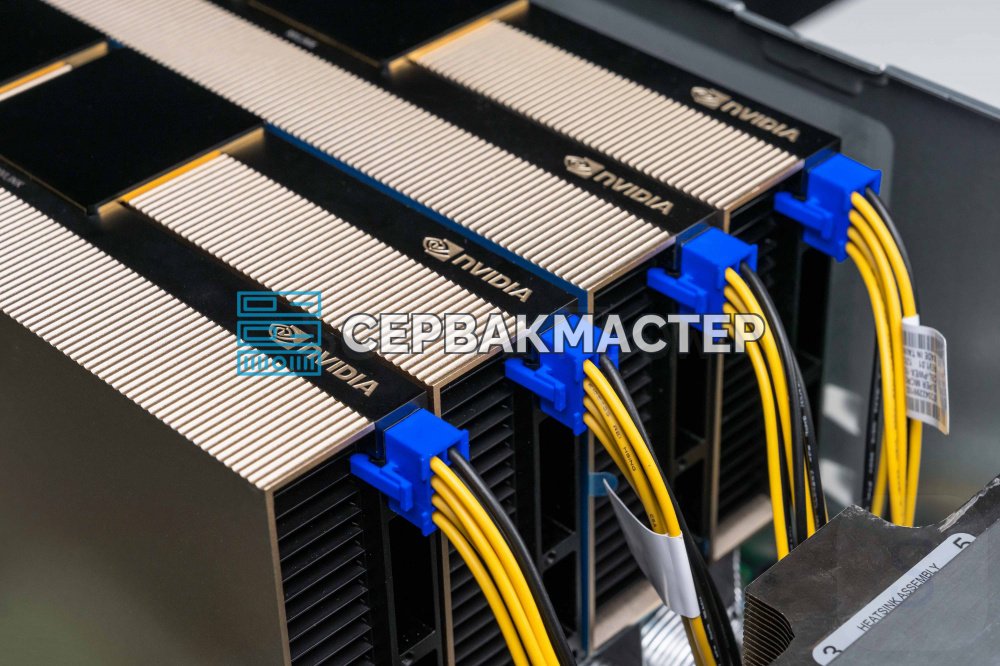
Успех Nvidia принято объяснять удачной архитектурой GPU, талантом инженеров и экосистемой CUDA, но есть ещё один фактор. Мощность отдельных ИИ-ускорителей мало что значит, если их нельзя собрать в единую систему с минимальными задержками при обмене данными. Эту задачу решает NVLink. Благодаря ему корпоративные ускорители объединяются в серверы, стойки и целые ИИ-фабрики, где тысячи графических чипов работают как один вычислитель. Ниже разберём, что такое NVLink, как он появился и работает, какие у него бывают реализации и какие аналоги есть у технологии.
Что такое NVLink
NVLink — высокоскоростной интерконнект для прямого обмена данными между GPU. Nvidia разработала его в 2014 году, а на практике он впервые появился в 2016 году в ИИ-ускорителях P100 (Pascal). Задумывался он как более быстрая альтернатива шине PCIe: в системах с несколькими видеокартами именно она становится узким местом, и NVLink позволяет обходить её и центральный процессор при передаче данных.
Почему PCIe не хватает
Без NVLink скорость обмена между GPU упирается в PCIe. У PCIe 5.0 x16 суммарная пропускная способность составляет не более 128 ГБ/с, а в привычном одностороннем измерении — не более 64 ГБ/с. Для офисных задач это много, но в задачах ИИ данные измеряются терабайтами, и PCIe превращается в бутылочное горлышко: растут задержки, а мощные GPU простаивают.
Актуальная версия NVLink 5.0 даёт одностороннюю пропускную способность 900 ГБ/с — более чем в 10 раз быстрее PCIe 5.0. Задержки сводятся к минимуму, а сама шина PCIe в обмене между GPU не участвует, так что её ресурсы остаются свободными для других задач.
NVLink, как и PCIe, работает в обе стороны одновременно (по разным линиям). В версии 5.0 реальная скорость приёма и отправки — по 900 ГБ/с, но в маркетинговых материалах Nvidia указывает суммарные 1,8 ТБ/с. Кроме того, для работы нужна не только аппаратная поддержка со стороны видеокарт, но и программная экосистема CUDA, которая распределяет задачи между ядрами разных процессоров.
За счёт чего NVLink быстрее
- PAM4 (Pulse Amplitude Modulation 4-level) — способ кодирования сигнала, при котором в одном электрическом импульсе передаются сразу два бита, то есть вдвое больше данных за такт. Раньше PAM4 применяли в сетевом оборудовании, а Nvidia перенесла его в NVLink и получила кратный прирост пропускной способности. В PCIe PAM4 появится только в спецификации PCIe 6.0, поэтому пока это преимущество остаётся за NVLink.
- Unified Memory — концепция единой памяти. GPU и CPU объединяются не только физически, но и логически: память всех чипов образует общий пул с единым адресным пространством. Это убирает задержки на постоянное копирование данных между чипами и ускоряет работу с огромными моделями. Наглядный пример — стойки Nvidia NVL72, где все ИИ-чипы находятся в одном адресном пространстве, а в исполнении с GB300 это даёт 20,7 ТБ памяти HBM3E с пропускной способностью до 130 ТБ/с.
Где NVLink есть, а где нет
Сегодня NVLink — удел корпоративных ускорителей (H100, B200). Потребительские видеокарты (RTX 5090) и профессиональные (RTX PRO 6000 Blackwell Workstation Edition) этого интерконнекта лишены. Так было не всегда: в поколениях RTX 20 (Turing) и RTX 30 (Ampere) NVLink присутствовал, но когда Nvidia оценила ценность технологии, её убрали из потребительского и профессионального сегментов. Последним решением с NVLink вне корпоративного рынка стал RTX 3090 Ti.
Предшественник: Nvidia SLI
Сегодня Nvidia ассоциируется с ИИ, но раньше основной доход приносила 3D-графика и игры. Для геймеров компания и создала SLI — технологию совместного рендеринга на двух видеокартах, которая во многом вдохновила будущий NVLink. Карты соединялись физическим мостом-кабелем, а нагрузку можно было распределить тремя способами:
- SFR — кадр делится на части, и оба GPU обрабатывают его одновременно;
- AFR — кадры рендерятся по очереди;
- SLI AA — карты совместно улучшают сглаживание изображения.
Прирост производительности в играх и профессиональных приложениях был, но небольшой: сложность кадров постоянно меняется, и один GPU простаивает, пока второй отрисовывает тяжёлый кадр. Не все проекты вообще поддерживали SLI, а у тех, что поддерживали, случались артефакты рендеринга. Требовались одинаковые карты (не больше двух) и материнская плата с поддержкой SLI, да и фризы возникали нередко. В 2021 году технологию свернули, но принципы её работы легли в основу NVLink.
Версии NVLink
За годы существования интерконнект прошёл пять поколений, и каждое поднимало пропускную способность и расширяло список поддерживаемых архитектур GPU.
| Версия | Архитектуры GPU | Год выпуска | Однонаправленная пропускная способность | Двунаправленная пропускная способность |
|---|---|---|---|---|
| NVLink 1.0 | Pascal | 2016 | 80 ГБ/с | 160 ГБ/с |
| NVLink 2.0 | Volta/Turing | 2017 | 100 ГБ/с | 200 ГБ/с |
| NVLink 3.0 | Ampere | 2020 | 300 ГБ/с | 600 ГБ/с |
| NVLink 4.0 | Hopper | 2022 | 450 ГБ/с | 900 ГБ/с |
| NVLink 5.0 | Blackwell | 2025 | 900 ГБ/с | 1800 ГБ/с |
Кроме скучного удвоения скоростей, Nvidia разработала несколько аппаратных реализаций, которые различаются сценариями применения и масштабом объединения вычислительных компонентов.
Аппаратные реализации NVLink
NVLink Bridge
Это физическая плата, которая вставляется в специальные разъёмы на торце карт (как мостики SLI, только на порядки мощнее) и соединяет два или четыре соседних ускорителя. В последний раз мосты применялись в поколении Hopper (решения PCIe и NVL). Для H100/H200 мост обеспечивал соединение до 900 ГБ/с двунаправленной скорости, позволяя картам объединять память и работать как одно целое без задержек. Например, пара мостов на 8-карточном сервере H200 создаёт полносвязную сеть между всеми 8 GPU, а память карт превращается в два пула.
В поколении Blackwell от NVLink Bridge отказались по маркетинговым причинам: Nvidia выгоднее продавать серверы формата HGX и DGX, а достойных конкурентов пока нет.
DGX Board
DGX Board — это не просто плата, а полноценная самостоятельная система для ИИ. Внутри каждого сервера DGX (например, DGX H100 или DGX B200) установлена такая плата: на неё распаяны восемь мощных GPU, один или несколько центральных процессоров, большой объём памяти, NVLink-коммутаторы, а также карты расширения и интерфейсы для сетей хранения данных.
Схемы соединения ускорителей зависят от поколения:
- в старых серверах DGX-2 на плате размещались 6 микросхем NVSwitch и трассировка NVLink, объединявшие 16 GPU в единый массив с пропускной способностью 300 ГБ/с напрямую;
- в современных решениях на базе H100, B200 и новейших B300 применяются уже не отдельные микросхемы, а полноценные вычислительные модули, которые связывают GPU через NVSwitch и создают полносвязную сеть с пропускной способностью до 1,8 ТБ/с на GPU.
На DGX Board строятся эталонные ИИ-системы Nvidia — от настольной DGX Station до больших стоек DGX SuperPOD. Одна такая система вмещает эксафлопсную вычислительную мощность в пределах одного блока.
NVSwitch и NVLink Switch
Когда нужно объединить не 2 или 8, а десятки и сотни ускорителей, простых решений уже недостаточно. Используя сетевые наработки Mellanox, Nvidia создала NVSwitch — отдельный ASIC-чип с высокоскоростной неблокируемой пропускной способностью, который позволяет каждому GPU в стойке общаться с любым другим на полной скорости. Несколько NVSwitch объединяют в ноды, и получается коммутируемый модуль NVLink Switch.
С выходом Blackwell топология (Fat Tree) вышла за пределы одного сервера и охватила целый шкаф. NVLink Switch 5-го поколения содержит 144 порта NVLink и обеспечивает пропускную способность коммутации 14,4 ТБ/с в неблокируемом режиме. На таких свитчах строятся NVL-стойки, которые затем собираются в вычислительные кластеры и ИИ-фабрики.
NVLink C2C (Chip-2-Chip)
Следующий шаг — перенос интерконнекта на уровень кристалла. NVLink-C2C — специализированная версия, рассчитанная на сверхплотный монтаж и связь CPU с GPU или двух чиплетов GPU/CPU в рамках одного корпуса. Это, по сути, «внутренний» NVLink. В связке Grace CPU с Blackwell GPU он даёт 900 ГБ/с в одну сторону.
Главная особенность — аппаратная когерентность памяти. Раньше у CPU и GPU были раздельные таблицы страниц, и данные пересылались копированием. С NVLink-C2C они работают в едином адресном пространстве с общей когерентностью кэша: CPU видит память HBM графического процессора, а GPU — память LPDDR процессора, как соседние NUMA-узлы одной большой системы.
Именно NVLink-C2C позволил Nvidia получить обособленный аппаратный стек для серверов из собственных компонентов и породил суперчипы: GH200, GB200, готовящиеся VR200 и даже компактные GB10 из DGX Spark.
NVLink Fusion
Может показаться, что NVLink — исключительно проприетарное решение, но это не совсем так. NVLink Fusion позволяет объединять с ИИ-ускорителями Nvidia любой сторонний CPU, ASIC или GPU. Это специальный кремниевый чиплет, который производители (MediaTek, Synopsys, Marvell) могут лицензировать и встраивать в собственные чипы: кастомные ASIC, ускорители или серверные процессоры.
Раньше всё, что находилось вне экосистемы Nvidia, подключалось к ускорителям через узкое горлышко PCIe. Теперь чиплет размещается рядом с основным вычислительным кристаллом заказчика и подключается напрямую к фабрике NVLink внутри стойки. Результат:
- пропускная способность до 14 раз выше, чем у PCIe Gen5;
- общая пропускная способность до 800 Гб/с для интеграции с сетевыми фабриками Quantum-X800 и Spectrum-X;
- возможность строить ИИ-фабрики, где в одном пуле работают и стандартные GPU Nvidia, и полностью кастомные ускорители заказчика.
Фактически Nvidia открыла свою самую быструю шину для конкурентов, пусть и за лицензионные отчисления. Это превращает NVLink из проприетарного соединения в отраслевой стандарт для построения гетерогенных суперкомпьютеров.
NVQLink
Если обычный NVLink связывает GPU с GPU, то NVQLink — мост между принципиально разными мирами. Это новая открытая системная архитектура Nvidia, которая переносит возможности NVLink на уровень связи классических GPU-суперкомпьютеров с квантовыми процессорами (QPU). Классические ускорители в реальном времени управляют кубитами, калибруют их и исправляют ошибки с микросекундными задержками.
По своей низкоуровневой природе это всё тот же NVLink (с использованием RDMA через Ethernet), но на практике — открытый хаб, к которому может подключиться любой производитель квантового оборудования. Заявленные параметры: 40 PetaFLOPS в разреженном формате FP4 и 400 Гбит/с на соединение с задержкой менее 4 микросекунд. Технология уже работает в связке Grace Blackwell с квантовым процессором Helios компании Quantinuum и выполняет декодирование квантовой коррекции ошибок в реальном времени. Любой производитель может лицензировать спецификацию и встроить NVQLink в свой квантовый контроллер, что делает её основой гибридных суперкомпьютеров, где классическая и квантовая логика работают как единый организм.
Когда NVLink действительно нужен
Главные сферы применения — ИИ и HPC:
- Обучение ИИ. NVLink обеспечивает минимальные задержки между тысячами GPU и позволяет хранить петабайты весов топовых моделей в едином адресном пространстве высокоскоростной HBM-памяти.
- Высоконагруженный инференс, например агентные рои, где важна минимальная задержка между этапами префилла и декодирования.
- HPC-кластеры. NVLink избавляет от копирования данных между CPU, GPU и RAM и заметно ускоряет научные расчёты.
Для потребительского инференса NVLink не нужен: даже у топовой RTX PRO 6000 Blackwell Workstation Edition его нет. Модели малого и среднего размера спокойно помещаются в её 96 ГБ GDDR7, поэтому объединять веса в единое пространство незачем, а пропускной способности памяти одного ускорителя достаточно для работы с LLM.
В профессиональных приложениях (Autodesk Maya, DaVinci Resolve, ANSYS, Adobe Premiere Pro) NVLink тоже ничего не даёт. Архитектура таких задач линейна: данные грузятся с SSD в VRAM, обрабатываются ядрами CUDA и выводятся на монитор. К тому же нужна поддержка NVLink со стороны самого ПО, а её часто нет за ненадобностью.
Что это значит при выборе сервера
Если ваша задача — обучение крупных моделей или распределённый инференс, где несколько GPU должны работать как один, смотрите в сторону платформ с NVLink: серверов с ускорителями H200 и мостами NVLink Bridge, а также HGX- и DGX-систем. Для инференса моделей, умещающихся в память одной карты, и для профессиональной графики интерконнект переплачивать не имеет смысла. Подобрать конфигурацию под конкретную задачу можно в разделах GPU- и ИИ-серверов и серверов общего назначения, а специалисты «СервакМастер» помогут определиться по контактам.
Аналоги NVLink
Конкуренты Nvidia ищут пути в обход проприетарной шины. Выделяют три основные альтернативы:
- UALink (Ultra Accelerator Link). Консорциум AMD, Intel, Google, Microsoft, Meta, Broadcom и Cisco разрабатывает открытый стандарт высокоскоростного межсоединения для ИИ-ускорителей — по сути, индустриальный аналог NVLink без лицензионных отчислений Nvidia. Спецификация UALink 1.0 даёт однонаправленную скорость до 400 ГБ/с и когерентность памяти, однако устройств на этой шине пока нет.
- AMD Infinity Fabric. Проприетарный аналог от AMD, работающий поверх протокола PCIe и связывающий кристаллы CPU и GPU внутри экосистемы AMD. По сути, он похож на NVLink C2C, причём появился ещё в 2017 году — на 7 лет раньше разработки Nvidia. Актуальная версия Infinity Fabric 5.0 даёт однонаправленную скорость 64 ГБ/с, как и PCIe 5.0, но объединяет чипы в единое адресное пространство. Особенно близок к NVLink в APU AMD MI300A для суперкомпьютеров, где интерконнект связывает CPU- и GPU-части в единую систему.
- Huawei SuperPoD Interconnect (HCCS). Внутренняя шина HCCS (Huawei Cache Coherent System) используется в кластерах Ascend. В стойках SuperPoD (например, на базе Atlas 900) она связывает тысячи ускорителей Ascend 910B/C. Huawei заявляет общую пропускную способность HCCS 392 ГБ/с для 8 NPU в одном сервере; более точные данные о скоростях не приводятся.
Выводы
NVLink показывает, как инженерное решение, ставшее коммерческой тайной, превращается в основу технологического превосходства. Начавшись как замена PCIe и малоэффективного SLI, он вырос в хребет современных ИИ-фабрик, и рынок корпоративного ИИ Nvidia удерживает именно благодаря связке NVLink + NVSwitch.
Финал гонки, впрочем, неочевиден. С одной стороны, анонсом NVLink Fusion Nvidia развернула ситуацию в свою пользу: тем, кто не может конкурировать, предлагается купить лицензию и присоединиться. С другой — открытый консорциум UALink и сильные разработки вроде AMD Infinity Fabric говорят о том, что эпоха монополии NVLink, возможно, близится к закату. Пока же можно утверждать одно: если вы видите стойку, где ускорители выдают свыше 1 EFLOPS в FP8, внутри работает NVLink. Без него эти тысячи GPU были бы просто горой дорогого кремния.