
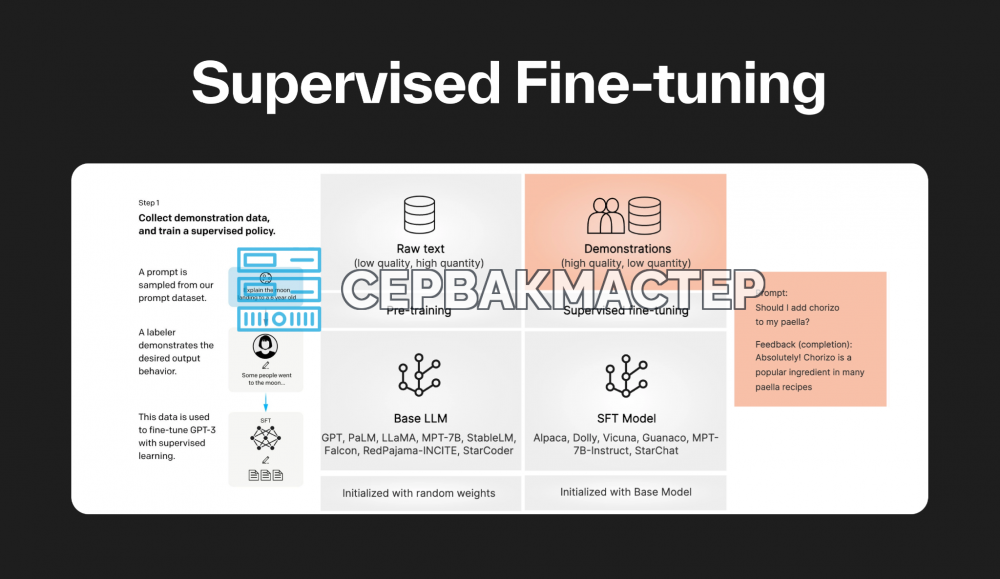
Большая языковая модель может блестяще написать технический отчёт и при этом отвечать сотрудникам слишком примитивно или не в том стиле, который принят в компании. Причина в разрыве между тем, чему модель училась при предобучении (угадывать следующее слово), и тем, чего ждёт пользователь (точного ответа на конкретную инструкцию). Чтобы не расписывать каждый промпт на полстраницы, модель дообучают: Instruction Tuning и Supervised Fine-Tuning (SFT) приучают её понимать инструкции и отвечать в нужной манере. Ниже разберём, как устроены эти методы, как подготовить данные, какое оборудование потребуется и где дообучение даёт наибольшую отдачу.
Что такое SFT и чем от него отличается Instruction Tuning
SFT: контролируемое дообучение
SFT (Supervised Fine-Tuning) — классический способ дообучения, при котором уже предобученная модель продолжает учиться на размеченных парах «инструкция — ответ». Веса обновляются методом обратного распространения ошибки: модель учится предсказывать каждый токен правильного ответа, опираясь на инструкцию и, при необходимости, дополнительный контекст. По сути, SFT служит мостом между режимом «предсказать следующее слово» и режимом «выполнить просьбу пользователя».
Instruction Tuning: акцент на манере ответа
Instruction Tuning можно считать более продвинутой версией SFT. Обычная тонкая настройка нередко нужна, чтобы вложить в модель новые данные. Здесь же главное — не то, что отвечать, а как отвечать: в каком формате, каким стилем, по каким правилам. Именно это базовым моделям даётся тяжелее всего. В результате получаются чат-боты и ассистенты, которые не просто владеют знаниями, но и соблюдают политику компании, держат заданную тональность и структуру общения.
| Параметр | SFT | Instruction Tuning |
|---|---|---|
| Данные | Пары «инструкция — ответ» | Пары «инструкция — ответ» |
| Основная цель | Научить модель предсказывать правильный ответ | Научить следовать инструкциям, формату и стилю |
| Требования к датасету | Безупречная разметка, контроль утечек, баланс задач | Разнообразные и качественные инструкции |
Методы и практики Instruction Tuning
Данные решают почти всё
Если запустить Instruction Tuning на первом попавшемся наборе, нужного эффекта не будет, а модель с высокой вероятностью пострадает от «катастрофического забывания» и потеряет даже базовые умения. Поэтому от выбора данных зависит около 90% успеха дообучения. Допустимо брать открытые датасеты (например, Alpaca, Dolly) или синтетические наборы, которые генерирует сама нейросеть. Но самый ценный материал — корпоративные пары «запрос — ответ», составленные вашими опытными специалистами.
LoRA и QLoRA
К Instruction Tuning можно добавить LoRA и QLoRA. Эти подходы замораживают исходные веса модели и добавляют небольшие веса-адаптеры. Число обучаемых параметров сокращается в тысячи раз, а значит, сильно экономятся вычисления и память, и крупные модели удаётся настраивать даже на скромном оборудовании.
Alignment Tuning: DPO и ORPO
Ещё одно современное направление — Alignment Tuning, куда входят DPO (Direct Preference Optimization) и ORPO (Odds Ratio Preference Optimization). Они корректируют поведение модели по человеческим предпочтениям: ответы должны быть не просто верными, но полезными, безопасными и этичными. По сути, это тот же Instruction Tuning с дополнительной защитой, которая мешает клиентам «обмануть» дообученного бота.
Вместе эти инструменты дают инженерам гибкость в кастомизации LLM и позволяют держать баланс между качеством ответов, стоимостью развёртывания и скоростью дообучения.
Подготовка данных для SFT
В SFT выбор данных так же критичен, как и в Instruction Tuning. Но поскольку метод меньше нацелен на следование инструкциям, требования к датасету строже: нужна безупречная разметка, контроль данных, чтобы исключить утечки, и баланс между разными типами задач.
Hugging Face Datasets даёт доступ к множеству готовых размеченных наборов, однако их необходимо проверять, обновлять и дополнять корпоративными данными. Исследования показывают, что даже в известном databricks-dolly-15k встречаются фактические ошибки, неточные выводы, неполные инструкции и опечатки. Автоматические инструменты вроде Cleanlab Studio помогают находить такие проблемы: оценивают достоверность ответов и выявляют токсичный или конфиденциальный контент. Тем не менее ручная выборка всё равно нужна.
Готовые данные делят на три части:
- обучающая — для основного обучения модели;
- валидационная — для промежуточной оценки качества ответов;
- тестовая — для итоговой оценки на этапе вывода.
На тестовой выборке дополнительно подключают метрики релевантности ответов в конкретных типах задач, скорости генерации и точности следования пользовательским инструкциям.
Какая инфраструктура нужна
Instruction Tuning и SFT требовательны к ресурсам на каждом этапе:
- Предобработка. Токенизация и работа с большими наборами нагружают мощные CPU.
- Само дообучение. Нужны высокопроизводительные GPU-ускорители.
- Хранение. Для быстрой подгрузки данных лучше всего подходят NVMe-накопители.
При длительных сессиях на моделях с большим числом параметров важны не только объём ресурсов, но и отказоустойчивость всей системы.
Распространено мнение, что работа с весами LLM занимает огромное время даже на самых мощных картах. Это не совсем так: если дообучать модель на GPU с высокоскоростной памятью HBM, которая заметно эффективнее обрабатывает градиенты весов, оптимизация занимает всего несколько часов. Среди таких ускорителей — H200 на HBM3E, H100 NVL на HBM3 и более доступные A100 на HBM2E.
В «СервакМастер» можно подобрать готовые GPU-платформы под такие задачи: загляните в разделы AI-серверы и серверы. Если вы не уверены, какая конфигурация подходит под ваш бюджет и модель, опишите задачу на странице контактов, и мы поможем с выбором.
Где применяют SFT и Instruction Tuning
Корпоративные чат-боты и ассистенты
Самый частый сценарий — ИИ-помощники, которые знают базу компании и общаются в принятом стиле: формальном для юридической фирмы или дружелюбном и поддерживающем для службы клиентской поддержки.
Генераторы документации
Модели дообучают на автоматическое создание технической документации, отчётов и маркетинговых материалов, которые строго соответствуют внутренним стандартам по структуре, терминологии и тональности.
Мультимодальные модели
Instruction Tuning не ограничен текстом. Например, модель Whisper можно дообучить распознавать речь с узкой лексикой — медицинские заключения, инженерные термины — и заметно повысить точность транскрибации в этой области.
Выводы
Одного локального инференса мало, чтобы модель стала по-настоящему «вашей». Такой её делают методы дообучения — Instruction Tuning и SFT: они меняют сам принцип работы нейросети, делая её не столько «умной», сколько полезной и отзывчивой. Но дообучение на сомнительном наборе данных — серьёзная ошибка. Используйте качественные открытые датасеты или собственные пары «запрос — ответ» и заранее очищайте их в специализированных сервисах. Только так дообучение даст максимальный эффект.