
Говоря об обучении больших языковых моделей, обычно вспоминают GPU Nvidia, ИИ-ускорители, вычислительные узлы и кластеры с впечатляющими цифрами TFLOPS в форматах FP16, FP8 или FP4. Но производительность вычислительных блоков — только половина дела. Главное узкое место часто лежит не в арифметике, а в ёмкости и пропускной способности памяти. Именно HBM не даёт Nvidia Rubin или AMD Instinct MI400 простаивать в ожидании данных. Ниже специалисты «СервакМастер» объясняют, что такое HBM, как она устроена, какие у неё есть поколения и почему от неё так сильно зависит ИИ-инфраструктура.
Что такое HBM и как она работает
HBM (High Bandwidth Memory) — тип графической памяти, созданный ради максимальной пропускной способности и плотности хранения. Достигается это особой компоновкой DRAM-кристаллов.
Микросхемы GDDR в потребительских видеокартах распаиваются по одной на плате вокруг GPU. В HBM кристаллы памяти укладываются друг на друга в многослойную 3D-стопку. Каждый слой — отдельный чип, а между собой слои связаны вертикальными проводниками, которые проходят сквозь кремний. Технология называется TSV (Through-Silicon Vias). В основании стопки стоит базовый логический кристалл-контроллер. Вся сборка устанавливается не на текстолит ускорителя отдельно, а на общую с GPU подложку, поэтому вычислительный чип получает прямой доступ к своей памяти.
Почему шина такая широкая
Из-за этой компоновки интерфейс HBM намного шире, чем у GDDR: у одного чипа GDDR7 шина 32 бита, а у стека HBM3E — 1024 бита. Частота самой HBM при этом скромнее, всего 1–3 ГГц, но итоговая пропускная способность достигает нескольких терабайт в секунду. Контакты микробампов на подложке очень короткие, паразитные ёмкости минимальны, и за счёт этого заметно падает энергопотребление на каждый переданный бит.
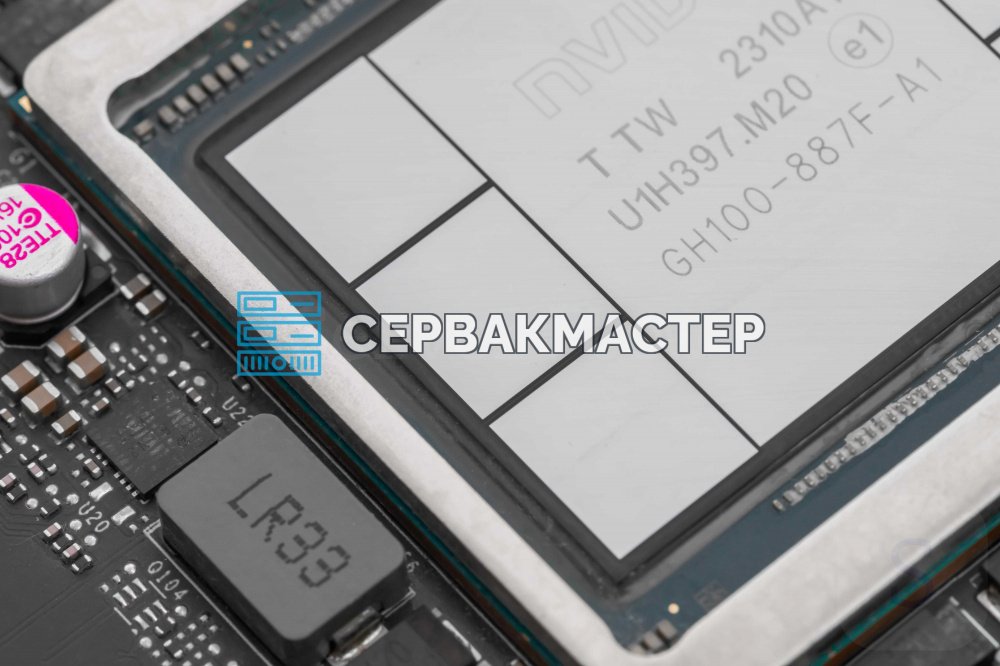
Типичный пример — ускорители Nvidia H100, где чипы HBM3 расположены на одной подложке с графическим чипом GH100.
Поколения HBM
Технология развивалась быстро: сначала её подталкивали задачи HPC, затем бум искусственного интеллекта. Каждое поколение заметно увеличивало ёмкость и пропускную способность и одновременно усложняло производство.
Сводная таблица
| Поколение | Макс. объём на стек | Пропускная способность на стек | Шина |
|---|---|---|---|
| HBM1 | 4 ГБ | 128 ГБ/с | 1024 бита |
| HBM2 | 24 ГБ | до 256 ГБ/с | 1024 бита |
| HBM2E | 24 ГБ | до 460 ГБ/с | 1024 бита |
| HBM3 | 24 ГБ | до 819 ГБ/с | 1024 бита |
| HBM3E | 48 ГБ | свыше 1,0 ТБ/с, до 1,2 ТБ/с | 1024 бита |
| HBM4 | 64 ГБ | от 2,8 ТБ/с (Micron) до 3,3 ТБ/с (Samsung) | 2048 бит |
| HBM4E | 64 ГБ | 4,0 ТБ/с | — |
HBM1 (2015)
Первое поколение вышло в 2015 году в видеокартах AMD Radeon R9 Fury X и Radeon Pro Duo (чип Fiji). Именно AMD инициировала разработку этого типа памяти. По сути, это была демонстрация концепции: она показала, что 3D-стопки DRAM работают в конечных устройствах. Техпроцесс TSV и ограниченная плотность позволяли собрать лишь до четырёх слоёв в стеке, так что объём в 4 ГБ на стек для профессиональных задач был мал. Зато 1024-битная шина при 128 ГБ/с уже тогда заметно опережала GDDR5. HBM1 заложила основу для всех следующих версий, хотя в продуктах пробыла недолго. Пример реализации — Radeon R9 Nano с четырьмя чипами HBM1.
HBM2 (2016)
Стандарт JEDEC вышел в 2016 году. В том же году Nvidia показала Tesla P100, а в 2017-м — V100. HBM2 стала рабочим стандартом для HPC и обучения нейросетей. Скорость выросла до 256 ГБ/с, слоёв в стеке стало до восьми, что удвоило ёмкость и пропускную способность. Появились поддержка ECC и более гибкое управление банками. По энергоэффективности на петабайт данных HBM2 в разы превзошла GDDR5X.
Где применялась:
- NVIDIA Tesla P100 — 16 ГБ, 4 стека;
- NVIDIA Tesla V100 — 32 ГБ, 4 стека HBM2 (чип GV100);
- AMD MI50 — 32 ГБ;
- процессор Fujitsu A64FX для суперкомпьютера Fugaku.
HBM2E (2019)
Формально это не отдельный стандарт JEDEC, а расширенная версия HBM2 образца 2019 года с повышенными скоростью и плотностью. Число слоёв выросло до двенадцати, что позволило делать стеки по 16 ГБ, а скорость поднялась до 460 ГБ/с. Этот шаг оказался критически важным для нынешнего ИИ-бума: 80-гигабайтная версия NVIDIA A100 с пятью стеками по 16 ГБ впервые позволила обучать модели масштаба GPT-2/3 на одном ускорителе без разбиения. Кроме того, HBM2E использовалась в процессорах Intel Xeon Max (64 ГБ) как встроенная высокоскоростная память, что показало универсальность подхода. В графическом процессоре GA100 ускорителя A100 физически размещено шесть стеков HBM2E.
HBM3 (2022)
Это первый стандарт, полностью разработанный с учётом требований ИИ-ускорителей; JEDEC утвердил его в начале 2022 года. Скорость выросла до 819 ГБ/с, заметно улучшился параллелизм запросов и снизились задержки при произвольном доступе. Объём стека достиг 24 ГБ, а для дата-центров стали обязательными сквозная коррекция ошибок и тонкое управление питанием на уровне банков. Первыми HBM3 получили ускорители NVIDIA H100 (80 ГБ, 5 стеков; в самом GPU GH100 предусмотрено шесть), затем она появилась в AMD Instinct MI300X и Google TPU v4.
HBM3E
Актуальный до недавнего времени флагман, расширяющий спецификацию HBM3. Массовые поставки SK Hynix начала в начале 2024 года для NVIDIA H200, и почти сразу HBM3E стала стандартом для новейших ускорителей Blackwell. Пропускная способность перешагнула порог в 1 ТБ/с, появились стеки на 24, 36 и 48 ГБ. Этого хватает для современных LLM с сотнями миллиардов параметров: можно собирать ускорители со 192 ГБ памяти и пропускной способностью около 8 ТБ/с на чипе, как у B200. Фактически именно HBM3E задаёт темп ИИ-гонки.
Примеры:
- NVIDIA H200 — 141 ГБ, 6 стеков, 4,8 ТБ/с;
- NVIDIA B200 — 192 ГБ, 8 стеков, до 8 ТБ/с;
- NVIDIA B300 — 288 ГБ, 8 стеков, до 8 ТБ/с;
- AMD MI350;
- Intel Gaudi 3.
HBM4
JEDEC утвердил стандарт в апреле 2025 года. К концу 2025-го SK Hynix завершила разработку и начала массовое производство, а в начале 2026 года к ней присоединились Samsung и Micron. Главное изменение — ширина шины на стек выросла вдвое, с 1024 до 2048 бит, и именно это даёт основной прирост пропускной способности. Второе новшество: базовый логический кристалл (Base Die) впервые выпускается не по техпроцессу памяти, а по передовым логическим нормам, 4–5 нм на фабриках TSMC. Это открывает путь к глубокой кастомизации под конкретного заказчика.
Пример применения — NVIDIA Vera Rubin: до 288 ГБ на GPU, 8 стеков по 36 ГБ, пропускная способность до 22 ТБ/с на GPU. На презентации Дженсен Хуанг показывал процессоры Rubin и Vera, причём у Rubin восемь стеков HBM4.
HBM4E
Это форсированное расширение HBM4, которое Samsung впервые показала на GTC 2026. Оно ориентировано на следующее поколение ускорителей — NVIDIA Rubin Ultra. Параметры: до 64 ГБ на стек и 4,0 ТБ/с. Для самого Rubin Ultra ожидается до 384 ГБ на GPU при 16-слойных стеках и до 64 ТБ/с совокупной пропускной способности.
Почему HBM лучше всего подходит для обучения ИИ
Обучение больших моделей — это непрерывный поток матричных умножений над огромными тензорами весов. Основная сложность — доставить веса и промежуточные активации к исполнительным блокам. Вычислять можно быстро, пока данные лежат в регистрах или SRAM-кеше, но крупная модель в них не помещается. Чем она больше, тем чаще приходится обращаться к основной памяти, а поскольку обучение идёт пакетами, чтение должно обеспечивать огромный throughput. HBM закрывает сразу три задачи.
- Пропускная способность. При 4–8 ТБ/с простой тензорных ядер сводится к минимуму.
- Объём. Даже для «старой» Llama 2 70B с весами в FP16 нужно минимум 140 ГБ только под параметры, не считая активаций и градиентов. Восемь стеков HBM3E дают до 192 ГБ на одном чипе, и это позволяет масштабироваться до кластеров без критических потерь пропускной способности на межсоединениях.
- Энергоэффективность. Каждый джоуль, сэкономленный на передаче данных от памяти к вычислительному ядру, можно потратить на сами вычисления. Благодаря коротким линиям и низкой частоте на контактах HBM передаёт бит в несколько раз экономичнее, чем GDDR.
Поэтому NVIDIA, AMD, Intel, Google и другие разработчики ИИ-чипов выбрали HBM как безальтернативный вариант для тренировки. В 2026 году, правда, ситуация начала меняться — об этом в разделе про аналоги.
Для сравнения: у Radeon RX 480 с графическим процессором Polaris 10 микросхемы GDDR5 распаяны вокруг GPU, а не на общей с ним подложке.
Кто производит HBM
На рынке сложилась жёсткая олигополия. Три компании — SK Hynix, Samsung и Micron — владеют технологией монолитных 3D-стеков DRAM. Сейчас все трое участвуют в гонке HBM4 и параллельно разрабатывают HBM4E. Главный «судья» — NVIDIA: именно её требования к скорости и качеству определяют, чьи чипы окажутся в ускорителях Vera Rubin.
- SK Hynix — безоговорочный лидер и главный выгодополучатель ИИ-бума. Первой начала массовое производство HBM4: в сентябре 2025 года она завершила разработку первого чипа и вышла на серию. Её 16-слойная HBM4 ёмкостью до 48 ГБ работает на скоростях свыше 2,9 ТБ/с, то есть с запасом выше стандарта JEDEC. Компания выпускает 70% HBM-чипов для Nvidia и поставляет память для AMD.
- Micron — поставляет Nvidia 16-слойные HBM4 до 48 ГБ с упором на повышенную энергоэффективность. После возвращения Samsung в гонку доля американской компании в отгрузках упала до 18%, но она остаётся одним из крупнейших производителей HBM в мире и поставляет память, в частности, AMD.
- Samsung — долго была отстающей, но сумела удовлетворить требования Nvidia и в феврале 2026 года начала коммерческие поставки 16-слойной HBM4 на 48 ГБ. По заявлению компании, её чипы работают на 3,3 ТБ/с, что примерно на 46% выше отраслевого стандарта в 8 Гбит/с, с возможностью разгона до 13 Гбит/с. Объёмы пока невелики, но Samsung строит заводы для утроения выпуска и ведёт разработку HBM4E со скоростью до 4 ТБ/с на стек.
Плюсы и минусы HBM
Сильные стороны:
- пропускная способность на ватт — решающее преимущество, когда ЦОДы упираются в лимиты мощности на стойку;
- близость к ядру — минимальные физические задержки и мало буферных каскадов;
- компактность — на подложке освобождается место для дополнительных вычислительных кластеров или стеков HBM;
- масштабируемость — на том же числе контактов интерпозера можно последовательно удваивать пропускную способность и объём.
Слабые стороны:
- стоимость. Стеки с TSV, тестирование на пластине, сборка на интерпозер и жёсткие требования к термомеханической совместимости материалов делают HBM в разы дороже GDDR в пересчёте на гигабайт. Поэтому в массовых игровых картах её не используют;
- охлаждение. Вертикальные стопки выделяют тепло неравномерно, а разные коэффициенты теплового расширения кремния, микробампов и заполнителя приводят к механическим повреждениям. Обеспечить долгосрочную надёжность при рабочих температурах около 95 °C непросто;
- негибкость объёма. Добавить памяти или заменить блок на более ёмкий нельзя: конфигурация закладывается на этапе производства ускорителя;
- выход годных. Дефект в критическом TSV или соединении стека бракует всю дорогую сборку. Выход улучшается, но остаётся ниже, чем у дискретной DRAM.
HBM в процессорах и потребительских видеокартах
Когда индустрия оценила возможности HBM, её попытались применить и в серверных CPU, и в потребительских GPU.
Серверные процессоры
- Fujitsu A64FX (2020). Энергоэффективная архитектура Arm и 32 ГБ HBM2 на борту с пропускной способностью 1 ТБ/с. Процессоры стали прорывом для своего времени и использовались в суперкомпьютере Fugaku.
- Intel Xeon Max (спустя два года). 64 ГБ HBM2E со скоростью 1 ТБ/с; Intel искусственно снизила скорость HBM2E ради стабильности. Чипы ориентировали на HPC, но решение провалилось из-за неадекватной цены и высокой конкуренции.
- AMD MI300A (2023). APU для суперкомпьютера El Capitan, который объединил на одной подложке CPU, GPU и 128 ГБ HBM3 с пропускной способностью 5,3 ТБ/с.
Потребительские видеокарты
Здесь история поучительная. После неудачных релизов Radeon R9 Fury с 4 ГБ HBM и Radeon VII с 16 ГБ HBM2 в AMD поняли: в обычных видеокартах высокоскоростная память неуместна. Высокая стоимость полностью перебивает избыточный прирост скорости в пользовательских задачах, а им вполне хватает GDDR. Повторять за AMD никто не стал, и HBM окончательно ушла в серверный сегмент.
Альтернативы HBM
В 2026 году в поле зрения ИИ-индустрии всё чаще появляются технологии, которые должны заменить дорогую высокоскоростную память, сохранив или даже расширив её скоростные показатели.
| Технология | Суть | Ключевые данные |
|---|---|---|
| HB3DM (Hybrid Bonded 3D Memory) | Проект SAIMEMORY и Intel: 9-слойные стеки DRAM на базе ZAM с прямым гибридным соединением слоёв без микробампов | До 5,3 ТБ/с, энергопотребление ниже на 40% относительно HBM4; прототип в 2027 году, коммерциализация в 2029-м |
| HBF (High Bandwidth Flash) | Быстрый DRAM-буфер и массив плотной флеш-памяти в одной 3D-стопке | Для задач, где важен огромный объём при высокой пропускной способности, например инференс сверхбольших моделей |
| HiZQ HBM | Аналог HBM2E/HBM3 от китайской CXMT, позиционируется как альтернатива подсанкционным чипам HBM | Легла в основу ИИ-ускорителей Huawei Atlas 950PR |
Что это значит при выборе оборудования
Для практики из всего этого следует несколько выводов.
- Если вы планируете обучение или дообучение крупных моделей, смотрите не только на TFLOPS, но и на объём и пропускную способность памяти ускорителя: именно они определяют, поместится ли модель и будет ли GPU загружен.
- Объём HBM нельзя нарастить после покупки, поэтому его нужно закладывать сразу, с запасом под активации и градиенты.
- Для задач, где не требуется HBM, например инференса моделей умеренного размера, часто достаточно ускорителей с GDDR: они заметно дешевле.
Подобрать серверную платформу под вашу нагрузку поможет «СервакМастер»: посмотрите раздел серверов и ИИ-серверов или свяжитесь с нами, и мы подскажем конфигурацию под вашу задачу и бюджет.
Выводы
HBM по праву можно назвать краеугольным камнем ИИ-индустрии: от доступности и эффективности этой памяти зависит, смогут ли поставщики ИИ-чипов создавать решения для самых сложных задач и масштабировать нагрузки. Путь HBM начинался в потребительских видеокартах, но сегодня она полностью заняла серверный сегмент, и возвращаться к истокам вряд ли будет. При этом на горизонте уже появляются конкуренты в лице HB3DM и HBF, которые претендуют на роль не только более быстрой, но и более экономичной альтернативы.