
Почему выбор GPU сложнее, чем кажется
Каталог серверных ускорителей устроен недружелюбно: десятки моделей, несколько параллельных линеек, названия, которые ничего не говорят непосвящённому, и характеристики, по которым трудно понять, что из этого нужно именно вам.
Хуже того — привычная логика «дороже значит лучше» здесь работает плохо. Ускоритель за миллион может оказаться неподходящим для задачи, с которой справится карта втрое дешевле. И наоборот: экономия на объёме памяти способна сделать покупку бесполезной целиком, потому что нужная модель просто не запустится.
Разберёмся, от чего действительно отталкиваться при выборе.
Главный параметр: объём видеопамяти
Начнём с того, что определяет саму возможность работы.
Чтобы нейросеть работала, она должна поместиться в память ускорителя. Не поместилась — не запустится вовсе или уйдёт в подкачку через системную память, что замедлит работу на порядок и обесценит всю мощность карты.
Грубая прикидка для языковых моделей: количество параметров, умноженное на размер одного параметра в байтах, плюс запас на промежуточные вычисления и контекст. При квантовании до 8 бит каждый параметр занимает примерно байт, при 4-битном — вдвое меньше.
Отсюда практический вывод: сначала определите, какие модели вы планируете запускать, и посчитайте нужный объём памяти. И только потом смотрите на производительность. Карта с высокими показателями в тестах, но недостаточной памятью, для вашей задачи бесполезна.
Второй момент — пропускная способность памяти. Для инференса языковых моделей она часто важнее вычислительной мощности: генерация каждого токена требует прочитать веса модели, и скорость определяется тем, как быстро эти веса проходят через шину памяти.
Как устроены линейки
У NVIDIA несколько параллельных семейств, решающих разные задачи. Понимание логики разделения снимает половину вопросов.
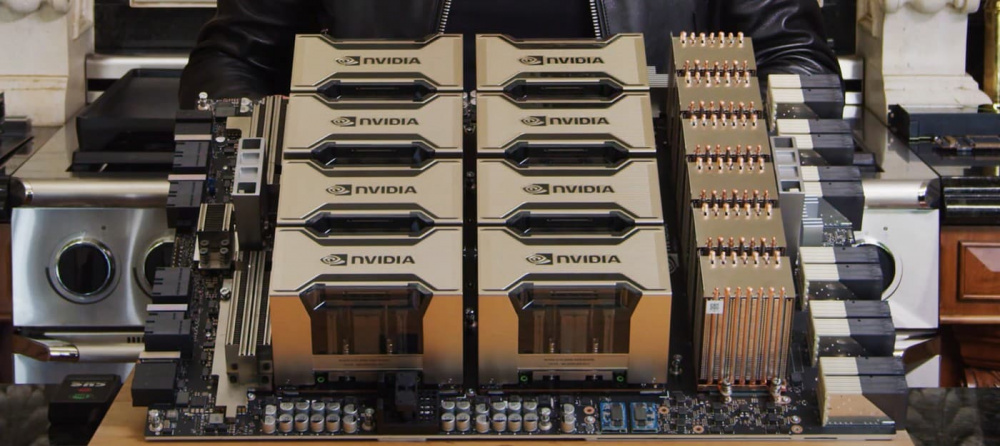
Ускорители для дата-центров под обучение. Флагманский сегмент: максимум памяти с высочайшей пропускной способностью, поддержка быстрого соединения между картами, форм-фактор под специализированные шасси. Это машины для обучения крупных моделей и тяжёлого инференса. Дорого, требовательно к питанию и охлаждению, обычно недоступно в виде отдельной карты в стандартный сервер.
Универсальные ускорители в формате платы расширения. Устанавливаются в обычный сервер, питаются от него, не требуют экзотического охлаждения. Компромисс между производительностью и совместимостью. Основной выбор для инференса и умеренных вычислительных задач.
Компактные ускорители под инференс. Карты с низким энергопотреблением и малой высотой, рассчитанные на плотную установку. Оптимизированы под обработку большого количества параллельных запросов к сравнительно небольшим моделям, а также под видеоаналитику и транскодирование.
Профессиональные графические карты. Изначально для рабочих станций: визуализация, рендеринг, инженерные приложения. Применяются и для вычислений, особенно там, где нужен большой объём памяти при умеренном бюджете.
Сопоставление по задачам
| Задача | Что критично | Направление выбора |
|---|---|---|
| Обучение крупных моделей | Максимум памяти, скорость связи между картами | Флагманские решения для ЦОД |
| Дообучение под свои данные | Достаточный объём памяти, умеренная цена | Универсальные карты расширения |
| Инференс средних моделей | Пропускная способность памяти | Универсальные или компактные |
| Инференс лёгких моделей, много запросов | Энергоэффективность, плотность | Компактные ускорители |
| Компьютерное зрение, видеопотоки | Аппаратное кодирование, умеренная мощность | Компактные ускорители |
| 3D-рендеринг, визуализация | Объём памяти, графические возможности | Профессиональные графические |
| Научные расчёты с двойной точностью | Производительность FP64 | Флагманские для ЦОД |
Обратите внимание на последнюю строку: для вычислений с двойной точностью подходят далеко не все ускорители. У карт, оптимизированных под нейросети, производительность FP64 может быть намеренно ограничена — для инженерных расчётов это делает их непригодными.
NVLink: когда он нужен, а когда нет
Технология быстрого соединения между ускорителями регулярно становится источником переплаты.
Зачем нужна. Когда модель не помещается в память одной карты, её распределяют между несколькими. Карты постоянно обмениваются данными, и обычная шина PCIe становится узким местом. NVLink даёт кратно большую пропускную способность между ускорителями.
Когда действительно необходима. Обучение крупных моделей, распределённых на несколько карт. Инференс моделей, не помещающихся в одну карту.
Когда не нужна. Если каждая карта работает со своей копией модели независимо — а это типичный сценарий инференса, — ускорители между собой почти не общаются. Платить за NVLink в такой конфигурации бессмысленно.
Проверьте по своему сценарию: карты работают над одной задачей совместно или каждая обрабатывает свои запросы? От ответа зависит, нужна ли переплата.
Сеть и обвязка: то, о чём вспоминают поздно
Ускорители не работают в вакууме. Несколько моментов, которые обесценивают дорогую покупку, если их упустить.
Питание. Конфигурация с несколькими ускорителями требует блоков питания соответствующей мощности и подходящего шасси. Мощный ускоритель в сервере со слабым питанием не заработает или будет сбрасывать частоты.
Охлаждение. Серверные ускорители в большинстве своём пассивные: у них нет собственных вентиляторов, они рассчитаны на продув корпусными. В шасси, не предназначенном для GPU, такая карта перегреется.
Процессор и системная память. Их задача — успевать подавать данные ускорителю. Слабый процессор превращается в узкое место: дорогой GPU простаивает в ожидании данных.
Хранилище. При обучении датасет читается постоянно. Медленные диски тормозят весь процесс независимо от мощности ускорителя.
Сеть между узлами. Для распределённых вычислений на нескольких серверах пропускная способность сети становится определяющей. Обычная сеть здесь недостаточна.
Пять ошибок при выборе
Ориентироваться на терафлопсы. Цифра пиковой производительности из спецификации достигается в синтетических условиях и слабо связана с реальной скоростью на вашей задаче. Смотрите на объём и пропускную способность памяти.
Экономить на памяти. Самая дорогая ошибка. Недостаточный объём означает, что нужная модель не запустится — и вся экономия обесценивается.
Покупать флагман под скромную задачу. Для инференса небольшой модели старший ускоритель избыточен. Деньги уйдут в мощность, которая не будет использоваться.
Забыть про обвязку. Ускоритель в сервере с неподходящим питанием, охлаждением или слабым процессором не даст расчётной производительности.
Игнорировать программную совместимость. Проверьте, что ваш стек — фреймворки, версии драйверов, библиотеки — поддерживает выбранное поколение карт. Особенно это касается старых моделей с вторичного рынка: поддержка новых версий ПО для них может быть уже прекращена.
Порядок выбора
Последовательность, которая экономит бюджет:
- Определите модели, которые будете запускать, и посчитайте требуемый объём памяти с запасом.
- Уточните характер нагрузки: обучение или инференс, одна модель на несколько карт или независимые копии.
- Проверьте требования к точности вычислений — нужна ли двойная точность.
- Оцените ограничения площадки: доступная мощность питания, возможности охлаждения, тип шасси.
- Подберите ускоритель, закрывающий требования по памяти, — и только затем сравнивайте производительность в рамках подходящих вариантов.
- Проверьте обвязку: питание, охлаждение, процессор, хранилище.
Коротко
Выбор серверного ускорителя начинается не с производительности, а с объёма памяти: он определяет, какие модели вы вообще сможете запустить. Для инференса языковых моделей пропускная способность памяти обычно важнее вычислительной мощности.
Линейки различаются по назначению, а не только по цене: флагманы для обучения, универсальные карты расширения, компактные ускорители под инференс, профессиональная графика. Дорогое решение не универсально лучше — оно лучше в своей нише.
NVLink нужен, когда карты работают над одной задачей совместно. Если каждая обрабатывает свои запросы независимо — это лишняя статья расходов.
И последнее: ускоритель работает ровно настолько хорошо, насколько ему позволяет остальной сервер. Питание, охлаждение, процессор и диски должны соответствовать.
Если нужно подобрать конфигурацию под конкретные модели и бюджет — опишите задачу, поможем рассчитать требования и предложим вариант без переплаты.