
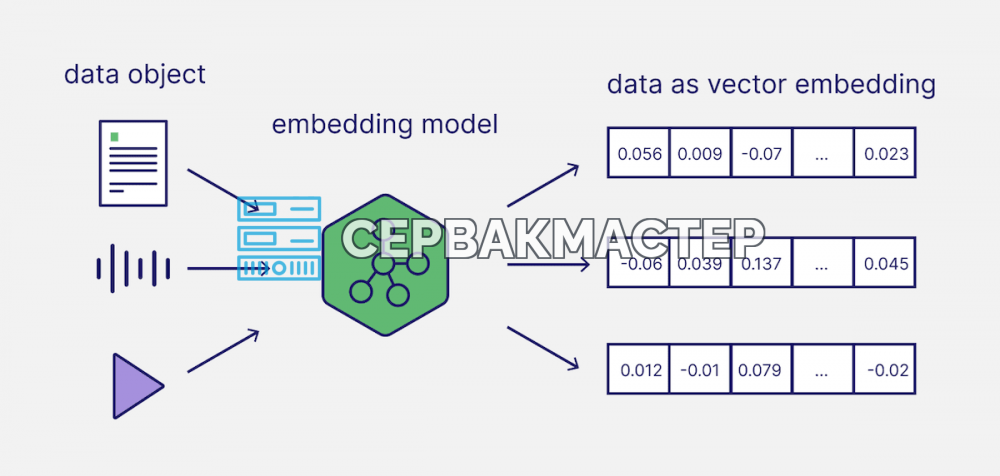
Чтобы понять, как нейросеть работает со словами, фразами и целыми документами, нужно познакомиться с одним ключевым механизмом — эмбеддингами. Именно они переводят язык в математику, и благодаря им модель ведёт себя так, будто действительно понимает написанное. Термин звучит всё чаще, но объясняют его редко. В этой статье специалисты «СервакМастер» разбирают, что такое эмбеддинги, как устроена векторизация, почему на ней держатся RAG-системы и чем всё это важно при локальном развёртывании LLM.
Что такое эмбеддинги
Эмбеддинг — это векторное представление объекта: слова, фразы, документа, изображения или звука. Проще говоря, смысл объекта записывается набором чисел. Здесь сходятся два связанных явления:
- нейросеть сжимает сложный объект до компактного вектора фиксированной длины, например из 768 или 4096 чисел;
- расстояние между двумя такими векторами показывает, насколько объекты близки по смыслу.
Возьмём слово «кофе». Рядом с его вектором в пространстве окажутся «чай», «капучино» и «эспрессо», а вот «процессор», «материнка» или «Linux» будут лежать далеко.
В машинном обучении эмбеддинги стали базовым инструментом: они переводят тексты, изображения, видео и звуки с человеческого представления на язык математики, понятный машине. Можно думать о них как о координатах в многомерном смысловом пространстве: чем ближе точки, тем теснее связаны по смыслу соответствующие слова.
Как работает векторизация текста
Получение эмбеддингов называют векторизацией текста. Всё начинается с токенизации: текст режется на минимальные единицы, с которыми работает модель. Это могут быть слова, части слов или отдельные символы. Затем токены проходят через слои сети — внимание, линейные преобразования, нормализации и активации. На каждом шаге сеть выявляет статистические связи и размещает токены в многомерном пространстве так, чтобы близкие смыслы получали близкие координаты.
Главная ценность в том, что текст становится математическим объектом, а с векторами можно выполнять точные операции:
- измерять расстояние между ними;
- вычислять угол;
- находить ближайшие точки.
Поэтому «векторное пространство слов» — не красивая метафора, а рабочий вычислительный инструмент. Полученные векторы складываются в то самое векторное пространство, с которым модель работает напрямую. Если два предложения описывают похожее явление, их векторы окажутся рядом, даже когда формулировки совершенно разные.
Чем это отличается от старых методов
Классические подходы вроде bag-of-words и TF-IDF оценивали сходство по совпадению слов. Эмбеддинги сравнивают именно смыслы, и в этом их принципиальное преимущество.
Почему эмбеддинги важны для понимания смысла
Эмбеддинги — это не просто числа, а своего рода память смыслов, накопленная моделью. Знаний в человеческом понимании у модели нет, зато есть структура смысловой близости. Она позволяет:
- понимать контекст слов;
- оценивать смысловую совместимость фраз;
- обобщать на новых данных, которых не было в обучающей выборке.
Именно поэтому нейросеть справляется с тем, чего раньше не встречала. Без этого объёмы обучающих данных пришлось бы измерять не терабайтами, а зеттабайтами, и ИИ-индустрия, вероятно, не вышла бы из зачатка.
Контекст внутри вектора
Числа в эмбеддинге отражают контекст: соседние слова, стиль, роль токена, грамматику, тему, эмоциональную окраску. Увидев фразу «многопоточная производительность», модель может предположить, что речь о процессоре, хотя этого слова в запросе нет.
Поэтому в современных моделях эмбеддинг — не статическая таблица, а динамическое представление: значение токена зависит от окружения. Сам по себе токен ничего не значит, а его эмбеддинг в контексте значит всё. Любой разговор о «понимании» модели в итоге упирается в качество её эмбеддингов.
Поиск по смыслу
Семантический поиск знаком почти всем. Именно он помог Google и Яндексу заметно повысить эффективность: раньше запрос сравнивался со страницами по совпадению слов, и разная лексика приводила к промахам, а теперь нужная информация находится за считаные секунды. Тот же принцип работает и в ИИ, поскольку семантический поиск строится на векторизации данных.
Схема такая: и запрос, и документы превращаются в векторы, после чего система ищет точки, ближайшие к вектору запроса. Для этого применяют векторные базы данных — хранилища, оптимизированные под поиск ближайших соседей в многомерном пространстве. В них могут лежать миллионы и миллиарды векторов, а поиск занимает доли секунды.
Подход меняет сам взгляд на информацию: раньше искали совпадения по словам, теперь — по идеям. Точная формулировка не нужна, ошибки пользователя не мешают, а результат может оказаться таким, который человек и сам не сумел бы сформулировать, но который полностью отвечает его задаче.
Пример: по запросу «как улучшить скорость nginx» пользователь получит статью «оптимизация веб-сервера», даже если слова «nginx» в ней нет. В этом и сила поиска по эмбеддингам и векторным базам знаний.
RAG: как эмбеддинги помогают генерации
RAG (Retrieval-Augmented Generation) — архитектура, при которой нейросеть отвечает на вопросы, опираясь не только на собственные параметры, но и на внешние данные. Работает она в четыре шага:
- Пользователь задаёт вопрос.
- Система строит эмбеддинг запроса.
- В векторной базе знаний находятся релевантные документы.
- Они передаются в LLM, которая формирует итоговый ответ.
Иначе говоря, RAG — это не просто генерация, а сначала поиск по смыслу и только потом ответ.
Сильная сторона такого подхода в том, что он снижает число галлюцинаций и держит знания системы актуальными, даже если сама LLM обучена несколько лет назад. Без эмбеддингов всё это не заработало бы: именно векторизация связывает вопрос пользователя с данными, которые нужно извлечь. RAG уже стал стандартом для корпоративных ИИ-решений, чат-ботов, систем поиска по документам и локальных справочных ассистентов.
Эмбеддинги за пределами текста
Вектором можно описать почти любые данные, которые удаётся «сжать» до набора чисел, и тогда они пригодны для анализа.
Например, эмбеддинг изображения — это вектор, извлечённый визуальной нейросетью (обычно CNN или Vision Transformer). Он описывает содержание картинки: объекты, стиль, цветовую структуру. Благодаря этому модели ищут похожие фотографии, группируют товары по внешнему виду и решают задачи компьютерного зрения без ручной разметки.
Кроме того, эмбеддинги применяются:
- в музыке — для поиска по звучанию;
- в рекомендательных системах — вектор описывает интересы пользователя;
- в анализе графов.
По сути, это один из универсальных языков ИИ: общий формат данных, понятный разным моделям независимо от их датасета, числа параметров и токенизатора.
Примеры эмбеддингов в популярных моделях
Современные модели используют встроенные эмбеддинги и позволяют создавать собственные. Вот несколько распространённых случаев:
| Модель | Особенности эмбеддингов |
|---|---|
| LLaMA* | Собственные токеновые и позиционные эмбеддинги; можно подключать внешние генераторы векторов через мини-модели. Это позволяет строить семантические векторы слов, предложений и документов для локальных RAG-систем и точно сопоставлять смысловые фрагменты. |
| DeepSeek | Векторы ориентированы на технические, математические и программные домены. Модель строит точную семантическую структуру и выделяет логические и функциональные зависимости между концептами, что даёт точное ранжирование и поиск по смыслу в сложных инженерных задачах. |
| Gemma | Пространство эмбеддингов ориентировано на формализованные знания и строгую структуру. Векторы фиксируют технические и концептуальные связи между объектами, обеспечивая соответствие семантической структуры содержанию документа. |
| GPT-OSS | Универсальные текстовые эмбеддинги, совместимые с RAG и семантическим поиском. Векторы отражают контекстную и тематическую структуру текста, различают технические домены и обеспечивают согласованное положение переформулированных токенов в семантическом пространстве. |
Что это значит при выборе железа
Эмбеддинги и RAG — часть большинства локальных LLM-решений: нужно держать и саму модель, и векторную базу, и считать векторы для запросов. Под такие задачи обычно собирают GPU-сервер; готовые варианты можно посмотреть в разделе серверов для ИИ, а общий ассортимент — в каталоге серверов. Если нужно подобрать конфигурацию под конкретный сценарий, напишите нам через страницу контактов.
Выводы
Эмбеддинги — это язык, на котором нейросети понимают смысл ваших запросов. Они превращают текст, изображение или любую другую сущность в числовой вектор, который показывает модели, что именно означает объект и чем он похож на другие. Без них невозможны ChatGPT, DeepSeek, RAG-системы, семантический поиск, генераторы рекомендаций и любые локальные LLM-решения. Благодаря эмбеддингам модели оперируют не словами, а смыслами, и поэтому так хорошо улавливают, чего от них хотят пользователи.
Если хотите узнать больше о внутренней кухне искусственного интеллекта, заглядывайте в блог «СервакМастер»: мы пишем о технологиях и железе так, чтобы было понятно и разработчикам, и системным администраторам, и обычным пользователям.
*LLaMA — проект Meta Platforms Inc.**, деятельность которой в России признана экстремистской и запрещена
**Деятельность Meta Platforms Inc. в России признана экстремистской и запрещена