
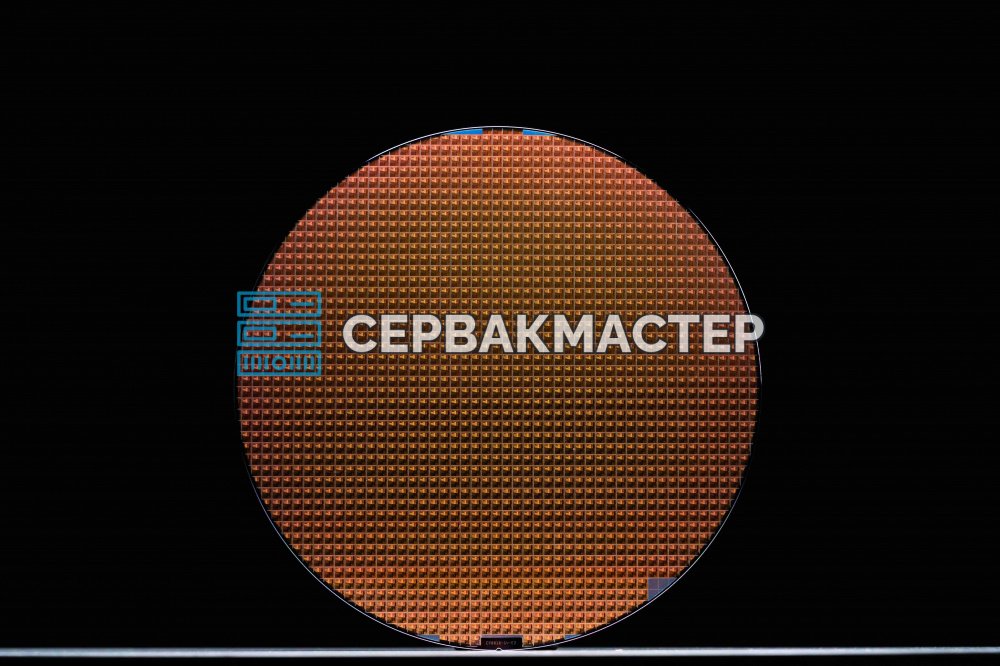
Ещё несколько лет назад рынок ИИ-ускорителей держали Nvidia и догоняющая AMD, а редкие корпоративные разработки вроде IBM нацеливались на государственные тендеры. Сегодня картина другая: у AWS есть Trainium, у Google — TPU, а сотни стартапов делают собственные чипы разной степени оригинальности. Американская Cerebras из их числа заметно выделяется: компания заключила контракты с OpenAI и готовится к IPO. Её главная особенность — «царь-чипы» размером со всю кремниевую подложку 300 мм. Разберём, откуда взялась Cerebras, как устроены её ускорители, что в них реально, а что вызывает вопросы, и какие выводы из этого стоит сделать при выборе серверного оборудования для ИИ.
Откуда взялась Cerebras
Cerebras — не очередной стартап с чипами «на бумаге». Компанию основали в 2015 году, ещё до выхода первого ИИ-ускорителя Nvidia P100, так что её по праву считают одним из пионеров современного железа для искусственного интеллекта. Основатели — Эндрю Фельдман, Гэри Лаутербах, Майкл Джеймс, Шон Ли и Жан-Филипп Фрикер. Все пятеро раньше работали в SeaMicro, основанной в 2007 году и купленной AMD в 2012 году за $334 млн.
SeaMicro делала энергоэффективные микросерверы с высокой плотностью компонентов. Например, SM10000 объединял до 512 процессоров Intel Atom Z530 в корпусе 10U. Это стало возможным благодаря сети Freedom Fabric на базе ASIC: она связывала сотни микропроцессоров в топологию 3D torus с пропускной способностью до 1,28 Тбит/с. Позднее эта разработка легла в основу AMD Infinity Fabric. Опыт плотной упаковки вычислений и борьбы с узкими местами межсоединений определил философию Cerebras: пока остальные режут пластину на сотни мелких чипов, она использует её целиком.
Как устроен Wafer-Scale Engine
В сообществе чипы называют «царь-чипами», а официально они именуются Wafer-Scale Engine (WSE). Это не кристалл, вырезанный из пластины, а практически вся подложка целиком.
Почему пластины режут на кусочки
Другие производители — Nvidia, AMD, Google — режут пластины не потому, что мелкие чипы работают эффективнее, а потому что иначе было нельзя. При изготовлении большой подложки отдельные участки логики всегда получаются с браком: при высокотемпературной обработке (окислении, диффузии) в кремнии возникают структурные дефекты, влияющие на проводимость и работоспособность. Если использовать пластину целиком, она была бы бракованной всегда. Поэтому нерабочие участки отбрасывают, а из удачных делают процессоры.
Как Cerebras обошла проблему брака
Вместо того чтобы подстраиваться под дефекты, инженеры Cerebras решили устранить саму проблему:
- уменьшили каждое вычислительное ядро до 0,05 мм² — примерно 1% от размера ядра Nvidia H100;
- добавили резервные ядра, которые заменяют дефектные;
- спроектировали внутричиповую коммуникационную ткань, которая маршрутизирует данные в обход неисправных участков.
В итоге влияние бракованных областей сводится к минимуму, а их общее число уменьшается, поэтому производство WSE фактически безотходное и экономически оправданное. Кроме того, когда память, вычисления и межсоединения расположены на одной подложке, исчезают узкие места, свойственные GPU с внешней памятью HBM и межчиповыми связями NVLink. Именно этим объясняется огромная скорость генерации токенов у WSE.
Три поколения WSE
За более чем десять лет Cerebras выпустила всего три поколения чипов, тогда как Nvidia за то же время сменила десять поколений GPU. Причина в нехватке финансирования: никто не верил, что инженеры из поглощённой AMD компании сделают что-то работоспособное, а идея использовать всю подложку выглядела слишком амбициозной. К тому же в 2015 году никто не ожидал ИИ-бума, и инвесторы вкладывали деньги в метавселенные и криптовалюты.
| Параметр | WSE-1 | WSE-2 | WSE-3 |
|---|---|---|---|
| Представлен | август 2019 (Hot Chips) | апрель 2021 | март 2024 |
| Техпроцесс TSMC | 16 нм | 7 нм | 5 нм |
| Площадь | 46 225 мм² | 46 225 мм² | 46 225 мм² |
| Транзисторы | 1,2 трлн | 2,6 трлн | 4 трлн |
| Ядра | 400 000 | 850 000 | 900 000 |
| Встроенная SRAM | 18 ГБ | 40 ГБ | 44 ГБ |
| Пропускная способность памяти | 9 ПБ/с | 20 ПБ/с | 21 ПБ/с |
| Система | CS-1 | CS-2 | CS-3 |
WSE-1
Первое поколение стало сенсацией: оно доказало, что чип размером с 300-мм пластину технически возможен и коммерчески оправдан. 400 000 ядер Sparse Linear Algebra (SLA) оптимизированы под операции с разреженными тензорами. Внутренняя сеть Swarm в виде двумерной mesh-сетки обеспечивала обмен данными между ядрами с суммарной пропускной способностью 100 Пбит/с и наносекундными задержками, полностью убирая бутылочное горлышко межчиповых соединений. Система CS-1 при потреблении около 20 кВт (с учётом охлаждения и вспомогательной электроники) давала производительность, эквивалентную сотням GPU, в корпусе одного сервера.
WSE-2
Второе поколение сохранило площадь, но благодаря 7-нм техпроцессу более чем вдвое увеличило число транзисторов и ядер. Пропускная способность SRAM достигла 20 ПБ/с — за секунду можно передать объём данных, эквивалентный 5 000 фильмов в 4K. Пропускная способность внутренней сети выросла до 220 Пбит/с. На базе CS-2 стала доступна облачная платформа, и именно на нём построили суперкомпьютеры серии Condor Galaxy, включая Condor Galaxy 1 производительностью 4 EFLOPS.
Возникает закономерный вопрос: почему Condor Galaxy 1, мощнее El Capitan с его 1,7 EFLOPS, нет в TOP500? Ответ прост: рейтинг учитывает системы с вычислениями двойной точности FP64 (LINPACK), а WSE оптимизированы под разреженные тензоры и предназначены только для ИИ. Поэтому ни эта, ни любая другая система на WSE в TOP500 не попадёт — это не признак «скама», а следствие специализации.
WSE-3
Третье поколение — самый мощный одиночный чип в истории. 4 триллиона транзисторов — мировой рекорд; для сравнения, в Nvidia B200 их 208 миллиардов. Все 900 000 ядер заточены под ИИ: низкую точность (FP8, FP16), разреженные вычисления и паттерны доступа к памяти, типичные для трансформеров. Пропускная способность памяти в 21 ПБ/с более чем в 7 000 раз превышает показатель HBM3e у Nvidia H100. Пиковая производительность в FP16 — 125 PFLOPS, что примерно соответствует 3,5 серверам Nvidia DGX B200, но при вдвое меньшем энергопотреблении и в одном корпусе CS-3.
На WSE-3 основаны все современные достижения Cerebras в быстром инференсе, включая рекорды на Llama 3.1 405B и Llama 4 Maverick 400B, а также многомиллиардные контракты с OpenAI и AWS. По сравнению с WSE-2 число ядер и объём памяти выросли более чем вдвое, а по сравнению с WSE-1 число транзисторов выросло более чем в четыре раза, а пропускная способность памяти — почти в пять раз.
Аппаратная экосистема: CS-3, MemoryX и облако
WSE-3 нельзя купить и поставить в обычный сервер — он поставляется только в составе готовой системы CS-3. Это 16U-сервер с одним WSE-3, подключённым к внешней памяти MemoryX на DRAM DDR5 и NAND объёмом от 12 ТБ до 1,2 ПБ. Это позволяет работать с моделями до 24 триллионов параметров на одном ускорителе без сложного распределённого инференса.
Остаётся открытым вопрос, как сохраняется высокая скорость при подаче данных из относительно медленной DRAM в быструю, но всего 44-гигабайтную SRAM. Компания ответа не даёт, и это дополнительный повод для скепсиса у критиков.
Одна CS-3 потребляет 23 кВт, поэтому нужны жидкостное охлаждение, мощная подсистема питания и интерконнекты между чипами и стойками. Крупные заказчики и исследовательские организации могут купить CS-3 для собственных ЦОД. Цена официально не раскрывается, по некоторым данным, она составляет $2–3 млн, тогда как DGX B200 обойдётся примерно в $500 000.
Тем, кто не готов к капитальным затратам, доступна Cerebras Cloud — через API напрямую или через платформы AWS, Vercel и OpenRouter. Тарифы и скорость:
| Модель | Скорость | Вход, за 1 млн токенов | Выход, за 1 млн токенов |
|---|---|---|---|
| ZAI GLM 4.7 | ~1000 токенов/с | $2,25 | $2,75 |
| GPT OSS 120B | ~3000 токенов/с | $0,35 | $0,75 |
| Llama 3.1 8B | ~2200 токенов/с | $0,10 | $0,10 |
| Qwen 3 235B Instruct | ~1400 токенов/с | $0,60 | $1,20 |
На OpenRouter скорость инференса GLM 4.7 на мощностях Cerebras достигает 382 токенов в секунду, тогда как в API Google Vertex — лишь 97. За такую скорость Cerebras просит больше, но заметно это только на выходных токенах (около $2,12 за миллион), а входные стоят сопоставимо с конкурентами ($0,12 за миллион). Это может намекать на архитектурные ограничения стоек CS-3. Кроме того, список моделей невелик и далеко не самый свежий: GLM 4.7, GPT OSS 120B, Llama 3.1 8B и Qwen 3 235B Instruct. Причина в специфике чипов — каждую модель приходится долго адаптировать для запуска на WSE-3.
Финансы и перспективы
2026 год стал для Cerebras годом выхода на публичный рынок. 17 апреля 2026 года компания подала заявку на первое IPO с оценкой около $35 млрд (для сравнения, капитализация Intel — $339 млрд). Выручка выросла с $246 млн в 2022 году до $5,1 млрд в 2025 году, причём 2025-й стал первым прибыльным: чистая прибыль составила $2,38 млрд против убытка в $4,85 млрд годом ранее.
Главный драйвер роста — контракты с технологическими гигантами:
- OpenAI. Соглашение на сумму более $20 млрд предусматривает развёртывание 750 мегаватт мощностей Cerebras для инференса моделей OpenAI — это крупнейшее в мире развёртывание высокоскоростного ИИ-инференса. Дополнительно OpenAI предоставила Cerebras кредит $1 млрд в обмен на право получить до 10% акций компании.
- AWS. В марте 2026 года Amazon предложила гибридную схему: собственные чипы Trainium обрабатывают префилл, а Cerebras CS-3 берёт на себя декодирование. Это даёт скорость в 25 раз выше, чем у GPU Nvidia в сопоставимых конфигурациях.
Риски
- Концентрация выручки. Зависимость от нескольких мегаклиентов сохраняется. Если OpenAI, активно диверсифицирующая поставщиков железа, перейдёт на другие решения или собственные чипы, бизнесу Cerebras будет угрожать серьёзная опасность.
- Предел масштабирования. WSE уже занимает целую 300-мм пластину, увеличивать чип дальше физически невозможно. Рост производительности возможен лишь за счёт числа систем в кластере, а это возвращает проблемы межсоединений, от которых Cerebras пыталась уйти.
- Конкуренция. Nvidia по-прежнему занимает около 70% рынка, активно действуют Google TPU, Amazon Trainium и десятки стартапов, каждый со своим подходом.
Выводы и что это значит для выбора оборудования
Cerebras — не афера, а настоящая инженерная революция, нашедшая свою нишу и доказавшая коммерческую состоятельность. Компания решила задачу, которую десятилетиями считали нерешаемой: создала работоспособный и экономически выгодный чип размером с пластину. В специфических задачах инференса сверхбольших языковых моделей такая архитектура действительно на порядки превосходит традиционные GPU. Контракты с OpenAI (в тексте оригинала упоминалась и сумма свыше $100 млрд) и с AWS на гибридные развёртывания показывают, что крупнейшие игроки видят в технологии реальную ценность, а не маркетинговую иллюзию.
Но Cerebras — не «убийца Nvidia» и не универсальная замена GPU. Это узкоспециализированный инструмент с ограниченной гибкостью и высокими капитальными затратами: система стоит миллионы долларов, требует жидкостного охлаждения и 23 кВт на стойку, а набор поддерживаемых моделей невелик.
Для большинства компаний практический вывод такой: если нужны универсальность, возможность запускать любые модели, обучать и дообучать их, выбор по-прежнему лежит в области GPU-серверов. Wafer-scale-системы имеет смысл рассматривать как облачный сервис для сверхбыстрого инференса, а не как оборудование для собственной стойки. Подобрать конфигурацию под вашу ИИ-нагрузку поможет «СервакМастер»: посмотрите ИИ-серверы и серверы общего назначения либо свяжитесь с нами для расчёта сборки.