
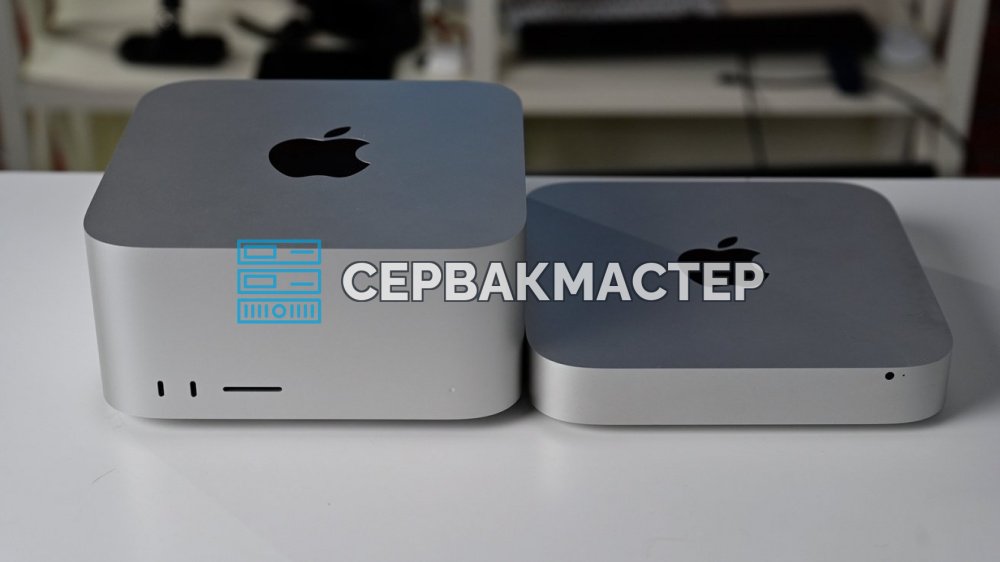
Ещё пару лет назад словосочетание «Mac для искусственного интеллекта» вызывало улыбку: весь ИИ-мир жил на CUDA, ускорителях NVIDIA и AMD и боролся за каждый гигабайт видеопамяти, а яблочные компьютеры годились для разработки мобильных приложений, DevOps, лёгкого рендеринга и в лучшем случае для запуска небольших LLM. Сегодня картина другая. Полноценную домашнюю лабораторию для инференса и прототипирования можно собрать на обычном Mac примерно за пару тысяч долларов, тогда как топовые ИИ-ускорители стоят от десяти тысяч. Не нужно разбираться с Linux и CUDA: взяли Mac Studio или даже Mac mini, поставили софт, и можно работать. Ниже мы разберём, чем именно Apple Silicon подходит для нейросетей, какую модель Mac выбрать, что с программным стеком и как строить кластеры.
Почему Apple Silicon хорошо подходит для ИИ
Секрет не в том, что Apple выпустила ещё один быстрый процессор. Компания пересобрала сам способ взаимодействия CPU, графики и памяти, а программный стек достраивает эту архитектуру.
Унифицированная память вместо копирования данных
В классическом ПК или сервере данные сначала попадают в оперативную память, а затем, чтобы GPU мог с ними работать, копируются в видеопамять. Копирование добавляет задержки, тратит энергию и ограничивает производительность, а в задачах ИИ, где объёмы данных измеряются гигабайтами, это особенно заметно.
В чипах серии M всё устроено иначе:
- CPU, GPU и нейроускоритель NPU расположены на одной подложке по принципу SoC;
- все блоки обращаются к единому пулу унифицированной памяти через очень широкую шину;
- данные хранятся в одном месте и доступны любому вычислительному блоку без лишнего копирования.
Для больших языковых моделей это означает меньше задержек и более предсказуемую работу.
Объём и скорость памяти
Объём видеопамяти даже у профессиональных карт ограничен. У NVIDIA RTX PRO 6000 Server Edition он составляет 96 ГБ, у ускорителя H200 — до 144 ГБ, а стоимость одной такой карты начинается от 10–20 тысяч долларов. На Mac с чипом M3 Ultra можно получить до 512 ГБ унифицированной памяти, причём конфигурация Mac Studio обойдётся примерно в 7–8 тысяч долларов. Половина терабайта доступна одновременно CPU, GPU и NPU. Для сравнения: в топовом ускорителе NVIDIA B200 всего 192 ГБ, то есть у Mac почти втрое больше.
Пропускная способность памяти у Mac Studio с M3 Ultra достигает 819 ГБ/с, что сопоставимо с топовыми десктопными видеокартами уровня RTX 5090. На практике это позволяет запускать модели класса 70B:
| Квантование | Объём модели 70B |
|---|---|
| 4 бита | около 35 ГБ |
| 8 бит | около 70 ГБ |
И всё это без распределения модели между несколькими GPU: вы просто загружаете её и работаете.
Как устроена память физически
Память в Apple Silicon не стоит в слотах, как на десктопе. Это LPDDR (Low-Power Double Data Rate), распаянная прямо на подложке процессора, а в некоторых конфигурациях интегрированная в упаковку чипа. Так достигаются высокая плотность, скорость передачи данных и энергоэффективность. Контроллер памяти при этом имеет не 2 или 4 канала, а 32.
UltraFusion
Старшие чипы линейки Ultra Apple делает не одним гигантским кристаллом, что было бы сложно и дорого, а из двух кристаллов Max, соединённых интерконнектом UltraFusion. Это не PCI Express и не NVLink от NVIDIA, а значительно более плотная и быстрая шина. Операционная система и приложения видят один чип с удвоенным числом ядер и единым адресным пространством памяти.
ARM NEON
Процессорные ядра построены на архитектуре ARMv8 и поддерживают инструкции ARM NEON — аналог AVX в мире x86, важный для быстрых вычислений в нейросетях. Благодаря NEON и большому объёму быстрой унифицированной памяти LPDDR даже расчёты на CPU выполняются эффективно.
Программный стек: Metal, MPS, MLX и Neural Engine
Железо без софта бесполезно, и здесь у Apple тоже есть что предложить.
Metal и Metal Performance Shaders
Metal — низкоуровневый графический API Apple, аналог DirectX 12 или Vulkan, но заточенный под её железо. Для ИИ он важен прежде всего возможностями GPGPU, то есть использованием видеоускорителя для произвольных вычислений, включая операции с плавающей запятой (FP32, FP16) и INT8. Язык Metal Shading Language (MSL), диалект C++, позволяет писать ядра (kernel functions), выполняемые на GPU, и вручную реализовывать алгоритмы машинного обучения под конкретную модель.
Писать низкоуровневый код для сверток и слоёв внимания каждый раз долго и сложно, поэтому Apple создала библиотеку Metal Performance Shaders (MPS) — набор оптимизированных алгоритмов обработки изображений и машинного обучения. Они учитывают особенности архитектуры Apple GPU, включая широкий векторный движок и иерархию памяти.
MLX
Настоящим прорывом стал MLX — open-source фреймворк машинного обучения, который исследовательское подразделение Apple создало специально для Apple Silicon. Это не просто обёртка над Metal: он проектировался с нуля с учётом унифицированной памяти.
- API напоминает NumPy и PyTorch, поэтому переход даётся исследователям легко.
- Операции выполняются на CPU или GPU без копирования данных, так как они уже лежат в общей памяти.
- Поддерживаются автоматическое дифференцирование, ленивые вычисления и динамические графы.
- Поверх MLX построен пакет MLX LM, позволяющий одной командой запустить любую модель с Hugging Face.
Показательный пример: DeepSeek с 670 миллиардами параметров требует около 380 ГБ памяти даже в 4-битном квантовании, и Mac Studio с 512 ГБ справляется с ним без проблем.
Neural Engine и Core ML
В SoC Apple есть и специализированные NPU-блоки — Neural Engine. Это отдельный сопроцессор для матричных умножений, свёрток и функций активации. Он работает в форматах FP16 и INT8 и очень экономичен по энергии. Доступ к нему открывает фреймворк Core ML: разработчик конвертирует модель из PyTorch или TensorFlow в формат Core ML, а система сама решает, где её запускать — на CPU, GPU или Neural Engine, чтобы получить максимум производительности при минимуме энергопотребления. Для тяжёлых LLM чаще задействуют GPU благодаря его мощности и гибкости, а Neural Engine отлично справляется с обработкой фото и распознаванием речи.
Компактность и энергопотребление
Под нагрузкой Mac потребляет радикально меньше, чем профессиональные GPU-ускорители. Mac Studio при полной загрузке расходует 150–200 Вт, тогда как одна NVIDIA RTX 6000 Blackwell может доходить до 600 Вт. Поэтому такой компьютер можно поставить в офисе, лаборатории или на рабочем столе без специальной инфраструктуры, внешнего охлаждения и выделенных линий питания. Он тихий, компактный и не превращает комнату в сауну.
Эти же свойства позволяют ставить несколько Mac Studio рядом на обычном стеллаже или в стандартной 19-дюймовой стойке с помощью специальных корзин (например, от Sonnet): при минимальном притоке воздуха машины не перегреваются.
Apple во многом была пионером идеи компактного ИИ-компьютера. Mac mini, Mac Studio и Mac Pro появились ещё до того, как NVIDIA выпустила Spark, а AMD представила решения на базе Minisforum. Первые компактные Mac не создавались для ИИ, но концепцию настольных рабочих станций придумала именно Apple, а ИИ-боксы позднее её развили.
Какой Mac выбрать
Три ключевые линейки компактных ИИ-компьютеров Apple решают разные задачи.
| Модель | Для чего подходит | Ключевые данные |
|---|---|---|
| Mac Studio | Домашний ИИ-инференс без компромиссов, модели 70B, 200B и даже 600B+ | Единственный Mac с чипом M3 Ultra и 512 ГБ памяти; 32-ядерный CPU, 80-ядерный GPU, 819 ГБ/с |
| Mac mini | Недорогой вход в ИИ-разработку, стартапы и энтузиасты | Чипы Apple M4, 32 ГБ LPDDR, TDP 64 Вт |
| Mac Pro | Максимальная гибкость расширения | Тот же чип M3 Ultra, что и в Studio, но есть слоты PCIe |
Mac Studio
Это безусловный лидер для домашнего инференса: в компактном корпусе скрывается начинка уровня рабочих станций. Если вы работаете с моделями 70B, 200B или 600B+ параметров, выбирать нужно именно его.
Mac mini
Рабочая лошадка на чипах Apple M4. Объём памяти всего 32 ГБ LPDDR, но для прототипирования, запуска небольших моделей (до 13–20B параметров) и тонкой настройки методом LoRA этого более чем достаточно. Благодаря очень низкому TDP в 64 Вт Mac mini особенно хорош для сборки кластеров.
Mac Pro
Башенный форм-фактор для тех, кому важно расширение. Чип M3 Ultra у него тот же, что у Studio, зато есть слоты PCIe для специализированных ускорителей, мощных сетевых карт и вместительных SSD.
Кластеры из Mac
Долгое время системные администраторы и линуксоиды видели в Mac лишь «бокс для дизайнеров». Новые модели меняют отношение: их всерьёз рассматривают для высокопроизводительных кластеров, потому что появился RDMA (Remote Direct Memory Access) поверх Thunderbolt. RDMA позволяет одной машине читать и писать в память другой напрямую, минуя её процессор. Кроме того, в Mac с M3 Ultra впервые появился Thunderbolt 5 с пропускной способностью 80 Гбит/с, а в некоторых режимах до 120 Гбит/с. В итоге кластер на базе Mac передаёт данные практически без задержек, что открывает путь к развёртыванию очень крупных моделей.
В последние годы такие кластеры стали особенно популярны: пользователи объединяют десятки компактных ИИ-ПК и запускают на них ИИ-агентов (например, OpenClaw), получая автономную инфраструктуру, способную решать рабочие задачи любой сложности в режиме 24/7.
Чего ждать от Apple M5 Ultra
На момент написания статьи Apple уже выпустила базовый чип M5, но индустрия ждёт M5 Ultra, выход которого ожидается в начале 2026 года. По слухам и утечкам, он будет состоять из двух кристаллов M5 Max, соединённых всё тем же UltraFusion. Главное изменение — архитектурное: сообщается, что Apple перейдёт к дизайну с раздельными блоками CPU и GPU. Это позволит кастомизировать чипы под задачи: мощный CPU при среднем GPU для научных расчётов или вариант с 80 GPU-ядрами для ИИ.
Ожидаемые характеристики:
- CPU: до 40 ядер;
- GPU: до 128–160 ядер;
- NPU: заметно улучшенный Neural Engine, встроенный в каждое ядро GPU;
- память: возможно увеличение максимального объёма до 1 ТБ.
Если ожидания оправдаются, M5 Ultra сотрёт грань между персональным компьютером и суперкомпьютером для автономных ИИ-систем.
Выводы и практические рекомендации
Mac прошёл путь от нишевого инструмента креативных профессионалов до полноценной платформы для задач ИИ. Её основа — архитектура Apple Silicon с унифицированной памятью, встроенные нейроускорители и программный стек с фреймворком MLX. Больше не обязательно арендовать дорогие облачные кластеры или собирать шумные и прожорливые рабочие станции: всё это умещается в компактный, тихий и энергоэффективный корпус. Для обучения гигантских моделей с нуля Mac по-прежнему не основной инструмент, но для инференса, тонкой настройки и развёртывания ИИ-агентов он предлагает редкое сочетание доступности, производительности и удобства.
Как выбирать на практике:
- нужны модели до 13–20B, прототипы и LoRA — достаточно Mac mini;
- нужны модели 70B и выше или DeepSeek масштаба 670B — берите Mac Studio с M3 Ultra и максимальным объёмом памяти;
- нужны PCIe-карты и расширение — смотрите в сторону Mac Pro.
Если же ваши задачи упираются в обучение моделей, CUDA-стек, многопользовательский доступ или промышленную нагрузку, правильным выбором останутся серверы с GPU. Подобрать конфигурацию под задачу поможет команда «СервакМастер»: посмотрите каталог серверов и ИИ-серверы или свяжитесь с нами.