
Компактная модель против гигантов
Распознавание текста в документах долго развивалось по двум расходящимся путям. С одной стороны — лёгкие локальные библиотеки, быстрые, но спотыкающиеся на сложных макетах. С другой — огромные мультимодальные модели, точные, но требующие серьёзной инфраструктуры и денег за каждый обработанный документ.
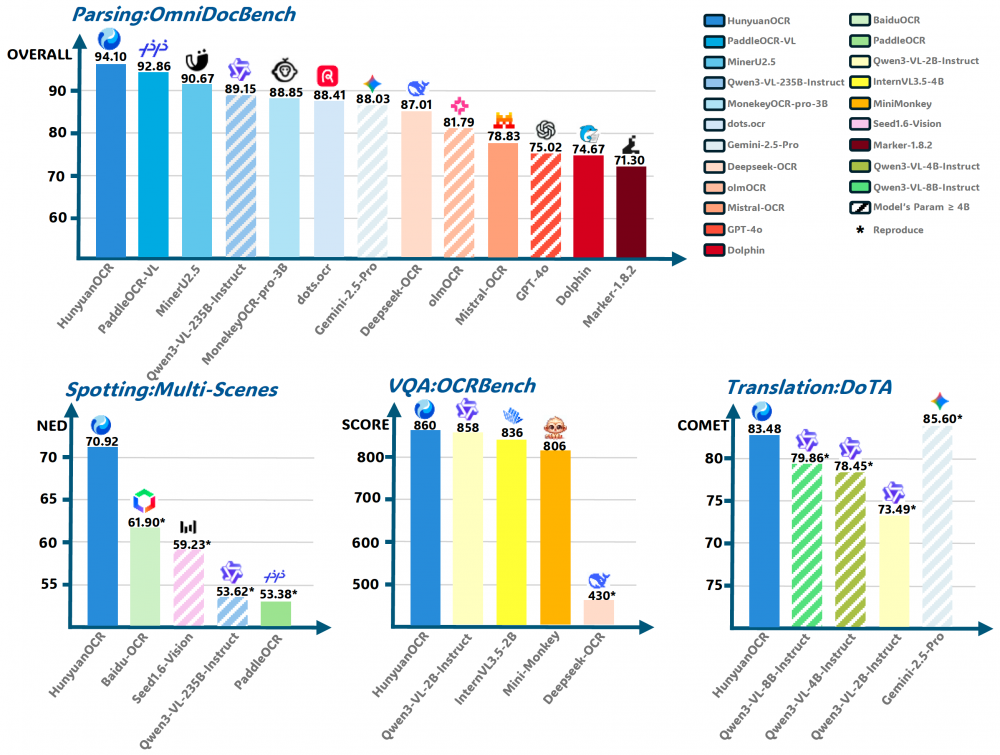
Tencent выпустила HunyuanOCR — попытку занять место посередине. Модель содержит всего 1 миллиард параметров, но по заявленным результатам обходит системы, превосходящие её по масштабу на два порядка.
Разберём, за счёт чего это достигается и что нужно, чтобы её запустить.
Каскад против сквозной обработки
Ключевое отличие — в самом принципе работы.
Классическая схема пропускает документ через цепочку независимых модулей: сначала детектор находит области с текстом, затем классификатор определяет их тип, потом транскрибер распознаёт символы, и в конце постпроцессор собирает результат.
Проблема такой конструкции в накоплении ошибок. Каждый переход между модулями добавляет задержку, а неточность на раннем этапе тянется дальше и усугубляется: неверно определённая граница блока приводит к неверному распознаванию, которое постпроцессор уже не исправит.
Сквозной подход в HunyuanOCR устроен иначе. Изображение поступает сразу в мультимодальный энкодер, который одновременно обрабатывает визуальные признаки и текстовые закономерности. Декодер формирует ответ в соответствии с инструкцией — за один проход, без промежуточных стадий.
Промежуточных этапов нет — значит, нет и мест, где ошибки накапливаются. Плюс заметно ниже задержка на сложных документах.
Что показали тесты
По данным, опубликованным Tencent, модель превосходит на задачах распознавания документов:
- PaddleOCR-VL — распространённую открытую библиотеку от Baidu;
- Qwen3-VL-235b — мультимодальную модель Alibaba на 235 миллиардов параметров;
- Gemini 2.5 Pro — флагманскую мультимодальную модель Google;
- DeepSeek-OCR — специализированный компонент от одноимённого разработчика.
Превосходство модели на 1 миллиард параметров над системой на 235 миллиардов выглядит контринтуитивно, но объяснимо: специализация. Универсальная мультимодальная модель умеет многое, а HunyuanOCR обучалась делать одно, но хорошо.
Оговорка, которую стоит держать в голове: сравнение проводилось именно на задачах распознавания документов, а не на общих языковых тестах. Переносить этот результат на другие сценарии нельзя, и разработчики этого не заявляют.
Что модель умеет
Функциональный охват шире, чем у типовых OCR-инструментов:
- Распознавание и транскрипция текста — базовая задача с высокой точностью;
- Разбор структуры документа — таблицы, формы, вложенные блоки, нестандартные макеты;
- Извлечение данных по запросу — можно попросить достать конкретные поля, а не весь текст подряд;
- Работа с субтитрами — извлечение текста прямо из видеоматериалов;
- Перевод с изображений — распознавание и перевод в одном проходе;
- Оценка качества документа — автоматическая проверка читаемости и корректности структуры.
Практический смысл в том, что вместо связки из нескольких инструментов используется один интерфейс. Задача формулируется словами, модель возвращает готовый результат — не нужно оркестрировать несколько сервисов и склеивать их выводы.
Многоязычность
Поддерживается более 100 языков, причём модель корректно обрабатывает документы, где несколько языков или систем письма соседствуют в одном файле.
Это не абстрактное преимущество. Смешанные документы — обычное дело в реальном документообороте:
- таможенные декларации и товаросопроводительные документы;
- платформы с пользовательским контентом из разных стран;
- архивы иностранных изданий и переписки;
- техническая документация с оригинальными терминами.
Каскадные системы на таких документах часто сбоят именно на переключении между языками.
Что нужно для запуска
Tencent указывает следующую конфигурацию:
| Компонент | Требование |
|---|---|
| Операционная система | Linux |
| Python | 3.12 и выше |
| CUDA | 12.8 |
| PyTorch | 2.7.1 |
| Рекомендованный ускоритель | NVIDIA H100 80 ГБ |
| Место на диске | около 6 ГБ |
Здесь есть любопытное противоречие, на которое стоит обратить внимание. Модель компактная — 6 ГБ на диске, — но рекомендованный ускоритель серьёзный.
Объясняется это не размером модели, а производительностью: указанная конфигурация обеспечивает обработку крупных пакетов документов и сложных макетов без задержек. Запустить модель можно и на менее мощном оборудовании — она поместится, — но пропускная способность будет заметно ниже.
Практический вывод: если объём обработки небольшой, требования можно снизить. Ориентироваться на рекомендованную конфигурацию нужно тем, кто планирует поток документов, а не эпизодическое распознавание.
Кому это интересно
Компаниям с большим документооборотом. Обработка входящих счетов, накладных, договоров, анкет. Собственное решение вместо оплаты за каждую страницу в облачном сервисе.
Организациям с требованиями к данным. Документы не покидают контур — существенный аргумент там, где обрабатываются персональные или коммерческие данные.
Разработчикам продуктов. Компактность модели позволяет встраивать её в существующие системы без разворачивания отдельной тяжёлой инфраструктуры.
Основной порог входа — не сама модель, а ускоритель для производственной нагрузки. Считать экономику стоит от объёма: при небольших потоках облачный сервис может оказаться дешевле, при постоянной обработке собственное решение окупается.
Итог
HunyuanOCR показывает, что в специализированных задачах архитектура и качество обучения важнее количества параметров. Сквозная обработка вместо каскада модулей убирает накопление ошибок и снижает задержку, а компактность упрощает встраивание.
Для бизнеса, выстраивающего обработку документов, это прежде всего экономическая альтернатива облачным сервисам с оплатой за страницу. Вопрос лишь в том, окупается ли ускоритель на вашем объёме.
Планируете развернуть распознавание документов на своём оборудовании — опишите объём и тип документов, поможем рассчитать нужную конфигурацию.