
Дорожная карта важнее отдельного анонса
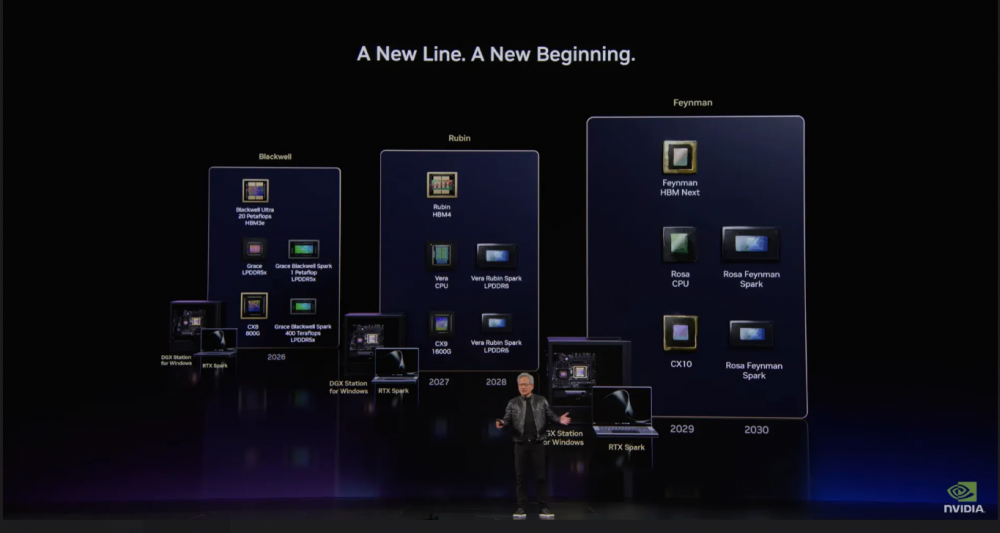
На Computex 2026 NVIDIA сделала нечто более значимое, чем представление очередного чипа: публично зафиксировала план развития платформы RTX Spark на три поколения вперёд.
Для рынка это существенно. Никто не хочет вкладываться в платформу, судьба которой неясна: писать под неё софт, обучать людей, закупать оборудование. Публичные обязательства на несколько лет снимают главный риск ранних инвестиций.
Путь расписан так: Grace Blackwell Spark → Vera Rubin → Rosa Feynman. Каждое поколение получает новый кристалл, более быструю память и более современный техпроцесс.
Первое поколение: Grace Blackwell Spark
Наиболее проработанное звено, выход намечен на конец 2026 года:
- Процессор Grace — 20 ядер на архитектуре Arm
- Графика Blackwell уровня RTX 5070
- До 128 ГБ унифицированной памяти LPDDR5X с пропускной способностью 600 ГБ/с
- Техпроцесс 3 нм
Ключевое здесь — слово «унифицированной». Процессор и графика используют общий пул памяти, а не каждый свой. Между ними нет шины PCIe, через которую в классической схеме приходится перегонять данные.
Для ИИ-нагрузок это принципиально. При работе языковой модели данные постоянно ходят между вычислительными блоками, и в обычной архитектуре именно этот обмен часто становится узким местом — не мощность GPU и не скорость процессора, а пересылка между ними.
Второе поколение: Vera Rubin
Следующий шаг приносит три изменения:
- Переход с LPDDR5X на LPDDR6 — выше пропускная способность при меньшем энергопотреблении
- Обновлённая архитектура графики Rubin с лучшей производительностью на ватт
- Вероятный переход на 2 нм — дополнительный выигрыш по тепловыделению
Смена типа памяти здесь важнее смены графики, и вот почему. При генерации текста языковой моделью скорость определяется тем, как быстро веса модели проходят через шину памяти — каждый новый токен требует их прочитать. Вычислительная мощность при этом часто недозагружена.
То есть для основного сценария использования таких устройств рост пропускной способности памяти даёт больше, чем рост мощности графики.
Третье поколение: Rosa Feynman
Завершает опубликованный план:
- Память LPDDR6X — предположительно с более высокими частотами относительно базовой LPDDR6
- Следующее поколение графической архитектуры
- Дальнейшее развитие поддержки Windows на Arm
Конкретные даты и финальные характеристики не публиковались. Но само включение платформы в официальный план — сигнал, достаточный для долгосрочного планирования закупок.
Программная экосистема как главный аргумент
На презентации отдельно подчёркивалось: преимущество платформы не только в кремнии, но и в накопленной за полтора десятилетия программной базе.
Что это означает практически:
- Готовые библиотеки и инструменты — накопленный экосистемный задел, которого нет у конкурирующих архитектур;
- Оптимизированные модели из открытого доступа, работающие без ручной доводки;
- Перенос нагрузок из дата-центра на локальное устройство без изменения кода — те же инструменты, те же форматы, те же модели.
Последний пункт — самый весомый. Разработчик, использующий эту экосистему на серверах, может запускать те же конвейеры на настольном устройстве, ничего не переписывая. Порог входа минимальный, и это существенно снижает риск для тех, кто рассматривает переход.
Тот же подход в другом масштабе
Параллельно развивается линейка рабочих станций на той же архитектуре. Флагманская конфигурация уже сегодня предлагает:
- 72-ядерный процессор Grace
- 496 ГБ унифицированной памяти LPDDR5X
- Графику Blackwell Ultra с 252 ГБ памяти HBM3E
Смысл в единстве архитектуры: от компактного устройства до настольного суперкомпьютера — один программный стек, одни инструменты, одни модели. Масштаб разный, код тот же.
Для организации это означает возможность разрабатывать на компактной машине и разворачивать на мощной, не тратя время на перенос.
Что это даёт на практике
Опубликованный план на три поколения снимает основные риски раннего внедрения:
- Преемственность приложений — написанное под первое поколение работает на последующих без переработки;
- Предсказуемый рост — каждое поколение ускоряет память и улучшает энергоэффективность;
- Единый инструментарий на всех поколениях;
- Публичные обязательства вместо разового анонса.
Итог
NVIDIA последовательно строит альтернативу классической связке «x86-процессор плюс дискретная видеокарта». Монолитные Arm-чипы с общей памятью для процессора и графики закрывают всё больший круг задач локального инференса — от персональных устройств до рабочих станций.
Главный технический аргумент — унифицированная память: она убирает узкое место в виде обмена данными между процессором и графикой, что для ИИ-нагрузок значит больше, чем прирост чистой вычислительной мощности.
Главный стратегический аргумент — программная экосистема и публично зафиксированный план развития. Именно это, а не характеристики отдельного чипа, определяет, будут ли под платформу писать софт.
Планируете инфраструктуру под локальный инференс — опишите задачу, поможем сопоставить варианты и подобрать оборудование.